Rimay Quantum Feature Extraction - una Qiskit Function di Kipu Quantum
Consulta il riferimento API.
Qiskit Functions sono una funzionalità sperimentale disponibile solo per gli utenti dei piani IBM Quantum® Premium Plan, Flex Plan e On-Prem (tramite IBM Quantum Platform API). Sono in versione preliminare (preview) e soggette a modifiche.
Panoramica
Rimay potenzia le pipeline di machine learning classico con feature generate su hardware quantistico. La funzione prende dati tabulari classici e restituisce un insieme di feature trasformate quantisticamente. Quando un sistema quantistico elabora i dati, genera feature ricche che catturano le relazioni non lineari tra gli input. Puoi usare le feature generate da sole, oppure combinate con le tue feature originali, per addestrare qualsiasi modello classico. Su dataset di piccole e medie dimensioni, le feature trasformate quantisticamente possono migliorare la qualità della previsione rispetto a baseline puramente classiche.
Questa funzione è pensata per i seguenti utenti:
-
Team di data science con una pipeline di machine learning esistente su dataset tabulari di piccole e medie dimensioni, in cui la qualità della previsione ha raggiunto un plateau. Aggiungi Rimay come un ulteriore passaggio di pre-elaborazione, senza costruire personalmente alcun circuito quantistico.
-
Ricercatori che esplorano metodi quantistici per attività di machine learning.
Descrizione
L'algoritmo di estrazione quantistica delle feature [1] combina due principi del machine learning quantistico. Il primo sono le mappe di feature quantistiche, che incorporano i dati in uno spazio di Hilbert ad alta dimensione e producono quindi rappresentazioni più espressive. Il secondo è il reservoir computing quantistico, che usa la dinamica di un sistema quantistico a molti corpi come trasformazione non lineare dell'input.
Rimay codifica i valori delle feature e l'informazione mutua tra le feature nei campi locali e nei coefficienti di accoppiamento di un Hamiltoniano di vetro di spin. Una dinamica quantistica controdiabatica fa evolvere il sistema verso i suoi stati a bassa energia, che contengono miscele non lineari delle correlazioni nei dati di input. Rimay estrae queste correlazioni misurando valori di aspettazione a uno e due corpi. I valori di aspettazione sono le feature trasformate quantisticamente che fornisci al tuo modello di machine learning.
Flusso di lavoro
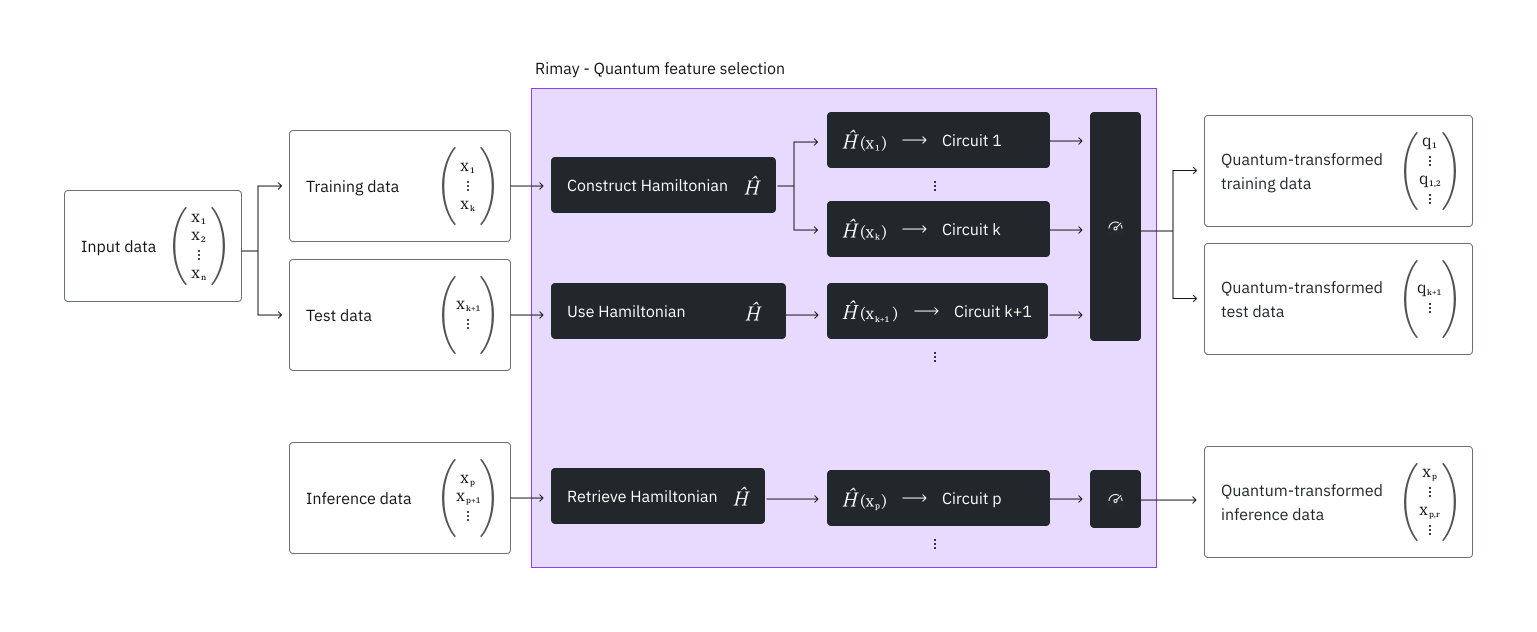
-
Pre-elabora i tuoi dati tabulari come faresti per il machine learning classico. Rimay richiede feature numeriche, quindi converti le feature categoriche in feature numeriche, ad esempio con l'
OneHotEncoderdi scikit-learn. -
Dividi i dati in un insieme di addestramento e un insieme di test e carica entrambi nella funzione, come mostrato nella sezione Esempio.
-
Rimay usa i dati di addestramento per costruire l'Hamiltoniano che rappresenta i dati. Ogni feature corrisponde a un qubit e l'intero insieme di addestramento decide quali feature, e quindi quali qubit, interagiscono. Rimay memorizza questa struttura in modo da mappare i dati di test e i dati di inferenza successivi con lo stesso Hamiltoniano.
-
Per ogni campione, i valori delle feature impostano i campi locali dell'Hamiltoniana, e l'informazione mutua tra le feature imposta i coefficienti di accoppiamento della struttura del passo 3. Rimay digitalizza l'evoluzione controdiabatica di questa Hamiltoniana in un circuito ed esegue i circuiti sulla QPU.
-
Rimay misura le bitstring risultanti, poi calcola i valori di aspettazione a un corpo e i valori di aspettazione a due corpi dei qubit accoppiati fisicamente.
-
Scarichi i valori di aspettazione in una forma che puoi fornire direttamente al tuo modello oppure combinare con le feature originali.
A causa di questa struttura, il numero di qubit di cui un'esecuzione ha bisogno è pari al numero di feature, e il numero di circuiti che invia è pari al numero di campioni.
Dopo aver adattato una mappatura, puoi mappare nuovi dati attraverso di essa, ad esempio per l'inferenza. Rimay recupera quindi l'Hamiltoniana che ha creato durante l'adattamento e costruisce da essa i circuiti per i nuovi campioni.
Integra Rimay nella tua pipeline di machine learning
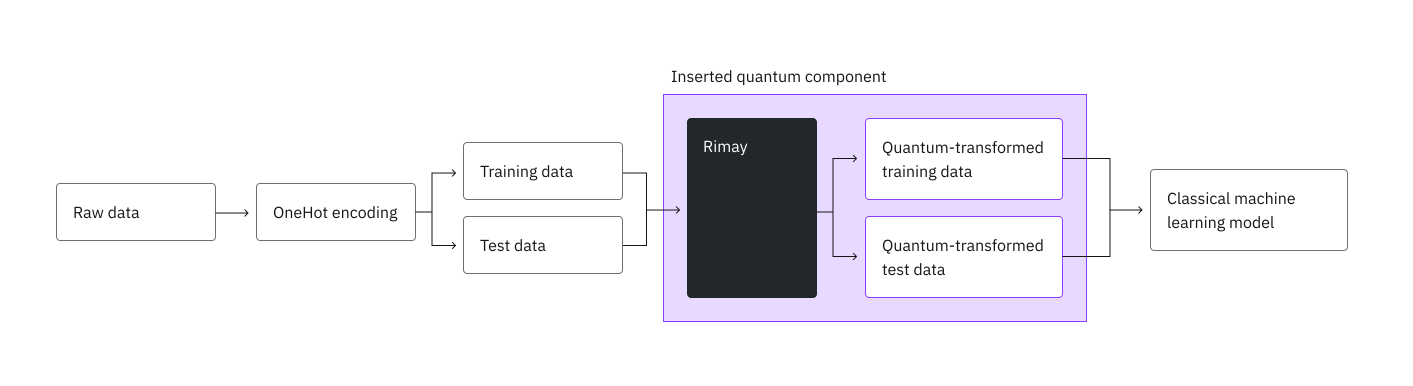
Come in una pipeline classica, inizi preelaborando i dati grezzi, ad esempio con la codifica one-hot delle feature categoriche, e li dividi in un insieme di addestramento e un insieme di test. Invece di fornire direttamente entrambi gli insiemi al tuo modello, li fornisci prima a Rimay e addestri il tuo modello sulle feature trasformate quantisticamente.
Benchmark
Kipu Quantum ha eseguito il benchmark di Rimay sul dataset German credit di OpenML [2], che classifica 1000 richiedenti di credito come buoni o cattivi rischi di credito. Ha 13 attributi categorici e sette numerici. La codifica one-hot degli attributi categorici produce 48 feature numeriche. Il benchmark tiene da parte il 20% dei campioni come insieme di test.
Come riferimento, sono stati addestrati diversi modelli classici sulle feature classiche. Con Rimay, una random forest è stata addestrata in due modi: solo sulle feature trasformate quantisticamente (Random forest Q) e sulle feature trasformate quantisticamente combinate con quelle classiche (Random forest H, per ibrido). La tabella riporta solo la random forest, perché ha ottenuto i risultati migliori sulle feature trasformate quantisticamente.
| Modello | Feature | Accuratezza | AUC | F1 score | Precisione | Recall |
|---|---|---|---|---|---|---|
| CatBoost | Classiche | 0.775 | 0.781 | 0.850 | 0.795 | 0.914 |
| Random forest | Classiche | 0.765 | 0.781 | 0.846 | 0.782 | 0.921 |
| XGBoost | Classiche | 0.760 | 0.758 | 0.835 | 0.803 | 0.871 |
| LightGBM | Classiche | 0.770 | 0.751 | 0.840 | 0.818 | 0.864 |
| Random forest Q | Quantistiche | 0.750 | 0.793 | 0.840 | 0.762 | 0.936 |
| Random forest H | Ibride | 0.770 | 0.798 | 0.854 | 0.770 | 0.957 |
Le feature ibride migliorano tutte le metriche della random forest tranne la precisione, e la random forest ibrida raggiunge AUC, F1 score e recall più alti di CatBoost sulle feature classiche. L'effetto maggiore si ha sul recall, che sale da 0.921 a 0.957. Le sole feature trasformate quantisticamente non raggiungono la precisione dei modelli classici.
L'insieme di test contiene solo 200 campioni, quindi prevedere correttamente un campione in più sposta l'accuratezza di 0.005. Leggi le differenze come una tendenza che richiede ulteriori verifiche, non come un effetto significativo. L'accuratezza della previsione può inoltre dipendere dal rumore indotto dall'hardware nelle feature estratte. Pertanto, usa un numero di shot sufficiente affinché il rumore di shot non limiti il risultato.
Il benchmark ha usato le seguenti risorse:
| Esempio | Numero di qubit | Numero di campioni | Numero di shot | Tempo totale (min) | Utilizzo QPU (min) | Processore |
|---|---|---|---|---|---|---|
| German credit | 48 | 1000 | 5000 | 23 | 22 | ibm_boston |
| German credit | 48 | 1000 | 5000 | 3 | 2 | ibm_phoenix |
Il numero di campioni, che è il numero di circuiti, determina il tempo QPU. Usa il tipo di processore Nighthawk r2, perché riduce notevolmente il tempo QPU richiesto.
Input
mode determina quali parametri servono a un'esecuzione. Per una descrizione di ogni parametro di input, consulta il riferimento API.
File di input
-
Carica ogni file con
catalog.file_upload()prima di eseguire la funzione. -
Un caricamento sostituisce qualsiasi file precedente con lo stesso nome, anche per un job che hai inviato ma che non è ancora iniziato. Per eseguire più job contemporaneamente, dai ai file di ogni job nomi propri, ad esempio
run1_x_train.csverun2_x_train.csv. -
Ogni file è un file CSV con una riga di intestazione. Ogni colonna di un file di feature è una feature e ogni valore deve essere numerico.
-
y_traincontiene esattamente una colonna numerica, con un'etichetta per ogni riga dix_train. Mappa le etichette categoriche in numeri, ad esempio good e bad in 1 e 0. -
x_testex_inferencedevono avere le stesse colonne dix_train, nello stesso ordine.
Il mapping_id è l'unico modo per raggiungere la mappatura prodotta dal tuo adattamento e non può essere cercato né recuperato. Autorizza l'uso di quella mappatura, quindi trattalo come una credenziale e non condividerlo. Se lo perdi, devi adattare una nuova mappatura, il che costa un'altra esecuzione su hardware quantistico. Registra anche il backend_name dell'adattamento, perché la mappatura funziona solo su quel processore.
Limiti
-
Ogni feature è mappata su un qubit, quindi il processore deve avere almeno tanti qubit quante sono le feature dei tuoi dati. Se hai più feature di così, riducile prima con una tecnica di selezione delle feature.
-
Ogni campione diventa un circuito e un'esecuzione conta insieme i campioni di addestramento e di test. Un'esecuzione può contenere al massimo 15.000 campioni.
-
Un singolo job può richiedere al massimo 10 milioni di esecuzioni, quindi il numero di campioni per
shotsnon deve superare 10 milioni. -
Un job deve terminare entro 24 ore, incluso il tempo in cui i suoi circuiti attendono nella coda del processore. Un job che dura di più viene interrotto senza risultato. Su un processore molto occupato, mantieni i dataset di grandi dimensioni ben al di sotto di questi limiti.
Output
job.result() restituisce un dizionario. Le feature trasformate quantisticamente vengono scritte in file CSV che scarichi con catalog.file_download(). Per una descrizione di ogni chiave del dizionario, consulta il riferimento API. Per il tempo impiegato da ogni fase di esecuzione, consulta Metadati di esecuzione.
Ogni file di output contiene una riga per ogni riga di input, nell'ordine del file di input, e una colonna per ogni feature trasformata quantisticamente. Le colonne i cui nomi iniziano con corr_ sono i valori di aspettazione a due corpi. I file non contengono una colonna di etichette. Le etichette dei tuoi dati di addestramento restano nel tuo file y_train.
Metadati di esecuzione
resource_usage contiene una voce per ogni fase di esecuzione attraversata dall'esecuzione: "RUNNING: MAPPING", "RUNNING: POST_PROCESSING" e, su una QPU, di solito "RUNNING: WAITING_FOR_QPU". Ogni voce contiene CPU_TIME, il tempo reale della fase in secondi, e QPU_TIME, il tempo QPU in secondi. Su una QPU, il tempo QPU fatturato da IBM è registrato sotto "RUNNING: MAPPING", la fase in cui i circuiti sono stati eseguiti.
"RUNNING: WAITING_FOR_QPU" è il tempo in cui i tuoi job hanno atteso nella coda IBM. L'esecuzione ricava questo tempo dai timestamp dei job IBM e non lo conteggia in "RUNNING: MAPPING". Se IBM non fornisce quei timestamp per ogni job, la voce è assente e l'attesa fa parte di "RUNNING: MAPPING".
IBM® termina il calcolo dell'utilizzo qualche tempo dopo la fine di un job. L'esecuzione attende fino a circa un minuto. L'utilizzo ancora in calcolo dopo quel tempo non è incluso in QPU_TIME e l'utilizzo finale viene mostrato su IBM Quantum Platform. Se l'esecuzione non riesce a leggere l'utilizzo da IBM, QPU_TIME è None.
Ad esempio:
"metadata": {
    "version": "0.3.0",
    "resource_usage": {
        "RUNNING: MAPPING": {"CPU_TIME": 12.4, "QPU_TIME": 6.0},
        "RUNNING: WAITING_FOR_QPU": {"CPU_TIME": 28.8, "QPU_TIME": 0.0},
        "RUNNING: POST_PROCESSING": {"CPU_TIME": 0.3, "QPU_TIME": 0.0},
    },
}
Per iniziare
Autenticati usando la tua chiave API di IBM Quantum Platform e seleziona la Qiskit Function come segue:
Il codice seguente presuppone che tu abbia salvato le tue credenziali. In caso contrario, segui le istruzioni in Installa il client di Qiskit Functions Catalog per salvare il tuo account con la tua chiave API.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# Verify that you have access to the function
catalog.list()
[QiskitFunction(kipu-quantum/rimay)]
# Access function
rimay = catalog.load("kipu-quantum/rimay")
Dimensioni della funzione
Ogni job viene eseguito con una dimensione — S, M o L. Se la dimensione specificata è troppo piccola, il job viene rifiutato. Se la dimensione è maggiore del necessario, il job viene eseguito su un profilo di calcolo più grande di quanto il lavoro richieda.
La dimensione di un job Rimay dipende dal numero di campioni che mappa: le righe di x_train e x_test per fit-transform e le righe di x_inference per transform. Le etichette in y_train non contano e un'esecuzione delete non mappa alcun campione.
| Dimensione | Campioni per job | Profilo di calcolo | vCPU | RAM |
|---|---|---|---|---|
S | Fino a 2.999 | 8x32 | 8 | 32 GB |
M | Da 3.000 a 9.999 | 8x32 | 8 | 32 GB |
L | Da 10.000 a 15.000 | 16x128 | 16 | 128 GB |
Il numero di campioni è l'unico criterio. Una dimensione non cambia altro che il profilo di calcolo: i limiti su feature, campioni e shot sono gli stessi per ogni dimensione. S e M vengono eseguiti sullo stesso profilo di calcolo e differiscono per il numero di campioni che ciascuna copre.
Il valore predefinito è M, usato quando un job non richiede una dimensione. Un job con più di 9.999 campioni deve quindi richiedere L.
Puoi anche leggere la mappatura dalla funzione stessa con rimay.sizes_map e la dimensione con cui viene eseguito un job che non ne richiede una con rimay.default_size.
Calcola la dimensione prima dell'invio
Eseguilo sui tuoi input. Li legge e nient'altro: non viene inviato alcun job e non viene riservato nulla, quindi puoi chiamarlo quante volte vuoi.
Passa i dataset stessi, non i loro nomi di file, nello stesso ordine di input_file, insieme al mode dell'esecuzione. Il passo 2 dell'esempio mostra la chiamata.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Se la dimensione è troppo piccola, il job fallisce con l'errore 4600 e il messaggio indica la dimensione da usare. Se è maggiore del necessario, il job viene eseguito normalmente e registra un evento di avviso 4601.
Esempio
Questo esempio mostra come caricare i dati, eseguire la funzione e recuperare le feature trasformate quantisticamente. Per un esempio end-to-end che include la preelaborazione e l'addestramento del modello classico, consulta il tutorial.
1. Carica i dati
Questo esempio usa un piccolo dataset sintetico con quattro feature numeriche e un'etichetta binaria, in modo che un'esecuzione richieda solo quattro qubit e termini rapidamente. La cella successiva lo scrive in quattro file CSV: le feature di addestramento, le etichette di addestramento, le feature di test e le feature per il passo 4 di questo esempio. Per usare i tuoi dati, scrivi invece i tuoi insiemi di addestramento e di test preelaborati in file con lo stesso formato.
from pathlib import Path

Path("x_train.csv").write_text("""f0,f1,f2,f3
0.7227,1.3355,1.9595,2.5562
0.2731,0.5779,0.8983,1.1624
0.1139,0.1817,0.2163,0.2426
0.0341,0.1311,0.0854,0.09
0.8996,1.6951,2.497,3.3407
0.9669,1.8906,2.7705,3.6569
0.6366,1.2821,1.8793,2.4602
0.7718,1.4979,2.2223,2.933
0.5465,1.1008,1.67,2.2195
0.9475,1.9423,2.8942,3.8199
0.8829,1.6842,2.4703,3.2865
0.0675,0.0365,0.0705,0.0162
""")
Path("y_train.csv").write_text("label\n1\n0\n0\n0\n1\n1\n0\n1\n0\n1\n1\n0\n")
Path("x_test.csv").write_text("""f0,f1,f2,f3
0.543,1.0786,1.5684,2.0607
0.9928,1.9037,2.9302,3.8422
0.2269,0.3637,0.4628,0.597
0.9896,1.9511,2.8913,3.8208
""")
Path("x_inference.csv").write_text("""f0,f1,f2,f3
0.2708,0.542,0.8506,1.0897
0.3585,0.6025,0.9517,1.2609
0.8871,1.6559,2.4577,3.2992
""")
95
Carica i file di addestramento e di test. Caricherai x_inference.csv nel passo 4.
for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
2. Esegui la funzione
Calcola la dimensione dell'esecuzione dai dati che hai caricato, con il calcolatore di Dimensioni della funzione.
import pandas as pd

x_train = pd.read_csv("x_train.csv")
y_train = pd.read_csv("y_train.csv")
x_test = pd.read_csv("x_test.csv")

size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Seleziona un processore con almeno tanti qubit quante sono le feature dei tuoi dati ed esegui la funzione in modalità fit-transform con quella dimensione. I dati di esempio hanno quattro feature, quindi qualsiasi processore IBM Quantum può eseguirla.
backend = catalog.least_busy(operational=True, simulator=False)

job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv", "x_test.csv"],
    backend_name=backend.name,
    shots=5000,
    function_size=size,
)
print(job.job_id)
85dabc9f-a769-4f4a-8e92-f3be73f85ca2
Controlla lo stato del workload o restituisci i risultati come segue:
# Monitor the job status
job.status()
'DONE'
result = job.result()

# Keep both: the mapping_id is the only handle on the mapping this run
# fitted, and the mapping runs only on the processor it was fitted on.
mapping_id = result["mapping_id"]
fit_backend_name = result["backend_name"]
3. Recupera i risultati
Scarica le feature trasformate quantisticamente. Passa target_name in modo che ogni file venga salvato con il proprio nome.
for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
693iB [00:00, 171kiB/s]
254iB [00:00, 111kiB/s]
4. Mappa nuovi dati
Dopo aver addestrato il tuo modello, mappa nuovi dati con la mappatura adattata, ad esempio per eseguire l'inferenza. Questo esempio mappa x_inference.csv, che la prima cella di questo esempio ha scritto. Passa il mapping_id restituito dall'adattamento, in modo che le nuove righe vengano mappate con la stessa mappatura invece che con una nuova.
Una mappatura è costruita per il layout dei qubit di un processore, quindi passa lo stesso backend_name dell'adattamento, che l'adattamento ha restituito in result["backend_name"]. Non usare least_busy() per scegliere il processore, perché potrebbe restituirne uno diverso. Rimay rifiuta qualsiasi altro processore prima di inviare qualsiasi cosa. Anche il numero di shot proviene dall'adattamento.
catalog.file_upload("x_inference.csv", rimay)

x_inference = pd.read_csv("x_inference.csv")
size = calculate_function_size([x_inference], mode="transform")

job = rimay.run(
    mode="transform",
    input_file=["x_inference.csv"],
    # The processor the mapping was fitted on
    backend_name=fit_backend_name,
    shots=5000,
    mapping_id=mapping_id,
    function_size=size,
)
# Monitor the job status
job.status()
'DONE'
result = job.result()

for file_name in result["output_files"]:
    catalog.file_download(file_name, rimay, target_name=file_name)
202iB [00:00, 73.5kiB/s]
5. Elimina una mappatura
Quando non hai più bisogno di una mappatura adattata, eliminala. Un'esecuzione delete non esegue alcun lavoro quantistico, quindi non richiede processore, shot né dimensione della funzione. Non puoi annullare un'eliminazione. Dopo l'eliminazione, il mapping_id non si riferisce più a nulla e un'esecuzione transform con esso fallisce.
job = rimay.run(mode="delete", mapping_id=mapping_id)
job.result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': '30L40joyUPYfnvgwo2d7MXXSzqvHkggR-Kzn81wfIYw',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Recupera i messaggi di errore
Se lo stato del tuo workload è ERROR, usa job.error_message() per recuperare il messaggio di errore, come segue:
job = rimay.run(
    mode="fit-transform",
    input_file=["x_train.csv", "y_train.csv"],
    backend_name=backend.name,
    shots=0,
)
job.error_message()
Ogni errore segnalato da Rimay riporta un codice dei codici di errore IBM Quantum, un messaggio e una soluzione che indica il valore che hai passato e il valore consentito. La tabella seguente elenca gli errori più comuni:
| Codice | Causa |
|---|---|
1221 | Manca un parametro o ha il tipo sbagliato, mode non è valido, un file indicato in input_file non è stato caricato, i file non corrispondono tra loro, una feature non è numerica oppure il mapping_id non corrisponde a una mappatura memorizzata. |
1221 | Un'esecuzione "transform" indica un backend_name diverso da quello dell'adattamento che ha prodotto la sua mappatura. |
1216 | La tua istanza non ha alcun processore con il backend_name che hai passato. La soluzione elenca i processori disponibili. |
1200 | La tua chiave API non ha accesso all'istanza con cui viene eseguito il job. |
3200 | backend_name non inizia con ibm_. |
4500 | I dati hanno più feature di quanti qubit abbia il processore. |
6000 | Il numero di campioni per shots supera 10 milioni di esecuzioni. |
6001 | shots è minore di 1. |
6002 | I dati hanno più campioni di quanti ne consenta un'esecuzione. |
Casi d'uso
Nella classificazione tabellare su dataset di piccole e medie dimensioni, Kipu Quantum ha applicato l'estrazione quantistica di feature a quanto segue:
Oltre ai dati tabellari, le reti neurali congelate possono trasformare le immagini in feature numeriche, che l'estrazione quantistica di feature mappa poi in feature trasformate quantisticamente:
Ottenere supporto
Per assistenza, contatta support@kipu-quantum.com.
Passi successivi
-
Visita il riferimento API per questa Qiskit Function.
-
Prova il tutorial Classify credit risk with Kipu Quantum's Rimay quantum feature extraction.
Riferimenti
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.
Informazioni aggiuntive
Rimay è una parola quechua che significa "spiegare".