Parity Twine Optimizer: una funzione Qiskit di ParityQC
Consulta il riferimento API
Le Qiskit Functions sono una funzionalità sperimentale disponibile solo per gli utenti IBM Quantum® con piano Premium, piano Flex e piano On-Prem (tramite IBM Quantum Platform API). Sono in stato di rilascio in anteprima e soggette a modifiche.
Panoramica
Il Parity Twine Optimizer consente agli utenti di risolvere problemi di ottimizzazione con computer quantistici utilizzando il metodo Parity Twine. Questo approccio, basato sulla Parity Architecture, utilizza il compilatore ParityQC per ridurre al minimo il numero di gate e la profondità del circuito necessari per eseguire un algoritmo quantistico, tenendo conto della connettività del dispositivo.
Questa riduzione delle risorse consente di risolvere problemi di ottimizzazione rilevanti per l'industria con dimensioni non fattibili con i metodi di transpilazione standard, ricchi di gate SWAP. Il Parity Twine Optimizer automatizza le fasi di transpilazione e può essere utilizzato con un intervento minimo da parte dell'utente.
L'approccio Parity Twine supera tutti gli altri metodi di compilazione in termini di riduzione del numero di gate e della profondità dei circuiti per algoritmi quantistici come il quantum approximate optimization algorithm (QAOA) e la trasformata di Fourier quantistica (QFT). Astraendo l'informazione quantistica dai qubit fisici, le interazioni non locali vengono implementate senza gate SWAP. Le catene Parity Twine (sequenze di gate CNOT) distribuiscono invece sistematicamente l'informazione di parità logica tra i qubit.
L'ottimizzatore utilizza il QAOA per minimizzare l'energia di una data funzione di costo. Il QAOA è un algoritmo variazionale ibrido quantistico-classico progettato per risolvere problemi di ottimizzazione combinatoria approssimando lo stato fondamentale di un'Hamiltoniana di costo (). Un termine di mixing () guida le transizioni tra gli stati per esplorare lo spazio delle soluzioni. Una sequenza alternata di questi termini, controllata dai parametri e , definisce l'unitario , che agisce sullo stato iniziale.
La codifica dell'unitario del problema, exp(), richiede la codifica di tutti gli operatori di rotazione logici a corpi (exp()). Questo può essere ottenuto utilizzando generatori a corpi (Parity Twine Networks), che riducono la profondità del circuito QAOA e il numero di gate a due qubit.
Descrizione
L'input del Parity Twine Optimizer consiste in un problema di ottimizzazione, il nome dell'hardware IBM Quantum scelto e ulteriori argomenti opzionali per personalizzare le impostazioni di transpilazione ed esecuzione sull'hardware. La funzione di ottimizzazione instrada la definizione del problema al Parity Twine Compiler. La Figura 1 mostra un riepilogo del flusso di lavoro della funzione.
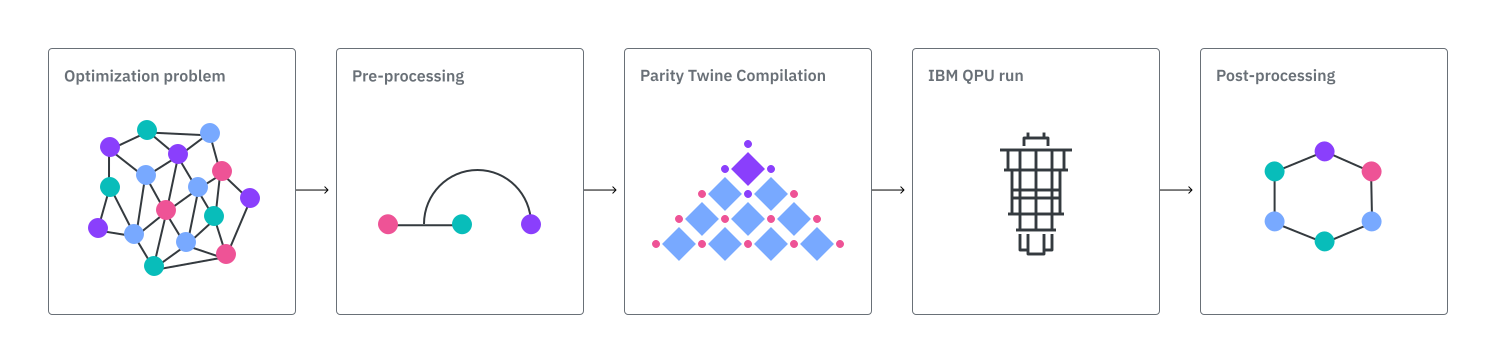
Il problema di ottimizzazione in input viene pre-elaborato in un'Hamiltoniana (normalizzata). Il compilatore ParityQC costruisce quindi un circuito ansatz Parity Twine parametrizzato, che viene transpilato in un ansatz logico corrispondente al set di gate nativo dell'hardware scelto.
I parametri del circuito QAOA vengono ottimizzati classicamente utilizzando l'approccio "efficient depth one" e assegnati al circuito transpilato. Poiché viene utilizzato un solo round di QAOA, i parametri ottimali e vengono ottenuti tramite una ricerca a griglia su CPU, senza la necessità di una costosa ottimizzazione iterativa su molte chiamate al circuito. Questo riduce notevolmente il runtime QPU richiesto dall'ottimizzatore. Il tempo di esecuzione per circuito è determinato principalmente dall'overhead costante necessario per eseguire un job sulla QPU. Con i parametri del circuito impostati, il job viene inviato alla QPU IBM® specificata.
I risultati grezzi vengono quindi post-elaborati. Questa fase utilizza una ricerca greedy locale che itera in modo casuale attraverso la stringa di soluzione e inverte i valori dei bit se ciò riduce il valore della funzione di costo.
Benchmark
Le prestazioni possono dipendere sia dall'istanza del problema sia dalle fasi di elaborazione successive. In alcuni casi, i campioni classici e quelli generati quantisticamente potrebbero raggiungere una qualità finale della soluzione simile dopo un post-processing equivalente. La valutazione dovrebbe pertanto considerare l'intero flusso di lavoro di ottimizzazione.
Modello di Sherrington-Kirkpatrick
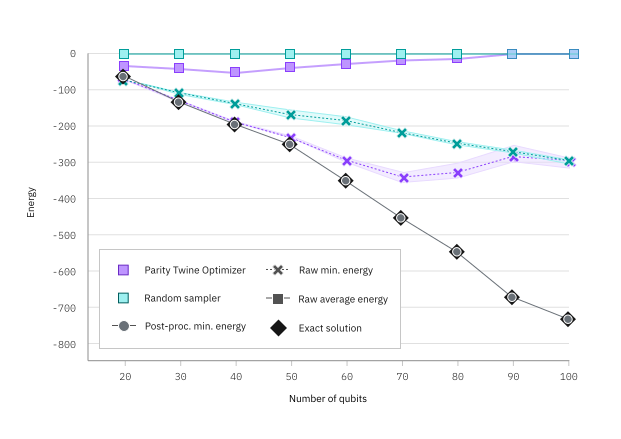
La Figura 2 dimostra l'efficacia del Parity Twine Optimizer. Vengono confrontati i risultati ottenuti utilizzando l'ottimizzatore con il campionamento casuale per il modello di Sherrington-Kirkpatrick al crescere del numero di qubit.
Il post-processing sia dei risultati casuali sia di quelli dell'ottimizzatore porta a stati fondamentali esatti, ma l'output grezzo dell'energia minima da Twine QAOA è sempre migliore dei valori casuali. Per i numeri di qubit più elevati considerati (90 e 100), il rumore dell'hardware degrada il risultato dell'ottimizzatore, che torna a valori grezzi corrispondenti al campionamento casuale.
Consulta questo tutorial per un'introduzione al modello di Sherrington-Kirkpatrick e per i dettagli su come risolverlo con il Parity Twine Optimizer.
Problema Market Split
La Tabella 1 mostra metriche di prestazione specifiche per il Parity Twine Optimizer applicato a varie istanze del problema Market Split (MS). Sono state ottenute dalla QOBLIB - Quantum Optimization Benchmarking Library e corrispondono alle submission effettuate alla libreria utilizzando il Parity Twine Optimizer.
La violazione MS è una metrica di accuratezza che misura quanto la soluzione sia distante dal soddisfare tutti i vincoli, definita come . Valori più bassi di questa metrica indicano soluzioni più accurate.
La Tabella 1 riporta i valori medi di cinque esecuzioni per ciascuna istanza utilizzando il Parity Twine Optimizer con il dispositivo ibm_boston come backend e 100.000 shot.
Viene riportata la violazione MS minima ottenuta dalle esecuzioni di ciascuna istanza.
| Istanza | Qubit | Gate a due qubit | Profondità a due qubit | Violazione MS | Tempo di mapping (s) | Runtime QPU (s) | Tempo di post-processing (s) |
|---|---|---|---|---|---|---|---|
| ms_03_050_002 | 20 | 399 | 76 | 0 | 45 | 29 | 71 |
| ms_03_100_022 | 20 | 399 | 76 | 0 | 30 | 29 | 77 |
| ms_03_200_177 | 20 | 399 | 76 | 0 | 33 | 29 | 63 |
| ms_04_050_001 | 30 | 899 | 116 | 1 | 68 | 29 | 216 |
| ms_04_100_003 | 30 | 899 | 116 | 2 | 89 | 29 | 187 |
| ms_04_200_030 | 30 | 899 | 116 | 3 | 89 | 29 | 219 |
| ms_05_100_003 | 40 | 1599 | 156 | 3 | 237 | 30 | 364 |
| ms_06_050_001 | 50 | 2499 | 196 | 4 | 499 | 30 | 464 |
| ms_07_050_001 | 60 | 3599 | 236 | 17 | 858 | 31 | 637 |
| ms_08_050_001 | 70 | 4899 | 276 | 36 | 1561 | 31 | 773 |
Tabella 1: metriche di prestazione per diverse istanze del problema Market Split. I nomi delle istanze corrispondono agli esempi presenti nella libreria di problemi QOBLIB. Come indicato in precedenza nella sezione Descrizione, il tempo QPU è minimo e quasi costante, poiché viene utilizzato un solo round di QAOA con parametri del circuito ottimali ottenuti su una CPU.
Consulta questo tutorial per un'introduzione al problema Market Split e per i dettagli su come risolverlo con il Parity Twine Optimizer.
Problema del Maximum Independent Set
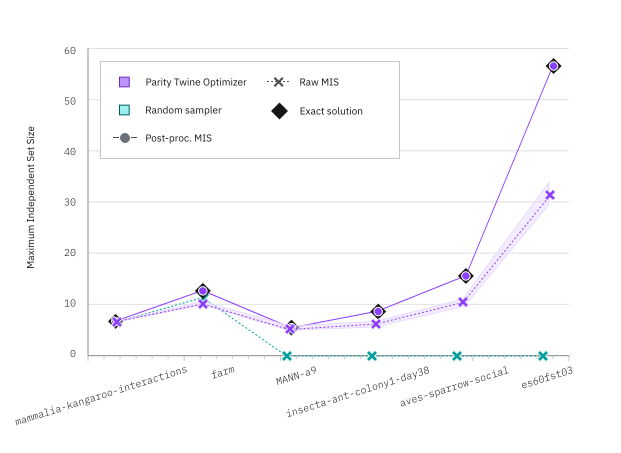
La Figura 3 confronta i risultati ottenuti utilizzando l'ottimizzatore Parity Twine con il campionamento casuale per il problema del maximum independent set, per istanze selezionate ottenute dalla QOBLIB - Quantum Optimization Benchmarking Library. Queste variano da 18 (mammalia-kangaroo-interactions) a 114 (es60fst03) qubit.
Per le istanze piccole, i risultati grezzi delle dimensioni del Maximum Independent Set ottenuti dall'ottimizzatore e dal campionamento casuale sono simili, ma per le istanze più grandi l'ottimizzatore fornisce risultati molto migliori. Anche in questo caso, il post-processing dei risultati sia del campionamento casuale sia dell'ottimizzatore porta a dimensioni degli insiemi in accordo con i valori esatti.
Per iniziare
Autenticati utilizzando il tuo token API di IBM Quantum Platform e seleziona la Qiskit Function come segue:
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit_ibm_catalog": "qiskit-ibm-catalog"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

# Authenticate and load the Qiskit Function
catalog = QiskitFunctionsCatalog(
    channel="ibm_quantum_platform",
)
function = catalog.load("parityqc/parity-twine-optimizer")
Esempio
Il Parity Twine Optimizer può essere applicato a un semplice esempio QUBO come segue. Il problema viene prima definito utilizzando un dizionario:
problem = {"()": 3, "(0,)": 1, "(0, 1)": 2, "(1, 2)": -1}
Successivamente, il tipo di variabile deve essere definito come binary o spin:
variable_type = "spin"
Questo definisce la funzione obiettivo dove .
Scegli un backend. Ad esempio:
backend_name = "ibm_phoenix"
Usa catalog.backends() per visualizzare un elenco dei backend disponibili per l'account/istanza dell'utente.
Se non viene specificato alcun backend, viene selezionato automaticamente il backend meno occupato (quello con il minor numero di job in sospeso).
Una volta caricato l'ottimizzatore (vedi sopra), puoi eseguirlo sul problema utilizzando le opzioni predefinite:
function_job = function.run(
    problem=problem, variable_type=variable_type, backend_name=backend_name
)
print(f"Job ID: {function_job.job_id}")
Verifica lo stato del job come segue:
# Monitor the job status
function_job.status()
Recupera i risultati come segue:
# Retrieve the job result if the status is DONE
result = function_job.result()

result
Stampando i risultati si ottiene quanto segue:
{
    'solution': {'0': -1, '1': 1, '2': 1},
    'objective_value': -1.0,
    'solution_bitstring': '100',
    'metadata': {
        'circuit_metrics': {
            'depth': 20,
            'gate_count': 198,
            'two_qubit_gate_depth': 4,
            'two_qubit_gate_count': 4,
            'num_qubits': 3,
            'operations': {'delay': 158, 'rz': 17, 'sx': 14, 'cz': 4, 'measure': 3, 'x': 2}
        },
        'solver_info': {
            'variable_mapping': {'0': 0, '1': 1, '2': 2},
            'bitstring_distributions': {
                'before_postprocessing': {'100': 71760, ... },
                'after_postprocessing': {'100': 88440, '011': 11560}
            },
            'best_parameters': {
                'beta': [-0.46259546391008877],
                'gamma': [0.6181957189727373]
            }
        },
        'resource_usage': {
            'RUNNING: MAPPING': {'CPU_TIME': 42.878},
            'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 0.094},
            'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 790.623},
            'RUNNING: EXECUTING_QPU': {'QPU_TIME': 28.0},
            'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.828}
        }
    }
}
Il dizionario solution corrisponde ai qubit definiti nel problema ( e ) e fornisce i loro valori di spin ottimizzati.
Il valore objective_value è il costo o l'energia del problema di ottimizzazione. Quantifica la qualità della solution.
metadata fornisce informazioni sulla transpilazione (numero/profondità dei gate a due qubit, gate utilizzati, qubit attivi) e vari runtime sia per il tempo di calcolo quantistico sia per quello classico.
Inoltre, metadata offre uno sguardo sul funzionamento interno dell'algoritmo. Puoi vedere i parametri variazionali ottimizzati (beta e gamma) e osservare come è migliorata la distribuzione delle bitstring misurate dopo l'applicazione del post-processing classico ai risultati quantistici grezzi.
Tutte le bitstring nell'output del risultato possono essere mappate alle variabili del problema utilizzando variable_mapping.
Ad esempio, puoi mappare 'solution_bitstring': '100' con 'variable_mapping': {'0': 0, '1': 1, '2': 2} alla soluzione binaria: {'0': 1, '1': 0, '2': 0}.
Poiché stai risolvendo il problema in termini di variabili di spin, devi applicare la trasformazione da binario a spin (0 -> 1, 1 -> -1 ).
Arrivi quindi alla soluzione finale 'solution': {'0': -1, '1': 1, '2': 1}.
Consulta il riferimento API per i dettagli completi sull'input e sull'output della funzione Parity Twine Optimizer.
Registro delle modifiche
[1.0.2] - 2026-09-15
Notes
Questa release segna la prima versione stabile di produzione della funzione Qiskit Parity Twine Optimizer. Le future release dovrebbero introdurre quanto segue:
- compilazione di problemi di ordine superiore,
- algoritmi di ottimizzazione aggiuntivi e
- miglioramenti nel pre- e post-processing.
Funzionalità
- Risolvi problemi QUBO sparsi e densi con l'efficiente Parity Twine Compiler.
Documentazione
- Guida utente introduttiva.
- Tutorial con esempi per i problemi Market Split e Sherrington-Kirkpatrick.
- Documentazione API.
Ottieni assistenza
Contatta ParityQC per qualsiasi domanda o problema.
Passi successivi
- Richiedi l'accesso alla funzione compilando questo modulo.
- Visita il riferimento API per questa Qiskit Function.
- Prova il tutorial per applicare il Parity Twine Optimizer al problema Market Split.
- Prova il tutorial per applicare il Parity Twine Optimizer al modello Sherrington-Kirkpatrick.
- Consulta il preprint ArXiv Connectivity-aware Synthesis of Quantum Algorithms, Drier et al. (2025).