Tecniche di mitigazione e soppressione degli errori
La versione beta di un nuovo modello di esecuzione è ora disponibile. Il modello di esecuzione guidata (directed execution model) offre maggiore flessibilità nella personalizzazione del flusso di lavoro di mitigazione degli errori. Consulta la guida Modello di esecuzione guidata per maggiori informazioni.
Le tecniche di mitigazione degli errori e di soppressione degli errori vengono usate per migliorare la qualità dei risultati quando si passa a carichi di lavoro più grandi. Questa pagina fornisce spiegazioni di alto livello sulle tecniche di soppressione e mitigazione degli errori disponibili con Qiskit.
Disaccoppiamento dinamico
I circuiti quantistici vengono eseguiti sull'hardware IBM® come sequenze di impulsi a microonde che devono essere pianificati ed eseguiti a intervalli di tempo precisi. Purtroppo, le interazioni indesiderate tra qubit possono causare errori coerenti sui qubit inattivi. Il disaccoppiamento dinamico funziona inserendo sequenze di impulsi sui qubit inattivi per annullare approssimativamente l'effetto di questi errori. Ogni sequenza di impulsi inserita equivale a un'operazione identità, ma la presenza fisica degli impulsi ha l'effetto di sopprimere gli errori. Esistono molte possibili scelte di sequenze di impulsi, e quale sequenza sia migliore per ogni caso particolare resta un campo di ricerca attivo.
Nota che il disaccoppiamento dinamico è principalmente utile per i circuiti che contengono lacune in cui alcuni qubit rimangono inattivi senza che vi agiscano operazioni. Se le operazioni nel circuito sono molto dense, così che tutti i qubit sono occupati la maggior parte del tempo, l'aggiunta di impulsi di disaccoppiamento dinamico potrebbe non migliorare le prestazioni. In effetti, potrebbe persino peggiorarle a causa delle imperfezioni degli impulsi stessi.
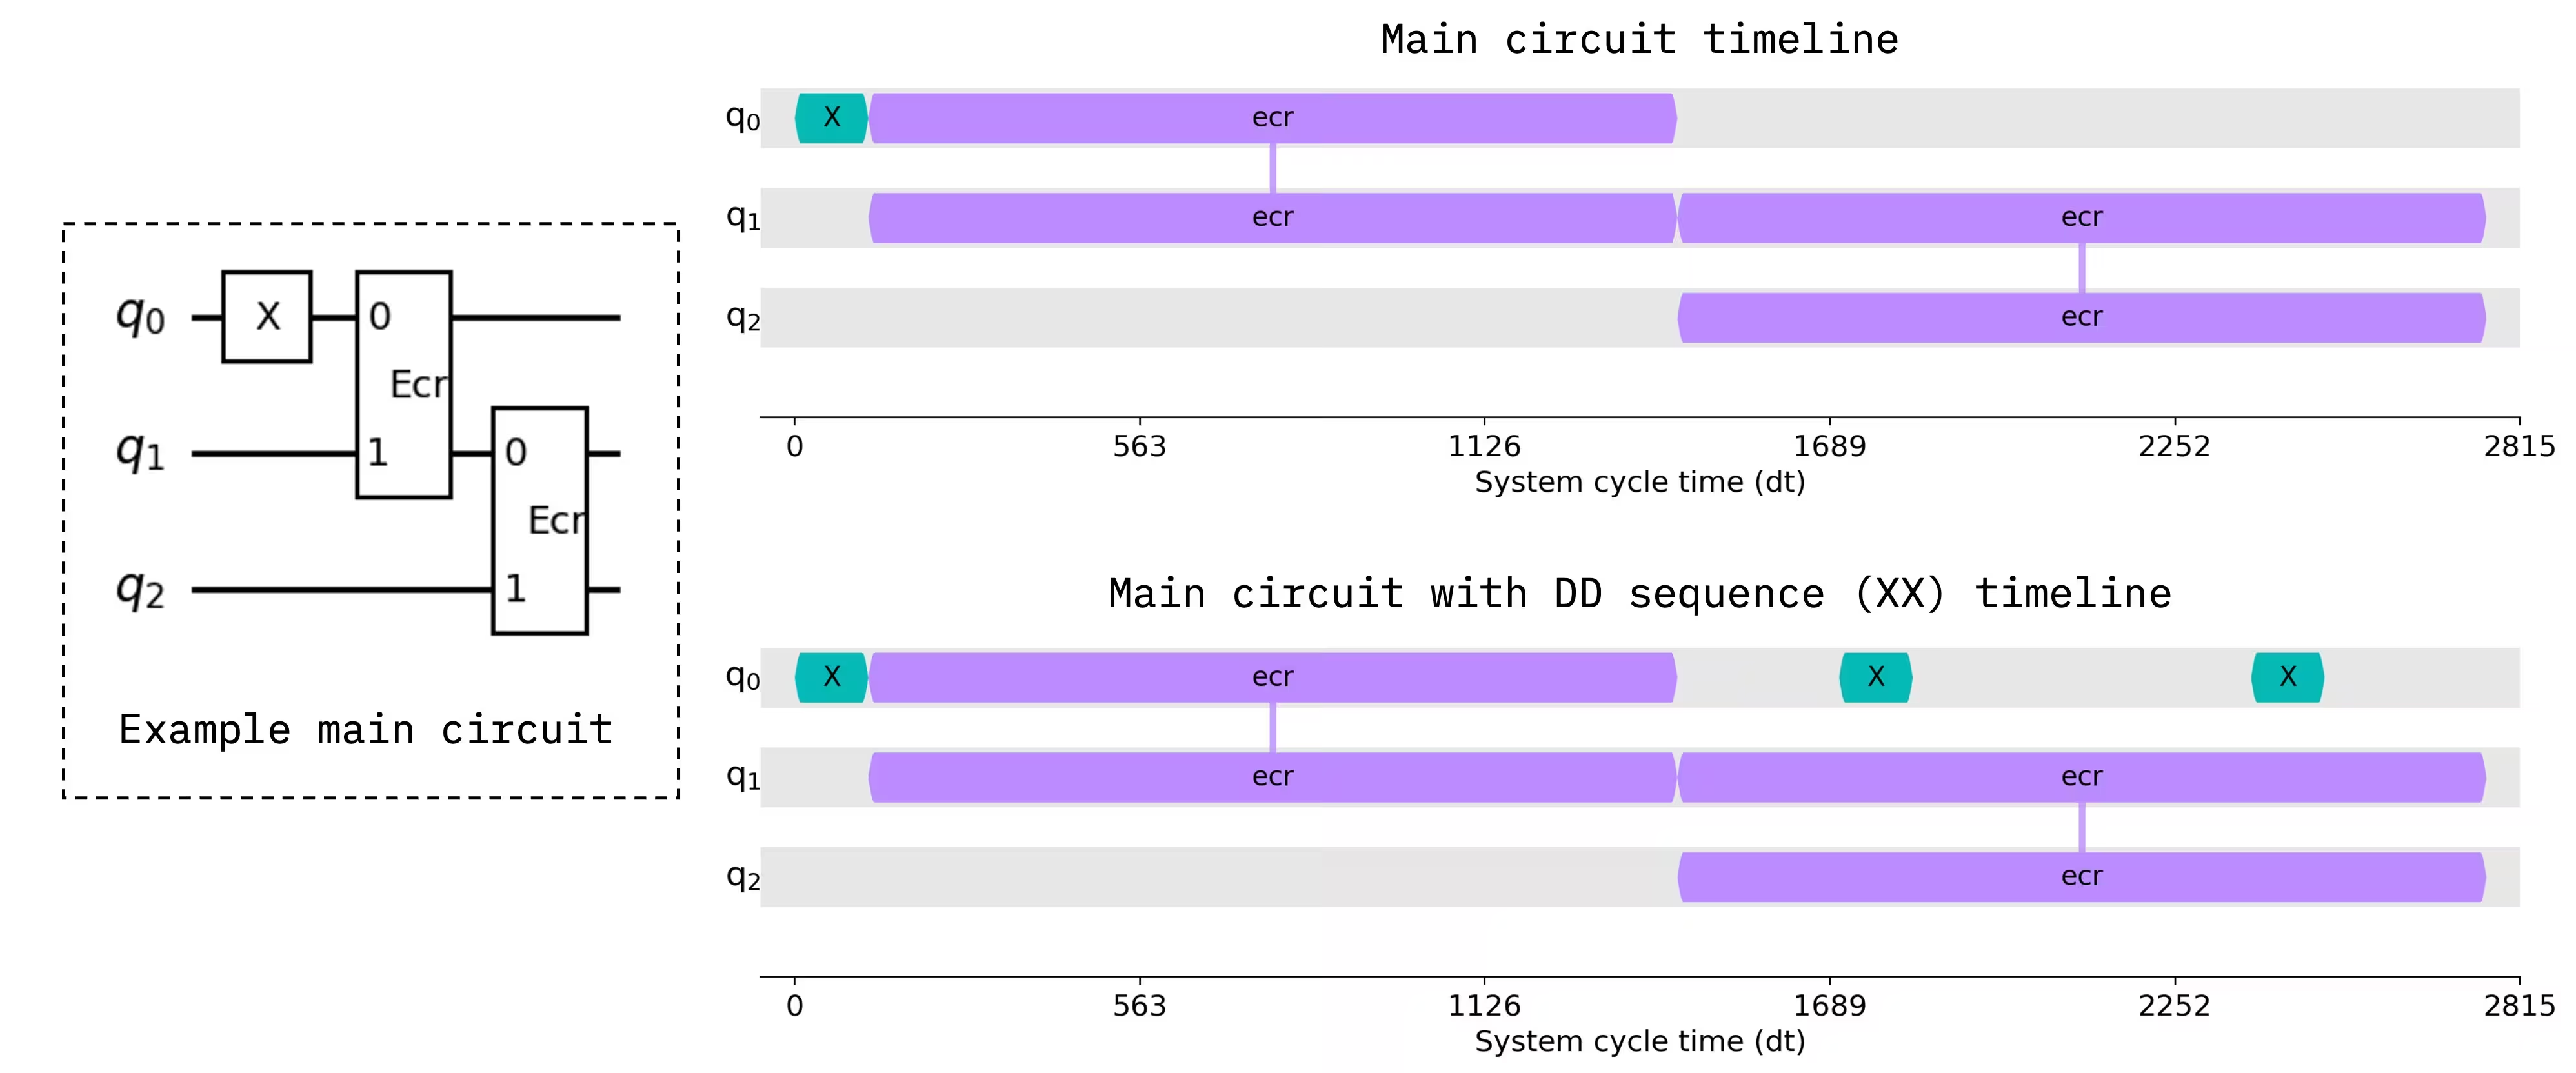
Il diagramma qui sotto illustra il disaccoppiamento dinamico con una sequenza di impulsi XX. Il circuito astratto a sinistra viene mappato su uno schedule di impulsi a microonde in alto a destra. In basso a destra è rappresentato lo stesso schedule, ma con una sequenza di due impulsi X inserita durante un periodo di inattività del primo qubit.
Puoi abilitare il disaccoppiamento dinamico nei seguenti modi:
- Il passo del transpiler per il disaccoppiamento dinamico in Qiskit
- L'opzione di disaccoppiamento dinamico se usi l'Estimator o il Sampler di IBM Quantum
Twirling di Pauli
Il twirling, noto anche come randomized compiling, è una tecnica ampiamente utilizzata per convertire canali di rumore arbitrari in canali di rumore con una struttura più specifica.
Il twirling di Pauli è un tipo speciale di twirling che utilizza operazioni di Pauli. Ha l'effetto di trasformare qualsiasi canale quantistico in un canale di Pauli. Eseguito da solo, può mitigare il rumore coerente perché il rumore coerente tende ad accumularsi in modo quadratico con il numero di operazioni, mentre il rumore di Pauli si accumula in modo lineare. Il twirling di Pauli è spesso combinato con altre tecniche di mitigazione degli errori che funzionano meglio con il rumore di Pauli rispetto al rumore arbitrario.
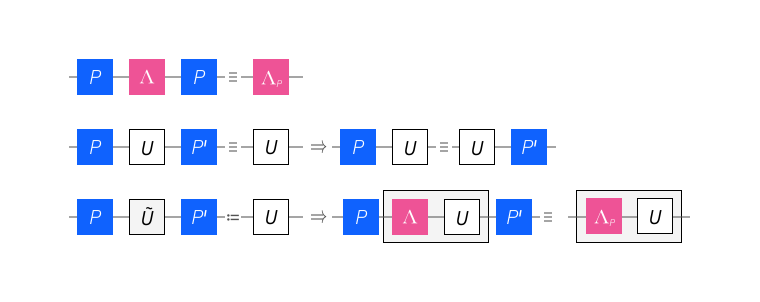
Il twirling di Pauli è implementato racchiudendo un insieme scelto di gate con gate di Pauli a singolo qubit scelti casualmente, in modo tale che l'effetto ideale del gate rimanga lo stesso. Il risultato è che un singolo circuito viene sostituito da un insieme casuale di circuiti, tutti con lo stesso effetto ideale. Quando si campiona il circuito, i campioni vengono prelevati da più istanze casuali, anziché da una sola.
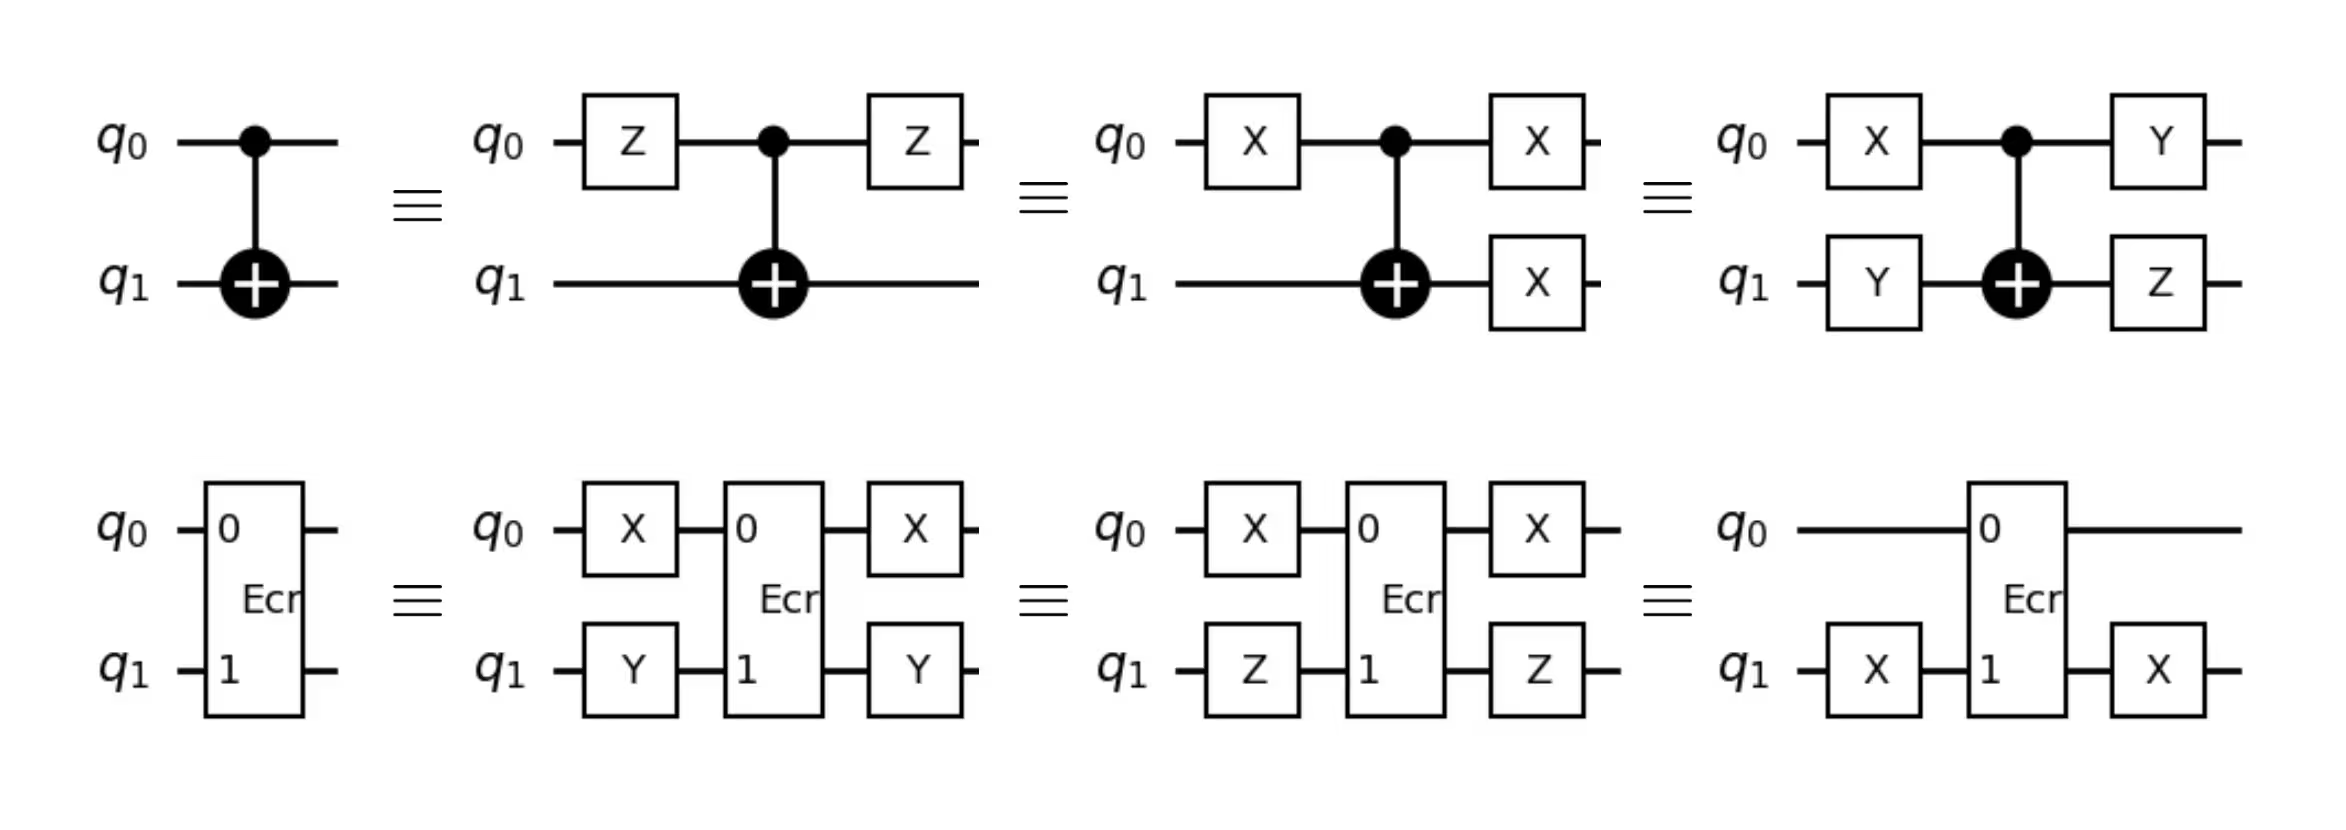
Poiché la maggior parte degli errori nell'hardware quantistico attuale proviene dai gate a due qubit, questa tecnica viene spesso applicata esclusivamente ai gate nativi a due qubit. Il diagramma seguente illustra alcuni twirl di Pauli per i gate CNOT ed ECR. Ogni circuito all'interno di una riga ha lo stesso effetto ideale.
Puoi abilitare il twirling di Pauli nei seguenti modi:
- Un passo personalizzato per il twirling di Pauli in Qiskit
- Le opzioni di twirling se usi l'Estimator o il Sampler di IBM Quantum
Estinzione degli errori di readout con twirling (TREX)
La Twirled Readout Error eXtinction (TREX) mitiga l'effetto degli errori di misura per la stima dei valori di aspettazione di osservabili di Pauli. Si basa sul concetto di misure con twirling, che vengono realizzate sostituendo casualmente i gate di misura con una sequenza composta da (1) un gate Pauli X, (2) una misura, e (3) un flip del bit classico. Proprio come nel twirling standard dei gate, questa sequenza equivale a una misura semplice in assenza di rumore, come illustrato nel diagramma seguente:

In presenza di errori di readout, il twirling della misura ha l'effetto di diagonalizzare la matrice di trasferimento degli errori di readout, rendendone facile l'inversione. Un termine di riscalamento dal canale di rumore diagonale viene appreso effettuando il benchmarking di circuiti casuali inizializzati nello stato zero. Questo consente al servizio di rimuovere il bias dai valori di aspettazione che risultano dal rumore di readout. La stima della matrice di trasferimento degli errori di readout richiede l'esecuzione di circuiti di calibrazione aggiuntivi, il che introduce un piccolo overhead.
Puoi abilitare TREX nei seguenti modi:
- L'addon Qiskit Mitigation per Qiskit
- L'opzione
measure_mitigationse usi l'Estimator di IBM Quantum - Il livello di resilienza se usi l'Estimator di IBM Quantum
Estrapolazione a rumore zero (ZNE)
L'estrapolazione a rumore zero (ZNE, Zero-Noise Extrapolation) è una tecnica per mitigare gli errori nella stima dei valori di aspettazione di osservabili. Pur migliorando spesso i risultati, non garantisce di produrre un risultato privo di bias.
La ZNE è composta da due fasi:
-
Amplificazione del rumore: Il circuito quantistico originale viene eseguito più volte a diversi livelli di rumore.
-
Estrapolazione: Il risultato ideale viene stimato estrapolando i risultati dei valori di aspettazione rumorosi al limite di rumore zero.
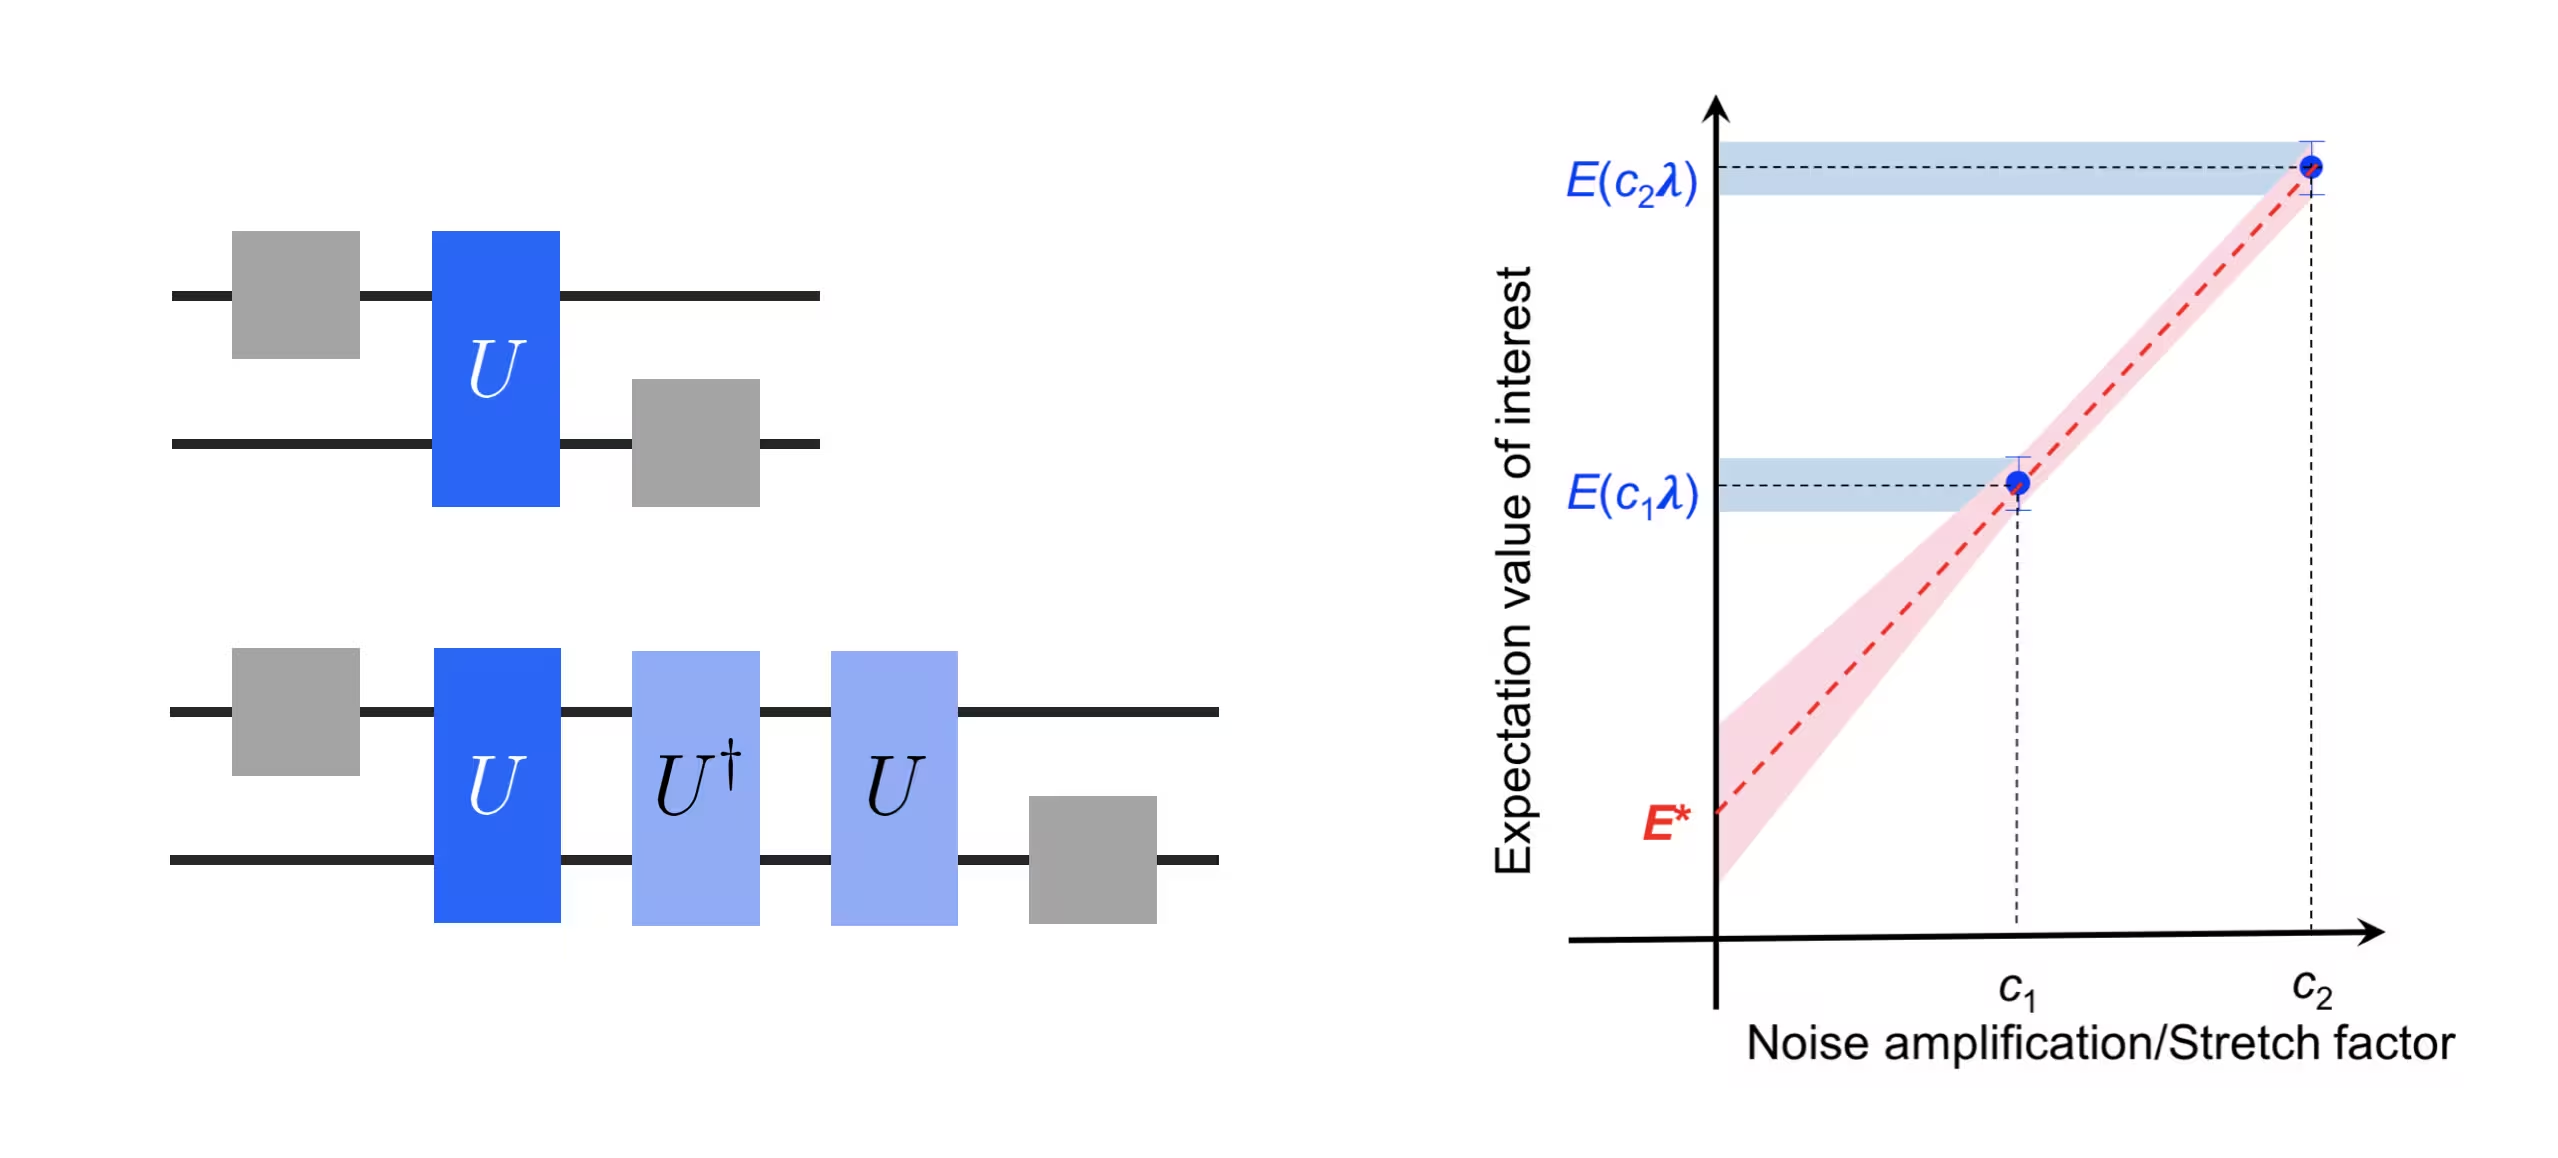
Sia la fase di amplificazione del rumore che quella di estrapolazione possono essere implementate in molti modi diversi. IBM Quantum Compute implementa l'amplificazione del rumore tramite il "gate folding digitale", ovvero i gate a due qubit vengono sostituiti con sequenze equivalenti del gate e del suo inverso. Per esempio, sostituire un unitario con produce un fattore di amplificazione del rumore pari a 3. Per l'estrapolazione, puoi scegliere tra diverse forme funzionali, tra cui un fit lineare o un fit esponenziale. L'immagine qui sotto illustra il gate folding digitale a sinistra e la procedura di estrapolazione a destra.
L'overhead di questo metodo scala con il numero di fattori di rumore. Le impostazioni predefinite campionano il valore di aspettazione a tre fattori di rumore, portando a un overhead di circa 3x.
Puoi abilitare ZNE nei seguenti modi:
- L'addon Qiskit Mitigation per Qiskit
- L'opzione
zne_mitigationse usi l'Estimator di IBM Quantum - Il livello di resilienza se usi l'Estimator di IBM Quantum
Amplificazione probabilistica degli errori (PEA)
Una delle principali sfide della ZNE è amplificare con precisione il rumore che affligge il circuito target. Il gate folding fornisce un modo semplice per eseguire questa amplificazione, ma è potenzialmente impreciso e potrebbe portare a risultati errati. Consulta l'articolo "Scalable error mitigation for noisy quantum circuits produces competitive expectation values", e in particolare la pagina 4 delle informazioni supplementari per i dettagli. L'amplificazione probabilistica degli errori fornisce un approccio più preciso all'amplificazione degli errori tramite l'apprendimento del rumore.
La PEA è una tecnica più sofisticata che esegue esperimenti preliminari per ricostruire il rumore e poi utilizza queste informazioni per eseguire un'amplificazione accurata. Inizia apprendendo il modello di rumore con twirling di ogni strato di gate di entanglement nel circuito prima della loro esecuzione. Dopo la fase di apprendimento, i circuiti vengono eseguiti a ciascun fattore di rumore, dove ogni strato di entanglement dei circuiti viene amplificato iniettando in modo probabilistico rumore a singolo qubit proporzionale al corrispondente modello di rumore appreso. Consulta l'articolo "Evidence for the utility of quantum computing before fault tolerance" per maggiori dettagli.
La PEA è composta da tre fasi:
- Apprendimento: Viene appreso il modello di rumore con twirling di ogni strato di gate di entanglement nel circuito.
- Amplificazione del rumore: Il circuito quantistico originale viene eseguito più volte a diversi fattori di rumore.
- Estrapolazione: Il risultato ideale viene stimato estrapolando i risultati dei valori di aspettazione rumorosi al limite di rumore zero.
Per esperimenti su scala utility, la PEA è spesso la scelta migliore.
Poiché PEA è una tecnica di amplificazione del rumore per ZNE, devi abilitare anche ZNE. Puoi abilitare PEA e ZNE nei seguenti modi:
- L'addon Qiskit Mitigation per Qiskit
- L'opzione
zne_mitigationconpeacome amplificatore se usi l'Estimator di IBM Quantum
Se stai usando il nuovo Estimator lato client introdotto in qiskit-ibm-runtime v0.50.0, è richiesto un job di apprendimento del rumore separato per usare PEA.
Consulta Migra da Sampler ed Estimator lato server a lato client per maggiori informazioni.
Cancellazione probabilistica degli errori (PEC)
La cancellazione probabilistica degli errori (PEC, Probabilistic Error Cancellation) è una tecnica per mitigare gli errori nella stima dei valori di aspettazione di osservabili. A differenza della ZNE, restituisce una stima non distorta del valore di aspettazione. Tuttavia, in generale comporta un overhead maggiore.
Nella PEC, l'effetto di un circuito target ideale è espresso come combinazione lineare di circuiti rumorosi effettivamente implementabili in pratica:
L'output del circuito ideale può quindi essere riprodotto eseguendo diverse istanze di circuito rumoroso estratte da un insieme casuale definito dalla combinazione lineare. Se i coefficienti formano una distribuzione di probabilità, possono essere usati direttamente come probabilità dell'insieme. In pratica, alcuni coefficienti sono negativi, quindi formano invece una distribuzione di quasi-probabilità. Possono comunque essere usati per definire un insieme casuale, ma esiste un overhead di campionamento legato alla negatività della distribuzione di quasi-probabilità, che è caratterizzato dalla quantità
L'overhead di campionamento è un fattore moltiplicativo sul numero di shot necessari per stimare un valore di aspettazione con una data precisione, rispetto al numero di shot che sarebbero necessari dal circuito ideale. Scala in modo quadratico con , che a sua volta scala in modo esponenziale con la profondità del circuito.
Puoi abilitare PEC nei seguenti modi:
- L'addon Qiskit Mitigation per Qiskit
- L'opzione
pec_mitigationse usi l'Estimator di IBM Quantum
Se stai usando il nuovo Estimator lato client introdotto in qiskit-ibm-runtime v0.50.0, è richiesto un job di apprendimento del rumore separato per usare PEC.
Consulta Migra da Sampler ed Estimator lato server a lato client per maggiori informazioni.
Passi successivi
-
Consulta il tutorial sulla combinazione delle opzioni di mitigazione degli errori con la primitiva Estimator.
-
Esplora le altre opzioni per le primitive di IBM Quantum.
-
Decidi in quale modalità di esecuzione eseguire il tuo job.