Classifica il rischio di credito con la Quantum Feature Extraction Rimay di Kipu Quantum
Le Qiskit Functions sono una funzionalità sperimentale disponibile solo per gli utenti dei piani IBM Quantum® Premium Plan, Flex Plan e On-Prem (tramite IBM Quantum Platform API) Plan. Sono in stato di rilascio in anteprima e soggette a modifiche.
Stima di utilizzo: 2 minuti su un processore Nighthawk r2. (NOTA: si tratta solo di una stima. Il tuo tempo di esecuzione potrebbe variare.)
Obiettivi di apprendimento
-
Preparare dati tabulari con colonne categoriche e numeriche per la Qiskit Function Rimay.
-
Adattare una mappatura quantistica delle feature sui dati di addestramento e mappare i dati di test nella stessa esecuzione.
-
Addestrare modelli classici sulle feature trasformate quantisticamente, da sole e combinate con le feature originali.
-
Confrontare i risultati con una baseline puramente classica.
Prerequisiti
Prima di iniziare questo tutorial, dovresti avere familiarità con i seguenti argomenti:
-
Classificazione supervisionata con scikit-learn
Contesto
Molti problemi di machine learning nell'industria riguardano dataset tabulari di dimensioni piccole o medie, in cui aggiungere altri dati non è un'opzione e l'accuratezza del modello raggiunge un plateau. Il credit scoring è un esempio tipico. Un istituto di credito usa qualche decina di attributi per decidere se è probabile che il richiedente rimborserà il credito.
Rimay, una Qiskit Function di Kipu Quantum, aggiunge una fase di preelaborazione quantistica a una pipeline di questo tipo. Implementa l'algoritmo di estrazione quantistica delle feature controdiabatico digitalizzato [1]. Ogni feature in ingresso è mappata su un qubit. I valori delle feature e l'informazione mutua tra le feature determinano i campi locali e gli accoppiamenti di un hamiltoniano di vetro di spin. La dinamica controdiabatica fa poi evolvere il sistema quantistico verso i suoi stati a bassa energia, e i valori di aspettazione a uno e due corpi misurati alla fine diventano le nuove feature trasformate quantisticamente. Queste feature catturano correlazioni non lineari tra gli input e puoi darle in pasto a qualsiasi modello classico.
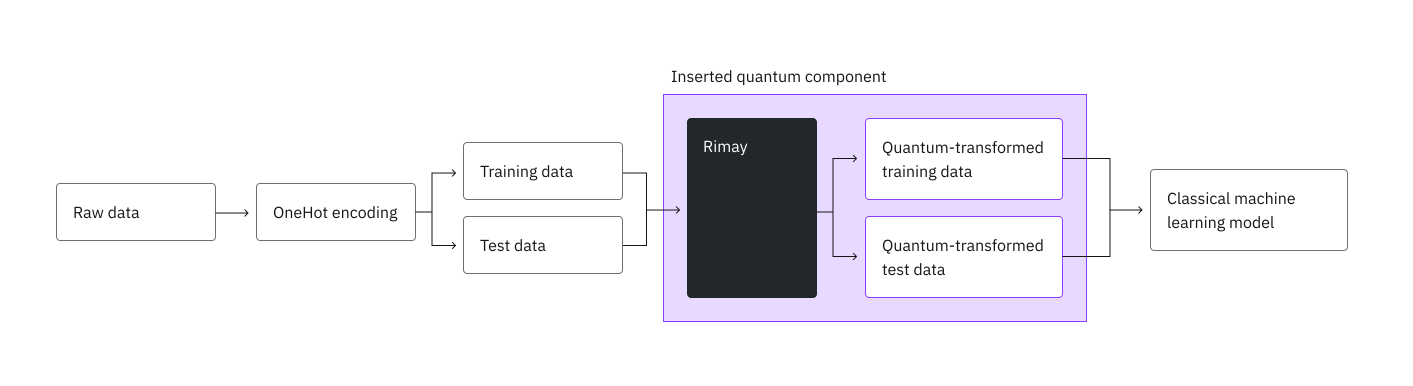
Questo tutorial usa il dataset German credit da OpenML [2], con 1000 richiedenti e 20 attributi, per addestrare un classificatore random forest. Per prima cosa stabilisci una baseline classica, poi invii i dati a Rimay e infine addestri lo stesso tipo di modello sulle feature trasformate quantisticamente, da sole e combinate con le feature originali.
Requisiti
Prima di iniziare questo tutorial, assicurati di avere installato i seguenti pacchetti:
-
IBM Quantum Compute client (
pip install qiskit-ibm-runtime) -
Qiskit Functions (
pip install qiskit-ibm-catalog) -
scikit-learn (
pip install scikit-learn) -
pandas (
pip install pandas) -
Matplotlib (
pip install matplotlib)
Hai inoltre bisogno dell'accesso alla funzione Rimay del Qiskit Functions Catalog.
Configurazione
Importa i pacchetti e definisci due funzioni di supporto: una che addestra una random forest e una che calcola le metriche usate in tutto il tutorial.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pandas": "pandas", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "sklearn": "scikit-learn"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
from qiskit_ibm_catalog import QiskitFunctionsCatalog
from sklearn.datasets import fetch_openml
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import (
    accuracy_score,
    f1_score,
    precision_score,
    recall_score,
    roc_auc_score,
)
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import OneHotEncoder

def train_random_forest(x, y, n_estimators, max_depth):
    """Train a random forest classifier with fixed hyperparameters."""
    model = RandomForestClassifier(
        n_estimators=n_estimators,
        max_depth=max_depth,
        min_samples_split=5,
        min_samples_leaf=1,
        max_features="sqrt",
        random_state=42,
        n_jobs=-1,
    )
    return model.fit(x, y)

def evaluate(model, x, y):
    """Return the classification metrics of a trained model on a test set."""
    y_pred = model.predict(x)
    y_proba = model.predict_proba(x)[:, 1]
    return {
        "Accuracy": accuracy_score(y, y_pred),
        "AUC": roc_auc_score(y, y_proba),
        "F1 score": f1_score(y, y_pred),
        "Precision": precision_score(y, y_pred),
        "Recall": recall_score(y, y_pred),
    }
Configura le credenziali di IBM Quantum
Autenticati con la tua chiave API di IBM Quantum Platform, carica la funzione Rimay e seleziona il processore quantistico meno occupato disponibile per la tua istanza.
catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")
rimay = catalog.load("kipu-quantum/rimay")

backend = catalog.least_busy(operational=True, simulator=False)
print(backend.name, backend.num_qubits)
ibm_fez 156
Passo 1: Mappare gli input classici su un problema quantistico
Rimay mappa ogni feature di input numerica su un qubit, quindi il primo passo consiste nel trasformare la tabella grezza in feature numeriche.
Carica il dataset
Carica il dataset German credit direttamente da OpenML. La colonna class contiene l'etichetta: good per i richiedenti che hanno rimborsato il credito e bad per quelli che non l'hanno fatto.
df = fetch_openml(data_id=31, as_frame=True).frame
print(df.shape)
df.head()
(1000, 21)
checking_status  duration                  credit_history  \
0              <0         6  critical/other existing credit
1        0<=X<200        48                   existing paid
2     no checking        12  critical/other existing credit
3              <0        42                   existing paid
4              <0        24              delayed previously

               purpose  credit_amount    savings_status employment  \
0             radio/tv           1169  no known savings        >=7
1             radio/tv           5951              <100     1<=X<4
2            education           2096              <100     4<=X<7
3  furniture/equipment           7882              <100     4<=X<7
4              new car           4870              <100     1<=X<4

   installment_commitment     personal_status other_parties  ...  \
0                       4         male single          none  ...
1                       2  female div/dep/mar          none  ...
2                       2         male single          none  ...
3                       2         male single     guarantor  ...
4                       3         male single          none  ...

   property_magnitude age  other_payment_plans   housing existing_credits  \
0         real estate  67                 none       own                2
1         real estate  22                 none       own                1
2         real estate  49                 none       own                1
3      life insurance  45                 none  for free                1
4   no known property  53                 none  for free                2

                  job num_dependents  own_telephone foreign_worker class
0             skilled              1            yes            yes  good
1             skilled              1           none            yes   bad
2  unskilled resident              2           none            yes  good
3             skilled              2           none            yes  good
4             skilled              2           none            yes   bad

[5 rows x 21 columns]
Codifica le feature
Converti l'etichetta in un valore binario e applica la codifica one-hot alle 13 colonne categoriche. Il codice elimina la prima categoria di ogni colonna per evitare feature ridondanti, ottenendo 48 feature numeriche.
y = (df["class"] == "good").astype(int)

features = df.drop(columns="class")
categorical_cols = [
    col for col in features.columns if features[col].dtype.name == "category"
]
encoder = OneHotEncoder(
    sparse_output=False, handle_unknown="ignore", drop="first"
)
encoded = pd.DataFrame(
    encoder.fit_transform(features[categorical_cols]),
    columns=encoder.get_feature_names_out(categorical_cols),
    index=features.index,
)
x = pd.concat([features.drop(columns=categorical_cols), encoded], axis=1)
print(f"{x.shape[1]} features")
48 features
Dividi in insiemi di addestramento e di test
Riserva il 20% dei richiedenti come insieme di test. Una suddivisione stratificata mantiene uguale in entrambi gli insiemi la quota di crediti buoni e cattivi.
x_train, x_test, y_train, y_test = train_test_split(
    x, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Training set: {x_train.shape}, test set: {x_test.shape}")
Training set: (800, 48), test set: (200, 48)
Stabilisci una baseline classica
Addestra una random forest sulle feature classiche. Nel Passo 4 confronterai le feature trasformate quantisticamente con le sue metriche.
baseline = train_random_forest(
    x_train, y_train, n_estimators=500, max_depth=12
)
results = {"Classical": evaluate(baseline, x_test, y_test)}
pd.DataFrame(results).T
Accuracy       AUC  F1 score  Precision    Recall
Classical     0.765  0.781071  0.845902   0.781818  0.921429
Carica i dati su Rimay
Rimay legge i propri input da file CSV che carichi sulla funzione. Le feature e le etichette vanno in file separati. Carichi anche l'insieme di test, in modo che Rimay lo mappi con la stessa mappatura che ha adattato sull'insieme di addestramento.
x_train.to_csv("x_train.csv", index=False)
y_train.to_csv("y_train.csv", index=False)
x_test.to_csv("x_test.csv", index=False)

for file_name in ("x_train.csv", "y_train.csv", "x_test.csv"):
    catalog.file_upload(file_name, rimay)
Passo 2: Ottimizzare il problema per l'esecuzione su hardware quantistico
Rimay costruisce e traspila i circuiti per il processore che selezioni, quindi non c'è alcun circuito da ottimizzare a mano. Specifica il numero di shot per circuito, entro i seguenti vincoli:
-
Ogni feature richiede un qubit, quindi il processore deve avere almeno tanti qubit quante sono le feature del dataset.
-
Rimay esegue un circuito per riga, righe di addestramento e di test insieme. Un singolo job può richiedere al massimo 10 milioni di esecuzioni, quindi il numero di righe per
shotsdeve rimanere entro questo budget.
Controlla entrambi i limiti prima di inviare il job.
Un job deve inoltre terminare entro 24 ore, incluso il tempo di attesa dei suoi circuiti in coda, altrimenti viene interrotto senza produrre un risultato.
shots = 5000

n_rows = len(x_train) + len(x_test)
n_features = x_train.shape[1]
print(f"Qubits needed: {n_features} of {backend.num_qubits} available")
print(f"Executions: {n_rows * shots:,} of 10,000,000 allowed")
Qubits needed: 48 of 156 available
Executions: 5,000,000 of 10,000,000 allowed
Calcola la dimensione della funzione
Ogni job viene eseguito con una dimensione della funzione, S, M o L, che seleziona le risorse di calcolo su cui gira. Per Rimay, la dimensione dipende dal numero di righe che un job mappa, righe di addestramento e di test insieme. Se richiedi una dimensione troppo piccola, il job fallisce con l'errore 4600. Per le dimensioni e i relativi limiti, consulta Function sizes nella guida di Rimay.
La cella seguente definisce il calcolatore della dimensione. Viene eseguito sulla tua macchina, legge solo i dati che gli passi e non invia nulla.
from os import PathLike
from typing import Any, Literal, Sequence, Sized

Size = Literal["S", "M", "L"]

# Upper bounds (inclusive) in samples.
_SMALL = 2_999
_MEDIUM = 9_999

FIT_TRANSFORM, TRANSFORM, DELETE = "fit-transform", "transform", "delete"

# Which positions of input_file hold samples, per mode. The labels in
# y_train submit no circuits of their own, so they are not counted.
SAMPLE_POSITIONS = {FIT_TRANSFORM: (0, 2), TRANSFORM: (0,)}

def calculate_function_size(problem: Sequence[Sized], **kwargs: Any) -> Size:
    """Return the size ("S", "M" or "L") required to run the function."""
    metrics = _measure(problem, **kwargs)
    if _is_small(metrics):
        return "S"
    if _is_medium(metrics):
        return "M"
    return "L"

def _measure(problem: Sequence[Sized], **kwargs: Any) -> dict:
    """The samples the job submits."""
    return {"samples": count_samples(problem, kwargs.get("mode"))}

def count_samples(problem: Sequence[Sized], mode: Any) -> int:
    """Rows across the data sets of ``problem`` that carry samples."""
    if mode == DELETE:
        return 0
    if mode not in SAMPLE_POSITIONS:
        raise ValueError(f"cannot size mode {mode!r}")
    if _is_name(problem) or (
        isinstance(problem, (list, tuple))
        and any(_is_name(data) for data in problem)
    ):
        raise TypeError(
            "pass the data, not the file name: read each input_file, e.g. with "
            "pandas.read_csv, and pass the data sets in input_file order"
        )
    if not isinstance(problem, (list, tuple)):
        raise TypeError(
            "pass a list of data sets in input_file order, e.g. [x_train, y_train], "
            f"not a single {type(problem).__name__}"
        )
    return sum(
        len(problem[i]) for i in SAMPLE_POSITIONS[mode] if i < len(problem)
    )

def _is_name(value: Any) -> bool:
    """A file name or path rather than data."""
    return isinstance(value, (str, bytes, PathLike))

def _is_small(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'S'."""
    return metrics["samples"] <= _SMALL

def _is_medium(metrics: dict) -> bool:
    """Determine if the metrics fit T-size 'M'."""
    return metrics["samples"] <= _MEDIUM
Passa gli insiemi di dati nello stesso ordine dei file in input_file, insieme alla modalità dell'esecuzione:
size = calculate_function_size(
    [x_train, y_train, x_test], mode="fit-transform"
)
print(size)
S
Passo 3: Eseguire usando le primitive di Qiskit
Esegui Rimay in modalità fit-transform. Adatta una mappatura quantistica delle feature su x_train.csv e y_train.csv e con essa mappa sia l'insieme di addestramento sia quello di test. L'ordine dei file in input_file è importante. Elenca le feature di addestramento, le etichette di addestramento e poi le feature di test opzionali. Passa la dimensione che hai calcolato come function_size.
job = rimay.run(
    mode="fit-transform",
    input_file=[
        "x_train.csv",
        "y_train.csv",
        "x_test.csv",
    ],  # This order matters
    backend_name=backend.name,
    shots=shots,
    function_size=size,
)
print(job.job_id)
de5094df-bb17-4924-9605-d6196a4aa999
Monitora il job
Controlla lo stato del job mentre è in esecuzione. job.result() si blocca finché il job non è terminato.
print(job.status())
INITIALIZING
result = job.result()
print(result["output_files"])
['de5094df-bb17-4924-9605-d6196a4aa999_xq_train.csv', 'de5094df-bb17-4924-9605-d6196a4aa999_xq_test.csv']
Il risultato contiene un mapping_id, che identifica la mappatura adattata da questa esecuzione. Non ti serve in questo tutorial, perché l'insieme di test è stato mappato nella stessa esecuzione. Annota questo ID se vuoi mappare nuove righe in seguito con mode="transform". È l'unico modo per accedere alla mappatura adattata e, senza di esso, dovrai adattarne e pagarne una nuova. La mappatura è costruita per il layout dei qubit di questo processore, quindi una successiva esecuzione transform deve passare lo stesso backend_name.
mapping_id = result["mapping_id"]
Passo 4: Post-elaborare e restituire il risultato nel formato classico desiderato
Scarica le feature trasformate quantisticamente
Scarica i file scritti dal job, usando i nomi in output_files. Ogni nome inizia con l'ID del job, così i file di questa esecuzione restano disponibili dopo le esecuzioni successive. Passa target_name in modo che ogni file venga salvato con il proprio nome.
train_file, test_file = result["output_files"]
for file_name in (train_file, test_file):
    catalog.file_download(file_name, rimay, target_name=file_name)

xq_train = pd.read_csv(train_file).to_numpy()
xq_test = pd.read_csv(test_file).to_numpy()
print(f"Quantum-transformed features: {xq_train.shape[1]}")
586kiB [00:00, 1.13MiB/s]
147kiB [00:00, 336kiB/s]
Quantum-transformed features: 99
Addestra sulle feature trasformate quantisticamente
Addestra una random forest solo sulle feature trasformate quantisticamente.
quantum = train_random_forest(
    xq_train, y_train, n_estimators=900, max_depth=15
)
results["Quantum"] = evaluate(quantum, xq_test, y_test)
Addestra sulle feature classiche e quantistiche combinate
Affianca le feature originali e quelle trasformate quantisticamente e addestra lo stesso modello sulla combinazione.
xh_train = np.hstack([x_train.to_numpy(), xq_train])
xh_test = np.hstack([x_test.to_numpy(), xq_test])

hybrid = train_random_forest(
    xh_train, y_train, n_estimators=900, max_depth=15
)
results["Hybrid"] = evaluate(hybrid, xh_test, y_test)
Confronta i risultati
Confronta i tre modelli sull'insieme di test.
comparison = pd.DataFrame(results).T
print(comparison.round(3))

comparison[["Accuracy", "AUC", "F1 score"]].T.plot.bar(rot=0, figsize=(8, 4))
plt.ylim(0.5, 1.0)
plt.ylabel("Score on the test set")
plt.title("Random forest on classical, quantum, and hybrid features")
plt.show()
Accuracy    AUC  F1 score  Precision  Recall
Classical     0.765  0.781     0.846      0.782   0.921
Quantum       0.730  0.784     0.827      0.750   0.921
Hybrid        0.730  0.791     0.825      0.756   0.907

L'AUC misura quanto bene un modello classifica i crediti buoni sopra quelli cattivi, indipendentemente da una soglia decisionale, il che lo rende la metrica più informativa su questo dataset sbilanciato (70% di crediti buoni). Nei benchmark di Kipu Quantum, le feature trasformate quantisticamente da sole hanno raggiunto un'AUC simile a quella della baseline classica, mentre il modello ibrido, che combina entrambe, ha raggiunto la AUC e il punteggio F1 più alti. Le feature trasformate quantisticamente aggiungono quindi informazioni che le feature classiche da sole non forniscono.
Pulizia (facoltativa)
Una mappatura adattata resta disponibile finché non la elimini. Se non vuoi mappare altri dati con essa, eliminala. Un'eliminazione non esegue alcun lavoro quantistico, non usa tempo QPU e non può essere annullata.
# rimay.run(mode="delete", mapping_id=mapping_id).result()
{'output_files': [],
 'mode': 'delete',
 'deleted': True,
 'mapping_id': 'eUCy4EnZM7G9jYo5b2Pu-TuCXK7zX_wPTT67g9J1dVE',
 'metadata': {'version': '0.6.0', 'resource_usage': {}}}
Conclusione
Cosa hai realizzato
In questo tutorial hai realizzato quanto segue:
-
Hai preparato un dataset reale di rischio di credito con attributi categorici e numerici per l'estrazione quantistica di feature.
-
Hai stabilito una baseline con random forest classica.
-
Hai usato Rimay per adattare una mappatura quantistica delle feature su hardware quantistico e mappare gli insiemi di addestramento e di test in un'unica esecuzione.
-
Hai addestrato lo stesso modello sulle feature trasformate quantisticamente e su quelle combinate, confrontandole con la baseline.
Punti chiave
-
Rimay si inserisce in una pipeline di machine learning esistente come un ulteriore passo di preelaborazione. Mantieni la tua preparazione dei dati e il tuo modello classico.
-
Il numero di qubit limita il numero di feature di input e il numero di righe per
shotslimita la dimensione di un singolo job. -
Usa come impostazione predefinita le feature trasformate quantisticamente combinate con quelle originali, perché il modello può sfruttare entrambe.
Prossimi passi
- Leggi la guida di Rimay per conoscere tutti gli input, mappare nuovi dati con
mode="transform"e vedere ulteriori benchmark. - Leggi come l'estrazione quantistica di feature è stata applicata alla classificazione di immagini satellitari [3].
Riferimenti
[1] Simen, A., et al. (2025). Digitized Counterdiabatic Quantum Feature Extraction. arXiv preprint arXiv:2510.13807.
[2] Hofmann, H. (1994). Statlog (German Credit Data). OpenML dataset 31.
[3] Zhang, Q., et al. (2026). Quantum-enhanced satellite image classification. arXiv preprint arXiv:2602.18350.