Esegui carichi di lavoro quantistici con QRMI
Stima di utilizzo: meno di un minuto su hardware IBM Quantum® per la sezione SQD. Questa stima esclude il tempo di coda e l'elaborazione classica; il tempo di esecuzione può variare.
Obiettivi di apprendimento
-
Il ruolo che QRMI svolge come middleware tra gli scheduler HPC e l'hardware IBM Quantum
-
Come usare il ciclo di vita fondamentale di QRMI (
acquire→task_start→task_status→task_result→release) con un backend IBM® reale -
Come usare i wrapper Qiskit
SamplerV2eQRMIServicedi livello superiore sopra QRMI -
Come gli scheduler HPC (Slurm) iniettano risorse quantistiche tramite variabili d'ambiente e come le applicazioni le utilizzano
-
Come eseguire un workflow di chimica SQD (Sample-based Quantum Diagonalization) completo su N usando hardware IBM tramite QRMI
Prerequisiti
-
Familiarità di base con gli ambienti virtuali Python e la chimica quantistica
Contesto
La sfida dell'integrazione tra quantistico e HPC
I flussi di lavoro di calcolo ad alte prestazioni (HPC) richiedono spesso un coordinamento senza soluzione di continuità tra cluster di calcolo classici e unità di elaborazione quantistica (QPU). Diversi backend e servizi hardware quantistici espongono meccanismi di autenticazione, formati di trasmissione e API per il ciclo di vita dei job distinti. Integrare i sistemi IBM Quantum nei gestori di carichi di lavoro HPC (come Slurm) richiede un'interfaccia pulita e standard per l'acquisizione delle risorse, l'esecuzione dei job e la gestione delle sessioni.
Cos'è QRMI
La Quantum Resource Management Interface (QRMI) è una libreria middleware scritta in Rust che standardizza l'accesso all'hardware quantistico da parte degli scheduler HPC e delle applicazioni classiche. Espone un'unica API unificata per il ciclo di vita:
┌─────────────────────────────────────────────────────────────────┐
│                     HPC Application Layer                       │
│          (Slurm job script / Python workflow / CUDA-Q)          │
└───────────────────────────┬─────────────────────────────────────┘
                            │  QRMI API
                            │  acquire() / task_start() / task_result() / release()
┌───────────────────────────▼─────────────────────────────────────┐
│                        QRMI Core (Rust)                         │
│            Python bindings · C bindings · Lua bindings          │
└───────────────────────────┬─────────────────────────────────────┘
                            │
               IBM Quantum Compute Service / IBM Quantum System
QRMI è pubblicato come progetto open source su github.com/qiskit-community/qrmi ed è descritto nel documento di panoramica arXiv:2506.10052.
Scelte di progettazione chiave
Ciclo di vita delle risorse, non compilazione dei circuiti. QRMI gestisce il ciclo di vita di acquisizione/invio/polling/rilascio e nient'altro. La compilazione, l'ottimizzazione e la transpilazione dei circuiti rimangono nel livello applicativo (per esempio, Qiskit). Questo mantiene l'interfaccia minimale e componibile.
Modello di portabilità tra fornitori. Sebbene QRMI fornisca chiamate comuni di gestione dei job (acquire, task_start, task_status, task_result, release) tra i backend hardware supportati, cambiare fornitore richiede anche pass di compilazione diversi, la costruzione di payload specifici per il fornitore e la decodifica dei risultati nel livello applicativo.
Formato di payload nativo IBM. Per i backend IBM Quantum, QRMI utilizza payload JSON OpenQASM 3 (QiskitPrimitive) conformi allo schema Qiskit Runtime.
Configurazione tramite variabili d'ambiente. Le credenziali e gli URL degli endpoint vengono letti dalle variabili d'ambiente in fase di esecuzione. In un cluster HPC, il plugin SPANK QRMI di Slurm le imposta automaticamente quando un job viene inviato. In un notebook o in una sessione interattiva, le carichi da un file .env. Il codice dell'applicazione non contiene mai credenziali o URL degli endpoint codificati direttamente.
Integrazione dello scheduler HPC tramite GRES. Quando un job Slurm richiede risorse quantistiche utilizzando l'interfaccia del plugin SPANK QRMI (#SBATCH --gres=qpu:1 e #SBATCH --qpu=ibm_kingston), il plugin inietta QRMI_JOB_QPU_RESOURCES e QRMI_JOB_QPU_TYPES nell'ambiente del job. Le applicazioni chiamano get_job_qpu_resources_and_types() per scoprire quali risorse sono state allocate — senza bisogno di nomi di backend codificati direttamente. QRMIService racchiude questo schema per gli utenti Qiskit.
Le chiamate API principali
| Chiamata | Scopo |
|---|---|
qrmi.acquire() | Acquisisce l'accesso alla risorsa (per esempio, apre una sessione dedicata); restituisce un token di blocco |
qrmi.target() | Recupera le capacità del backend (qubit, gate, mappa di accoppiamento) come JSON |
qrmi.task_start(payload) | Invia un job quantistico; restituisce un ID job |
qrmi.task_status(job_id) | Effettua il polling dello stato del job (Queued, Running, Completed, Failed) |
qrmi.task_result(job_id) | Recupera i risultati del job completato come stringa JSON grezza |
qrmi.task_stop(job_id) | Annulla o pulisce un job |
qrmi.release(lock) | Rilascia il blocco della risorsa (per esempio, chiude la sessione) |
Cosa copre questo tutorial
Questo tutorial è strutturato in due parti:
Passaggi 1–3 (esempi su piccola scala): Introducono l'API QRMI con una semplice dimostrazione di circuito a stato di Bell su hardware IBM Quantum, coprendo sia l'uso diretto delle primitive a basso livello sia l'integrazione ad alto livello di QRMIService e SamplerV2.
Esempio hardware su larga scala: Un flusso di lavoro SQD completo per la molecola N a una distanza di legame di 1.0 (spazio attivo della base cc-pVDZ, 26 orbitali spaziali / 52 qubit), eseguito su hardware IBM Quantum tramite QRMI. SQD combina il campionamento quantistico di un ansatz LUCJ costruito con ffsim e il recupero di configurazione autoconsistente con qiskit-addon-sqd.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"dotenv": "python-dotenv", "ffsim": "ffsim", "matplotlib": "matplotlib", "numpy": "numpy", "pyscf": "pyscf", "qiskit": "qiskit", "qiskit_addon_sqd": "qiskit-addon-sqd", "qrmi": "qrmi"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
Requisiti
Prima di iniziare questo tutorial, assicurati di avere installato quanto segue.
Configurazione dell'ambiente Python
Le wheel binarie precompilate sono disponibili per Linux su PyPI, quindi il comando standard pip install funziona direttamente sui sistemi Linux/HPC.
python3 -m venv ~/.venvs/qrmi-ibm
source ~/.venvs/qrmi-ibm/bin/activate
python -m pip install "qrmi[ibm]" python-dotenv pyscf ffsim qiskit-addon-sqd matplotlib ipykernel
python -m ipykernel install --user --name qrmi-ibm --display-name "QRMI IBM"
Se pip compila QRMI dal codice sorgente, assicurati di avere una toolchain Rust moderna (Rust ≥ 1.91.1 installata tramite rustup da rustup.rs).
Seleziona il kernel QRMI IBM in Jupyter, quindi riavvialo ed esegui le celle del notebook in ordine. Gli output salvati provengono dall'esecuzione hardware del contributore; i comandi di installazione non specificano le versioni esatte utilizzate per quella esecuzione.
Credenziali richieste
- IBM Quantum: chiave API IAM e Service CRN da IBM Quantum Platform
Per l'esecuzione standalone, crea un file .env accanto a questo notebook con i seguenti valori, sostituendo i segnaposto delle credenziali. Mantieni questo file privato. Se selezioni un backend diverso, aggiorna sia il suo nome sia i prefissi delle variabili d'ambiente.
ibm_kingston_QRMI_IBM_QCS_ENDPOINT=https://quantum.cloud.ibm.com/api/v1
ibm_kingston_QRMI_IBM_QCS_IAM_ENDPOINT=https://iam.cloud.ibm.com
ibm_kingston_QRMI_IBM_QCS_IAM_APIKEY=<your-iam-api-key>
ibm_kingston_QRMI_IBM_QCS_SERVICE_CRN=<your-crn-starting-with-crn:v1:>
ibm_kingston_QRMI_IBM_QCS_SESSION_MODE=dedicated
ibm_kingston_QRMI_IBM_QCS_SESSION_MAX_TTL=28800
QRMI_JOB_QPU_RESOURCES=ibm_kingston
QRMI_JOB_QPU_TYPES=ibm-quantum-compute-service
Per un'allocazione Slurm, utilizza le impostazioni delle risorse e le credenziali fornite dal cluster. Il notebook preserva i valori d'ambiente esistenti.
Configurazione
Importa le dipendenze e carica la configurazione delle risorse.
import os
import time
import json
import numpy as np
from dotenv import load_dotenv

from qrmi import (
    QuantumResource,
    ResourceType,
    Payload,
    TaskStatus,
    get_job_qpu_resources_and_types,
)
from qrmi.primitives import QRMIService
from qrmi.primitives.ibm import SamplerV2, get_target

from qiskit import QuantumCircuit, qasm3
from qiskit.circuit.library import efficient_su2
from qiskit.primitives.containers.sampler_pub import SamplerPub
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# Load credentials from .env without overriding already-set scheduler environment variables
load_dotenv(override=False)

# Preserve resources if injected by Slurm SPANK plugin; fallback to default for interactive run
BACKEND_NAME = os.environ.get("QRMI_JOB_QPU_RESOURCES", "ibm_kingston")
os.environ.setdefault("QRMI_JOB_QPU_RESOURCES", BACKEND_NAME)
os.environ.setdefault("QRMI_JOB_QPU_TYPES", "ibm-quantum-compute-service")

print(f"Backend: {BACKEND_NAME}")
print("Environment ready.")
Backend: ibm_kingston
Environment ready.
Esempi su piccola scala
I passaggi 1–3 introducono l'API QRMI utilizzando circuiti semplici. Ogni passaggio corrisponde a una fase principale del ciclo di vita di QRMI su hardware IBM Quantum.
Il payload per questi passaggi iniziali è un piccolo circuito a stato di Bell scelto per essere veloce ed economico da eseguire.
Questi esempi utilizzano l'hardware perché dimostrano l'allocazione remota delle risorse e la gestione dei job. Un simulatore di circuiti locale non convalida il servizio QRMI e l'integrazione dello scheduler. Eseguire questo notebook invia job IBM Quantum e richiede l'accesso al backend configurato.
Passaggio 1: mappare il problema classico su una risorsa quantistica
Il primo passaggio in qualsiasi flusso di lavoro QRMI è creare un oggetto QuantumResource e verificare che sia accessibile.
get_target() recupera la descrizione hardware del backend (numero di qubit, gate di base, mappa di accoppiamento) e la impacchetta come oggetto Qiskit Target, che il transpiler utilizza nel Passaggio 2.
Passaggio 2: ottimizzare il problema per l'esecuzione su hardware quantistico
Prima dell'invio, utilizza Qiskit per transpilare il circuito nell'architettura del set di istruzioni (ISA) del backend, utilizzando l'oggetto Target recuperato nel Passaggio 1.
L'esempio quindi costruisce un Payload.QiskitPrimitive, che racchiude la stringa del circuito OpenQASM 3 e i metadati del job nello schema delle primitive IBM.
Passaggio 3: eseguire utilizzando le primitive QRMI
Con il payload costruito, l'esempio invia il job ed effettua il polling fino al completamento. task_start() restituisce immediatamente un ID job; task_status() viene interrogato finché lo stato non è più Queued/Running. I risultati vengono recuperati come stringa JSON grezza e analizzati per estrarre i campioni di misura.
La cella seguente mantiene insieme acquisizione, esecuzione e pulizia in modo che eventuali errori dopo l'acquisizione rilascino comunque una sessione di proprietà del notebook.
# ── IBM Quantum ───────────────────────────────────────────────────────
qrmi = QuantumResource(BACKEND_NAME, ResourceType.IBMQuantumComputeService)
# ResourceType.IBMQuantumSystem is the alternative for directly provisioned systems

print(f"Resource id:   {qrmi.resource_id()}")
print(f"Resource type: {qrmi.resource_type()}")
print(f"Accessible:    {qrmi.is_accessible()}")

# Acquire exclusive access — open try/finally immediately so every
# subsequent failure (target retrieval, transpilation, submission) is covered.
# Release is skipped when running under Slurm: the SPANK plugin owns the
# session lifecycle and will release it when the job finishes.
lock = qrmi.acquire()
print(f"Lock token:    {lock}")
try:
    # Retrieve backend capabilities
    transpiler_target = get_target(
        qrmi
    )  # calls qrmi.target() and parses the JSON
    target_json = json.loads(qrmi.target().value)
    config = target_json.get("configuration", {})
    print(f"\nBackend: {config.get('backend_name', 'unknown')}")
    print(f"Qubits:  {config.get('n_qubits', 'unknown')}")
    print(f"Gates:   {config.get('basis_gates', [])}")

    # ── IBM Quantum ───────────────────────────────────────────────────

    # Build a Bell state circuit
    qc = QuantumCircuit(2)
    qc.h(0)
    qc.cx(0, 1)
    qc.measure_all()
    print(qc.draw("text"))

    # Transpile to ISA using the target retrieved in Step 1
    pm = generate_preset_pass_manager(
        optimization_level=1, target=transpiler_target
    )
    isa_circuit = pm.run(qc)
    print(f"\nTranspiled gate counts: {isa_circuit.count_ops()}")

    # Build the QRMI payload
    # Payload.QiskitPrimitive wraps the IBM SamplerV2 input schema:
    #   pubs: list of [qasm3_string, parameter_values]  (shots goes at top level)
    #   program_id: "sampler" or "estimator"
    shots = 1024
    pub = SamplerPub.coerce((isa_circuit,), shots)
    qasm3_str = qasm3.dumps(
        pub.circuit,
        disable_constants=True,
        allow_aliasing=True,
        experimental=qasm3.ExperimentalFeatures.SWITCH_CASE_V1,
    )
    # Parameter values as a flat list (empty for non-parametric circuits)
    param_array = pub.parameter_values.as_array(
        pub.circuit.parameters
    ).tolist()

    input_json = {
        "pubs": [
            [qasm3_str, param_array]
        ],  # list-of-lists; shots at top level
        "version": 2,
        "support_qiskit": False,  # True returns binary-encoded Qiskit result
        "shots": shots,
    }
    payload = Payload.QiskitPrimitive(
        input=json.dumps(input_json), program_id="sampler"
    )
    print("Payload ready")

    # ── IBM Quantum ───────────────────────────────────────────────────

    # Submit the job
    job_id = qrmi.task_start(payload)
    print(f"Job submitted: {job_id}")

    # Poll until complete
    while True:
        status = qrmi.task_status(job_id)
        print(f"  Status: {status}")
        if status not in [TaskStatus.Running, TaskStatus.Queued]:
            break
        time.sleep(5)

    print(f"\nFinal status: {status}")

    # Retrieve results
    # support_qiskit=False → plain JSON; parse directly without ResultDecoder
    if status == TaskStatus.Completed:
        raw = qrmi.task_result(job_id).value
        result = json.loads(raw)
        # IBM QCS plain-JSON result shape: {"results": [{"data": {"meas": {"samples": [...]}}}]}
        # samples is a list of hex-encoded integers; decode to zero-padded bitstrings
        samples = result["results"][0]["data"]["meas"]["samples"]
        num_bits = sum(reg.size for reg in isa_circuit.cregs)
        from collections import Counter

        counts = Counter(format(int(s, 16), f"0{num_bits}b") for s in samples)
        print(f"\nMeasurement counts: {dict(counts.most_common(8))}")
        qrmi.task_stop(job_id)
    else:
        print(f"Job did not complete. Logs:\n{qrmi.task_logs(job_id)}")

finally:
    # Release only in interactive sessions; under Slurm the SPANK plugin
    # manages the session lifecycle and calling release() here would
    # prematurely close a session it does not own.
    if not os.environ.get("SLURM_JOB_ID"):
        qrmi.release(lock)
        print("\nSession released.")
Resource id:   ibm_kingston
Resource type: ResourceType.IBMQuantumComputeService
Accessible:    True
Lock token:    2ff43011-aed1-4436-a4df-40f37ec588b7

Backend: ibm_kingston
Qubits:  156
Gates:   ['cz', 'id', 'rx', 'rz', 'rzz', 'sx', 'x', 'xslow']
        ┌───┐      ░ ┌─┐
   q_0: ┤ H ├──■───░─┤M├───
        └───┘┌─┴─┐ ░ └╥┘┌─┐
   q_1: ─────┤ X ├─░──╫─┤M├
             └───┘ ░  ║ └╥┘
meas: 2/══════════════╩══╩═
                      0  1

Transpiled gate counts: OrderedDict([('rz', 6), ('sx', 3), ('measure', 2), ('cz', 1), ('barrier', 1)])
Payload ready
Job submitted: dai43g8mhr3c73e7a7o0
  Status: TaskStatus.Queued
  Status: TaskStatus.Running
  Status: TaskStatus.Completed

Final status: TaskStatus.Completed

Measurement counts: {'11': 487, '00': 254, '01': 177, '10': 106}

Session released.
Interfaccia Qiskit di livello superiore: QRMIService e SamplerV2
Il ciclo di vita grezzo sopra descritto fornisce un controllo esplicito su ogni chiamata. Per i flussi di lavoro Qiskit standard, QRMI fornisce una primitiva SamplerV2 che implementa BaseSamplerV2.
SamplerV2 gestisce la serializzazione del payload, l'invio (task_start), il polling e la decodifica dei risultati. In un contesto batch HPC (per esempio, con Slurm), l'allocazione e il rilascio sono gestiti dallo scheduler e dal plugin SPANK. In una sessione Python interattiva che utilizza direttamente oggetti API di basso livello, acquire() e release() possono essere utilizzati per gestire esplicitamente sessioni dedicate.
# QRMIService reads QRMI_JOB_QPU_RESOURCES / QRMI_JOB_QPU_TYPES set in Setup or Slurm
service = QRMIService()
qrmi_svc = service.resources()[0]
print(f"Using: {qrmi_svc.resource_id()} ({qrmi_svc.resource_type()})")

# Build an EfficientSU2 circuit
circuit = efficient_su2(5, entanglement="linear")
circuit.measure_all()
param_values = np.random.rand(circuit.num_parameters)

pm = generate_preset_pass_manager(
    optimization_level=1, target=get_target(qrmi_svc)
)
isa_circuit = pm.run(circuit)

# SamplerV2 executes jobs against the QRMI resource and decodes results into primitive containers
sampler = SamplerV2(qrmi_svc, options={"default_shots": 1024})
job = sampler.run([(isa_circuit, param_values)])
print(f"Job ID: {job.job_id()} | Status: {job.status()}")

# Poll with retry — re-raise immediately on permanent failures;
# only retry on transient network/timeout errors (connection resets, 503s).
_TRANSIENT = (
    "503",
    "Service Unavailable",
    "ConnectionError",
    "TimeoutError",
    "timed out",
    "Connection reset",
)
result = None
for attempt in range(60):
    try:
        result = job.result()  # blocks until complete
        break
    except Exception as e:
        if not any(tok in str(e) for tok in _TRANSIENT):
            raise
        print(f"  Transient error on attempt {attempt + 1}: {e}")
        time.sleep(10)

if result is not None:
    counts = result[0].data.meas.get_counts()
    print(f"Counts (first 5): {dict(list(counts.items())[:5])}")
else:
    print("Job did not complete after retries.")

if job.errored():
    print(f"Logs:\n{job.logs()}")
Using: ibm_kingston (ResourceType.IBMQuantumComputeService)
Job ID: dai43jj9k43c73afhrhg | Status: JobStatus.QUEUED
Counts (first 5): {'00010': 66, '00100': 28, '11000': 71, '00110': 23, '10100': 14}
Contesto HPC: iniezione delle risorse Slurm
In un cluster HPC, gli utenti richiedono risorse quantistiche utilizzando la sintassi GRES di Slurm insieme alle opzioni del plugin SPANK QRMI. Il plugin gestisce automaticamente l'iniezione delle credenziali e delle risorse:
#SBATCH --gres=qpu:1
#SBATCH --qpu=ibm_kingston
python my_workflow.py   # QRMI_JOB_QPU_RESOURCES and QRMI_JOB_QPU_TYPES are already set
Il codice dell'applicazione scopre le risorse allocate in fase di esecuzione — senza nomi di backend codificati direttamente:
# get_job_qpu_resources_and_types() reads QRMI_JOB_QPU_RESOURCES / QRMI_JOB_QPU_TYPES
# set by the Slurm SPANK plugin (or manually above in Setup)
qpus, qpu_types = get_job_qpu_resources_and_types()
print("Resources allocated by scheduler:")
for qpu, qpu_type in zip(qpus, qpu_types):
    print(f"  {qpu}  ({qpu_type})")

# QRMIService wraps this into a list of ready QuantumResource objects
for r in QRMIService().resources():
    print(
        f"\nQRMIService found: {r.resource_id()}  accessible={r.is_accessible()}"
    )
Resources allocated by scheduler:
  ibm_kingston  (ibm-quantum-compute-service)

QRMIService found: ibm_kingston  accessible=True
Esempio hardware su larga scala: SQD su N
Qui mettiamo insieme tutti i componenti in un flusso di lavoro completo di chimica quantistica su scala più ampia, eseguito su hardware IBM Quantum reale tramite QRMI.
SQD combina quanto segue:
- Campionamento quantistico di un ansatz Local Unitary Cluster Jastrow (LUCJ) costruito utilizzando
ffsime inizializzato a partire dalle ampiezze CCSD - Transpilazione consapevole dell'hardware che corrisponde alla topologia del reticolo heavy-hex tramite
generate_lucj_pass_manager - Esecuzione del campionamento su hardware IBM Quantum gestito tramite
QRMIServicee QRMISamplerV2 - Post-elaborazione classica: recupero di configurazione autoconsistente e diagonalizzazione iterativa del sottospazio utilizzando
qiskit-addon-sqd
Applichiamo SQD a N a una distanza di legame di 1.0 con uno spazio attivo derivato dal set di base cc-pVDZ (26 orbitali spaziali, corrispondenti a 52 spin-orbitali/qubit).
Energia di riferimento per lo spazio attivo N /cc-pVDZ (distanza di legame 1.0 ):
- Energia di riferimento (calcolo SCI separato): −109.22802922 Ha
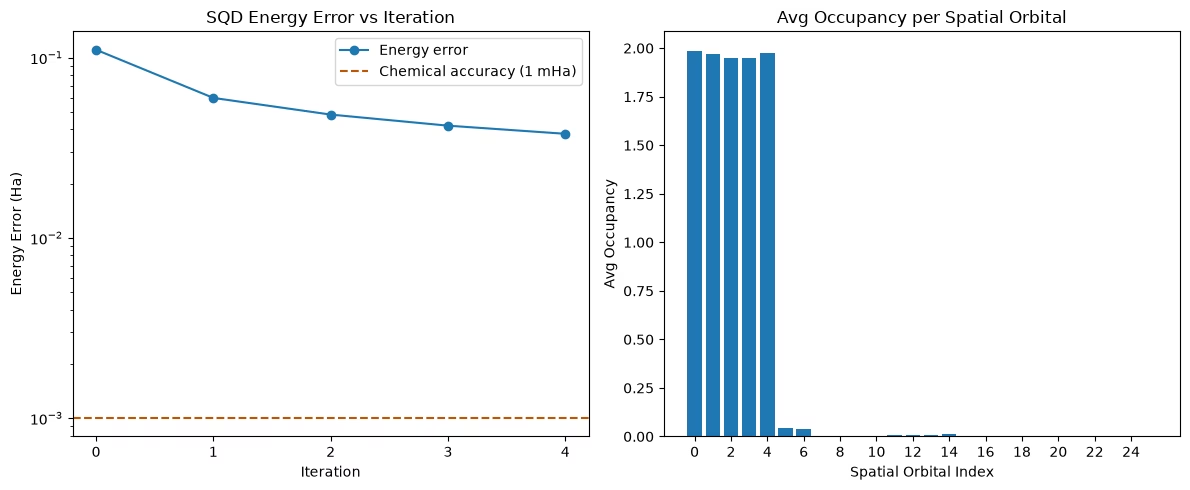
L'esecuzione SQD riportata di seguito dimostra un'esecuzione end-to-end riuscita di QRMI su hardware IBM Quantum. Con una singola ripetizione LUCJ e 100.000 shot, il risultato si attesta a circa 23,7 kcal/mol al di sopra dell'energia di riferimento e non raggiunge l'accuratezza chimica (≤ 1 kcal/mol). Modificare n_reps, il numero di shot o il numero di iterazioni SQD potrebbe migliorare l'accuratezza, ma richiede ulteriori test.
Nell'esecuzione salvata, il pass manager ffsim ha rimosso le interazioni a spin opposto (24, 24) e (20, 20) perché il backend non poteva gestirle. I risultati riportati utilizzano questo circuito modificato.
from qrmi.primitives.ibm import get_backend
import math
import os
import time
from functools import partial
from dotenv import load_dotenv
import numpy as np
import matplotlib.pyplot as plt

import pyscf
import pyscf.gto
import pyscf.scf
import pyscf.cc
import pyscf.mcscf
import pyscf.ao2mo

import ffsim
import ffsim.qiskit
from qiskit import QuantumCircuit, QuantumRegister
from qiskit_addon_sqd.fermion import (
    SCIResult,
    diagonalize_fermionic_hamiltonian,
    solve_sci_batch,
)
from qrmi.primitives import QRMIService
from qrmi.primitives.ibm import SamplerV2, get_target

load_dotenv(override=False)
os.environ.setdefault("QRMI_JOB_QPU_RESOURCES", "ibm_kingston")
os.environ.setdefault("QRMI_JOB_QPU_TYPES", "ibm-quantum-compute-service")

# ── Step 1: Map classical inputs to a quantum problem ─────────────────

# Build N2 molecule at 1.0 Å bond distance
mol = pyscf.gto.Mole()
mol.build(
    atom=[["N", (0, 0, 0)], ["N", (1.0, 0, 0)]],
    basis="cc-pvdz",
    symmetry="Dooh",
)

# Define active space: freeze 2 core orbitals
n_frozen = 2
active_space = range(n_frozen, mol.nao_nr())

# Get molecular integrals
scf = pyscf.scf.RHF(mol).run()
norb = len(active_space)
n_electrons = int(sum(scf.mo_occ[active_space]))
n_alpha = (n_electrons + mol.spin) // 2
n_beta = (n_electrons - mol.spin) // 2
nelec = (n_alpha, n_beta)

cas = pyscf.mcscf.CASCI(scf, norb, nelec)
mo = cas.sort_mo(active_space, base=0)
hcore, nuclear_repulsion_energy = cas.get_h1cas(mo)
eri = pyscf.ao2mo.restore(1, cas.get_h2cas(mo), norb)

# Reference energy from external SCI calculation
reference_energy = -109.22802921665716

print(
    f"N₂/cc-pVDZ active space: {norb} orbitals ({2 * norb} qubits), {nelec} electrons"
)
print(f"SCF energy:       {scf.e_tot:.8f} Ha")
print(f"Reference energy: {reference_energy:.8f} Ha")

# Get CCSD amplitudes for initializing the LUCJ ansatz
ccsd = pyscf.cc.CCSD(
    scf, frozen=[i for i in range(mol.nao_nr()) if i not in active_space]
).run()
t1 = ccsd.t1
t2 = ccsd.t2
print(f"CCSD energy:      {ccsd.e_tot:.8f} Ha")

# Discover backend via QRMIService (QRMI_JOB_QPU_RESOURCES set in Setup)
service = QRMIService()
qrmi_sqd = service.resources()[0]
print(f"Using QRMI resource: {qrmi_sqd.resource_id()}")

# get_backend() wraps the QRMI resource as a Qiskit backend for layout synthesis

backend = get_backend(qrmi_sqd)

# Set ansatz properties
n_reps = 1
pairs_aa = [(p, p + 1) for p in range(norb - 1)]
pairs_ab = None

# Create pass manager adapted to hardware heavy-hex topology
pass_manager, pairs_ab = ffsim.qiskit.generate_lucj_pass_manager(
    backend=backend,
    norb=norb,
    connectivity="heavy-hex",
    interaction_pairs=(pairs_aa, pairs_ab),
    optimization_level=3,
)

# Create the compressed LUCJ ansatz operator
ucj_op = ffsim.UCJOpSpinBalanced.from_t_amplitudes(
    t2=t2,
    t1=t1,
    n_reps=n_reps,
    interaction_pairs=(pairs_aa, pairs_ab),
    optimize=True,
    options=dict(maxiter=1000),
)

# Assemble the circuit
qubits = QuantumRegister(2 * norb, name="q")
circuit = QuantumCircuit(qubits)
circuit.append(ffsim.qiskit.PrepareHartreeFockJW(norb, nelec), qubits)
circuit.append(ffsim.qiskit.UCJOpSpinBalancedJW(ucj_op), qubits)
circuit.measure_all()
print(f"LUCJ circuit: {circuit.num_qubits} qubits, depth {circuit.depth()}")

# ── Step 2: Optimize for quantum hardware execution ───────────────────

isa_circuit = pass_manager.run(circuit)
print(f"Transpiled gate counts: {isa_circuit.count_ops()}")

# ── Step 3: Execute using Qiskit primitives (QRMI SamplerV2) ─────────

sampler = SamplerV2(qrmi_sqd, options={"default_shots": 100_000})
# sampler.options.environment.job_tags = ["TUT_SQD"]
job = sampler.run([(isa_circuit,)])
print(f"Job submitted via QRMI: {job.job_id()} | Status: {job.status()}")
print("Waiting for results from hardware...")

_TRANSIENT = (
    "503",
    "Service Unavailable",
    "ConnectionError",
    "TimeoutError",
    "timed out",
    "Connection reset",
)
primitive_result = None
for attempt in range(120):
    try:
        primitive_result = job.result()
        break
    except Exception as e:
        if not any(tok in str(e) for tok in _TRANSIENT):
            raise
        print(f"  Transient error on attempt {attempt + 1}: {e}")
        time.sleep(10)

if primitive_result is None:
    raise RuntimeError("Job did not complete after retries")

pub_result = primitive_result[0]
bit_array = pub_result.data.meas
print(f"Total shots collected: {bit_array.num_shots}")

# ── Step 4: Post-process and return result in classical format ────────

def is_valid_bitstring(
    bitstring: str, norb: int, nelec: tuple[int, int]
) -> bool:
    n_a, n_b = nelec
    return (
        len(bitstring) == 2 * norb
        and bitstring[norb:].count("1") == n_a
        and bitstring[:norb].count("1") == n_b
    )

num_valid = sum(
    is_valid_bitstring(b, norb, nelec) for b in bit_array.get_bitstrings()
)
valid_fraction = num_valid / bit_array.num_shots
expected_random = (
    math.comb(norb, n_alpha) * math.comb(norb, n_beta) / (2 ** (2 * norb))
)
print(f"Fraction of valid configurations sampled: {valid_fraction:.5f}")
print(f"Expected fraction from uniform random:     {expected_random:.4e}")

# Configure SQD eigensolver
energy_tol = 1e-3
occupancies_tol = 1e-3
max_iterations = 5
num_batches = 3
samples_per_batch = 300
symmetrize_spin = True
carryover_threshold = 1e-4
max_cycle = 200

# Hartree-Fock initial occupancy guess
initial_occupancies = (
    np.array([1] * n_alpha + [0] * (norb - n_alpha)),
    np.array([1] * n_beta + [0] * (norb - n_beta)),
)

sci_solver = partial(solve_sci_batch, spin_sq=0.0, max_cycle=max_cycle)
result_history = []

def callback(results: list[SCIResult]):
    result_history.append(results)
    iteration = len(result_history)
    print(f"Iteration {iteration}")
    for i, res in enumerate(results):
        subspace_dim = np.prod(res.sci_state.amplitudes.shape)
        print(
            f"  Subsample {i}: Energy = {res.energy + nuclear_repulsion_energy:.8f} Ha | Subspace dim = {subspace_dim}"
        )

print("\nRunning SQD post-processing...")
rng = np.random.default_rng(42)
sqd_result = diagonalize_fermionic_hamiltonian(
    hcore,
    eri,
    bit_array,
    samples_per_batch=samples_per_batch,
    norb=norb,
    nelec=nelec,
    num_batches=num_batches,
    energy_tol=energy_tol,
    occupancies_tol=occupancies_tol,
    max_iterations=max_iterations,
    sci_solver=sci_solver,
    symmetrize_spin=symmetrize_spin,
    initial_occupancies=initial_occupancies,
    carryover_threshold=carryover_threshold,
    callback=callback,
    seed=rng,
)

final_energy = sqd_result.energy + nuclear_repulsion_energy
energy_error = final_energy - reference_energy

print("\n=== Energy Summary (N₂/cc-pVDZ active space) ===")
print(f"SCF energy:       {scf.e_tot:.8f} Ha")
print(f"Reference energy: {reference_energy:.8f} Ha")
print(f"Final SQD energy: {final_energy:.8f} Ha")
print(
    f"Energy error:     {energy_error:.8f} Ha ({abs(energy_error) * 627.5:.4f} kcal/mol)"
)

# ── Visualization ─────────────────────────────────────────────────────

x1 = range(len(result_history))
min_e = [
    min(res, key=lambda r: r.energy).energy + nuclear_repulsion_energy
    for res in result_history
]
e_diff = [abs(e - reference_energy) for e in min_e]
chem_accuracy = 0.001  # ~1 mHa / ~0.6 kcal/mol

y2 = np.sum(sqd_result.orbital_occupancies, axis=0)
x2 = range(len(y2))

fig, axs = plt.subplots(1, 2, figsize=(12, 5))

# Energies convergence plot
axs[0].plot(x1, e_diff, label="Energy error", marker="o")
axs[0].set_xticks(list(x1))
axs[0].set_xticklabels(list(x1))
axs[0].set_yscale("log")
axs[0].axhline(
    y=chem_accuracy,
    color="#BF5700",
    linestyle="--",
    label="Chemical accuracy (1 mHa)",
)
axs[0].set_title("SQD Energy Error vs Iteration")
axs[0].set_xlabel("Iteration")
axs[0].set_ylabel("Energy Error (Ha)")
axs[0].legend()

# Spatial orbital occupancy plot
axs[1].bar(x2, y2, width=0.8)
axs[1].set_xticks(list(x2)[::2])
axs[1].set_xticklabels(list(x2)[::2])
axs[1].set_title("Avg Occupancy per Spatial Orbital")
axs[1].set_xlabel("Spatial Orbital Index")
axs[1].set_ylabel("Avg Occupancy")

plt.tight_layout()
plt.show()
WARN: Unable to to identify input symmetry using original axes.
Different symmetry axes will be used.

converged SCF energy = -108.929838385609
N₂/cc-pVDZ active space: 26 orbitals (52 qubits), (5, 5) electrons
SCF energy:       -108.92983839 Ha
Reference energy: -109.22802922 Ha
E(CCSD) = -109.2177884185545  E_corr = -0.2879500329450047
CCSD energy:      -109.21778842 Ha
Using QRMI resource: ibm_kingston
LUCJ circuit: 52 qubits, depth 3
Transpiled gate counts: OrderedDict([('sx', 7041), ('rz', 6969), ('cz', 1858), ('measure', 52), ('x', 47), ('barrier', 1)])
Job submitted via QRMI: dai43o0mhr3c73e7a81g | Status: JobStatus.QUEUED
Waiting for results from hardware...
Total shots collected: 100000
Fraction of valid configurations sampled: 0.00319
Expected fraction from uniform random:     9.6079e-07

Running SQD post-processing...
Iteration 1
  Subsample 0: Energy = -109.09341960 Ha | Subspace dim = 208849
  Subsample 1: Energy = -109.11738590 Ha | Subspace dim = 204304
  Subsample 2: Energy = -109.09947704 Ha | Subspace dim = 212521
Iteration 2
  Subsample 0: Energy = -109.16015998 Ha | Subspace dim = 332929
  Subsample 1: Energy = -109.16823702 Ha | Subspace dim = 319225
  Subsample 2: Energy = -109.16189785 Ha | Subspace dim = 336400
Iteration 3
  Subsample 0: Energy = -109.17759299 Ha | Subspace dim = 471969
  Subsample 1: Energy = -109.17937442 Ha | Subspace dim = 512656
  Subsample 2: Energy = -109.17970409 Ha | Subspace dim = 504100
Iteration 4
  Subsample 0: Energy = -109.18410905 Ha | Subspace dim = 608400
  Subsample 1: Energy = -109.18265405 Ha | Subspace dim = 636804
  Subsample 2: Energy = -109.18608430 Ha | Subspace dim = 657721
Iteration 5
  Subsample 0: Energy = -109.18870837 Ha | Subspace dim = 846400
  Subsample 1: Energy = -109.18890818 Ha | Subspace dim = 848241
  Subsample 2: Energy = -109.19022232 Ha | Subspace dim = 804609

=== Energy Summary (N₂/cc-pVDZ active space) ===
SCF energy:       -108.92983839 Ha
Reference energy: -109.22802922 Ha
Final SQD energy: -109.19022232 Ha
Energy error:     0.03780690 Ha (23.7238 kcal/mol)
Prossimi passi
Se hai trovato interessante questo lavoro, potrebbe interessarti il seguente materiale:
-
Tutorial sulla diagonalizzazione quantistica basata su campionamento — il flusso di lavoro completo di chimica SQD su IBM Quantum Platform, comprese molecole e set di base più grandi
-
Diagonalizzazione quantistica di Krylov basata su campionamento — un metodo correlato che utilizza circuiti di evoluzione temporale per modelli reticolari fermionici
-
Documentazione di
qiskit-addon-sqd— riferimento completo dell'API e tutorial aggiuntivi per la libreria di post-elaborazione SQD -
Repository GitHub di QRMI — codice sorgente, esempi aggiuntivi di backend (CUDA-Q, C, Lua)
-
Documento di panoramica QRMI — descrizione tecnica dell'architettura QRMI e dell'integrazione HPC
-
Guida alle sessioni di IBM Quantum Compute Service — come le sessioni si relazionano al ciclo di vita
acquire/releasedi QRMI per i backend IBM