Workflow moderni
Questo corso ha trattato un'ampia varietà di metodi per gestire il rumore e gli errori quantistici. Abbiamo evitato intenzionalmente alcune soluzioni black-box per poter vedere come funzionano questi metodi. Ora siamo pronti a usare questi metodi nella loro forma più moderna. In particolare, esploriamo alcuni strumenti di gestione degli errori altamente ottimizzati che nascondono parte della complessità. Esploriamo anche Samplomatic e addon come i shaded lightcones (SLC), che ci danno un controllo molto fine su determinati processi di mitigazione.
In questo video, il Dr. Chris Porter offre una panoramica di questi strumenti moderni. Prevediamo di aggiungere workflow di esempio a questa lezione in un secondo momento. Tuttavia, questa lezione contiene già tutte le informazioni necessarie per usare questi strumenti e superare l'esame per il badge.
Panoramica
Le prime primitive di IBM Quantum, come Estimator e Sampler, esponevano la mitigazione degli errori tramite un piccolo numero di livelli predefiniti. Le versioni successive hanno fornito un controllo più diretto sulle singole tecniche, incluse le scelte della strategia di zero-noise extrapolation, delle configurazioni di Pauli twirling e dei parametri di randomizzazione. Tuttavia, queste impostazioni sono rimaste in gran parte globali e applicate in modo uniforme all'intero circuito.
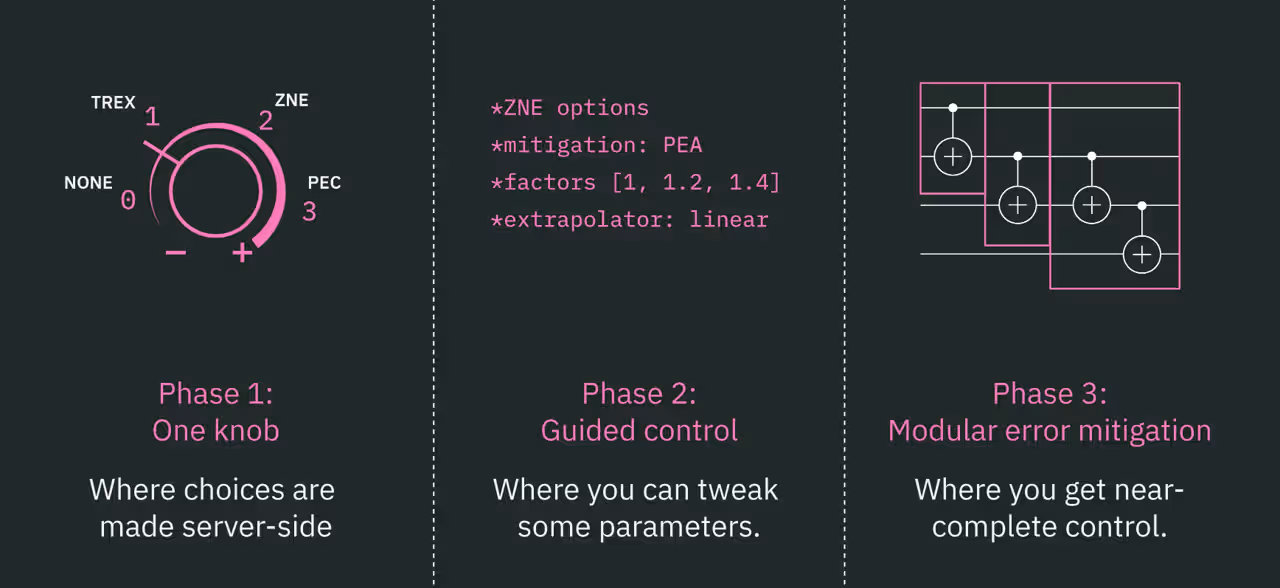
Man mano che i carichi di lavoro quantistici diventano più sofisticati, gli sviluppatori hanno sempre più bisogno di poter adattare le strategie di esecuzione e mitigazione a regioni specifiche di un circuito. Il diagramma seguente illustra alcuni strumenti chiave trattati in questa lezione e mostra dove si inseriscono in un tipico workflow.
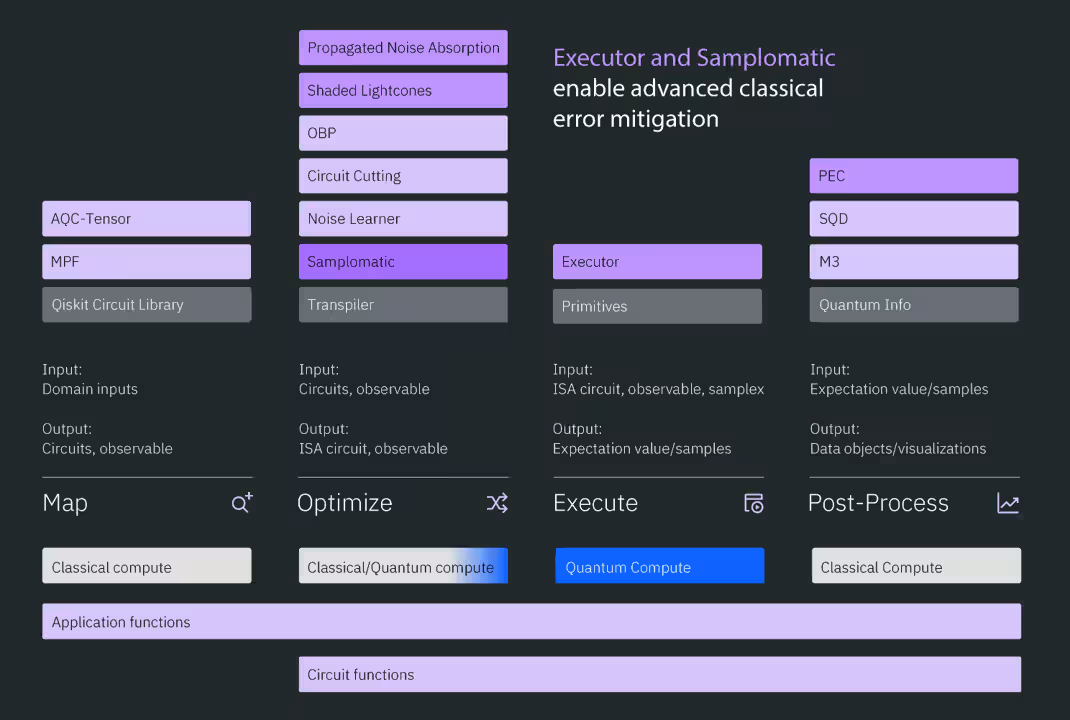
Il modello di esecuzione diretta risponde all'esigenza di un controllo modulare dell'esecuzione e integra molti di questi strumenti.
Modello di esecuzione diretta
Invece di prendere decisioni di esecuzione implicite, il modello di esecuzione diretta segue direttive fornite dall'utente. Questo approccio migliora la trasparenza e rende i workflow complessi più facili da ispezionare e da debuggare. Alcune caratteristiche chiave di questo modello includono:
-
Configurazione per layer tramite regioni etichettate del circuito
-
Identificazione di layer unici e ripetuti per un apprendimento efficiente del rumore
-
Workflow di esecuzione in batch
-
Post-elaborazione strutturata
-
Stretta integrazione con addon come i shaded lightcones
Il modello è costruito attorno a due componenti chiave:
-
Samplomatic, che definisce le ricette di esecuzione
-
Executor, che esegue tali ricette e restituisce i campioni
La maggior parte dei workflow che usano Executor può essere implementata anche con Sampler, perché entrambi producono in ultima analisi campioni. Il vantaggio chiave di Executor è l'efficienza. Attività come la generazione di configurazioni di twirling sono spesso molto più veloci nell'ambiente near-time lato server che sul client. Estimator e Sampler restano supportati e potrebbero comunque essere la scelta più comoda per molti carichi di lavoro.
Prima dell'esecuzione, tuttavia, devi costruire e preparare un circuito. Qiskit fornisce diversi addon che aiutano nella generazione, simulazione e ottimizzazione dei circuiti. Per maggiori informazioni su uno qualsiasi degli strumenti seguenti, segui i link.
Costruire circuiti quantistici
Per alcune applicazioni o nuovi approcci, gli utenti devono stabilire come mappare il proprio problema su un circuito quantistico. In molti ambiti, tuttavia, gli addon di Qiskit possono automatizzare parti importanti di questo processo.
Optimization mapper
Optimization mapper aiuta a esprimere problemi di ottimizzazione classici in forme adatte agli algoritmi quantistici. Le funzionalità principali includono:
-
Costruire funzioni obiettivo e vincoli
-
Convertire i problemi in formulazioni QUBO
-
Generare rappresentazioni come Hamiltoniana o operatore
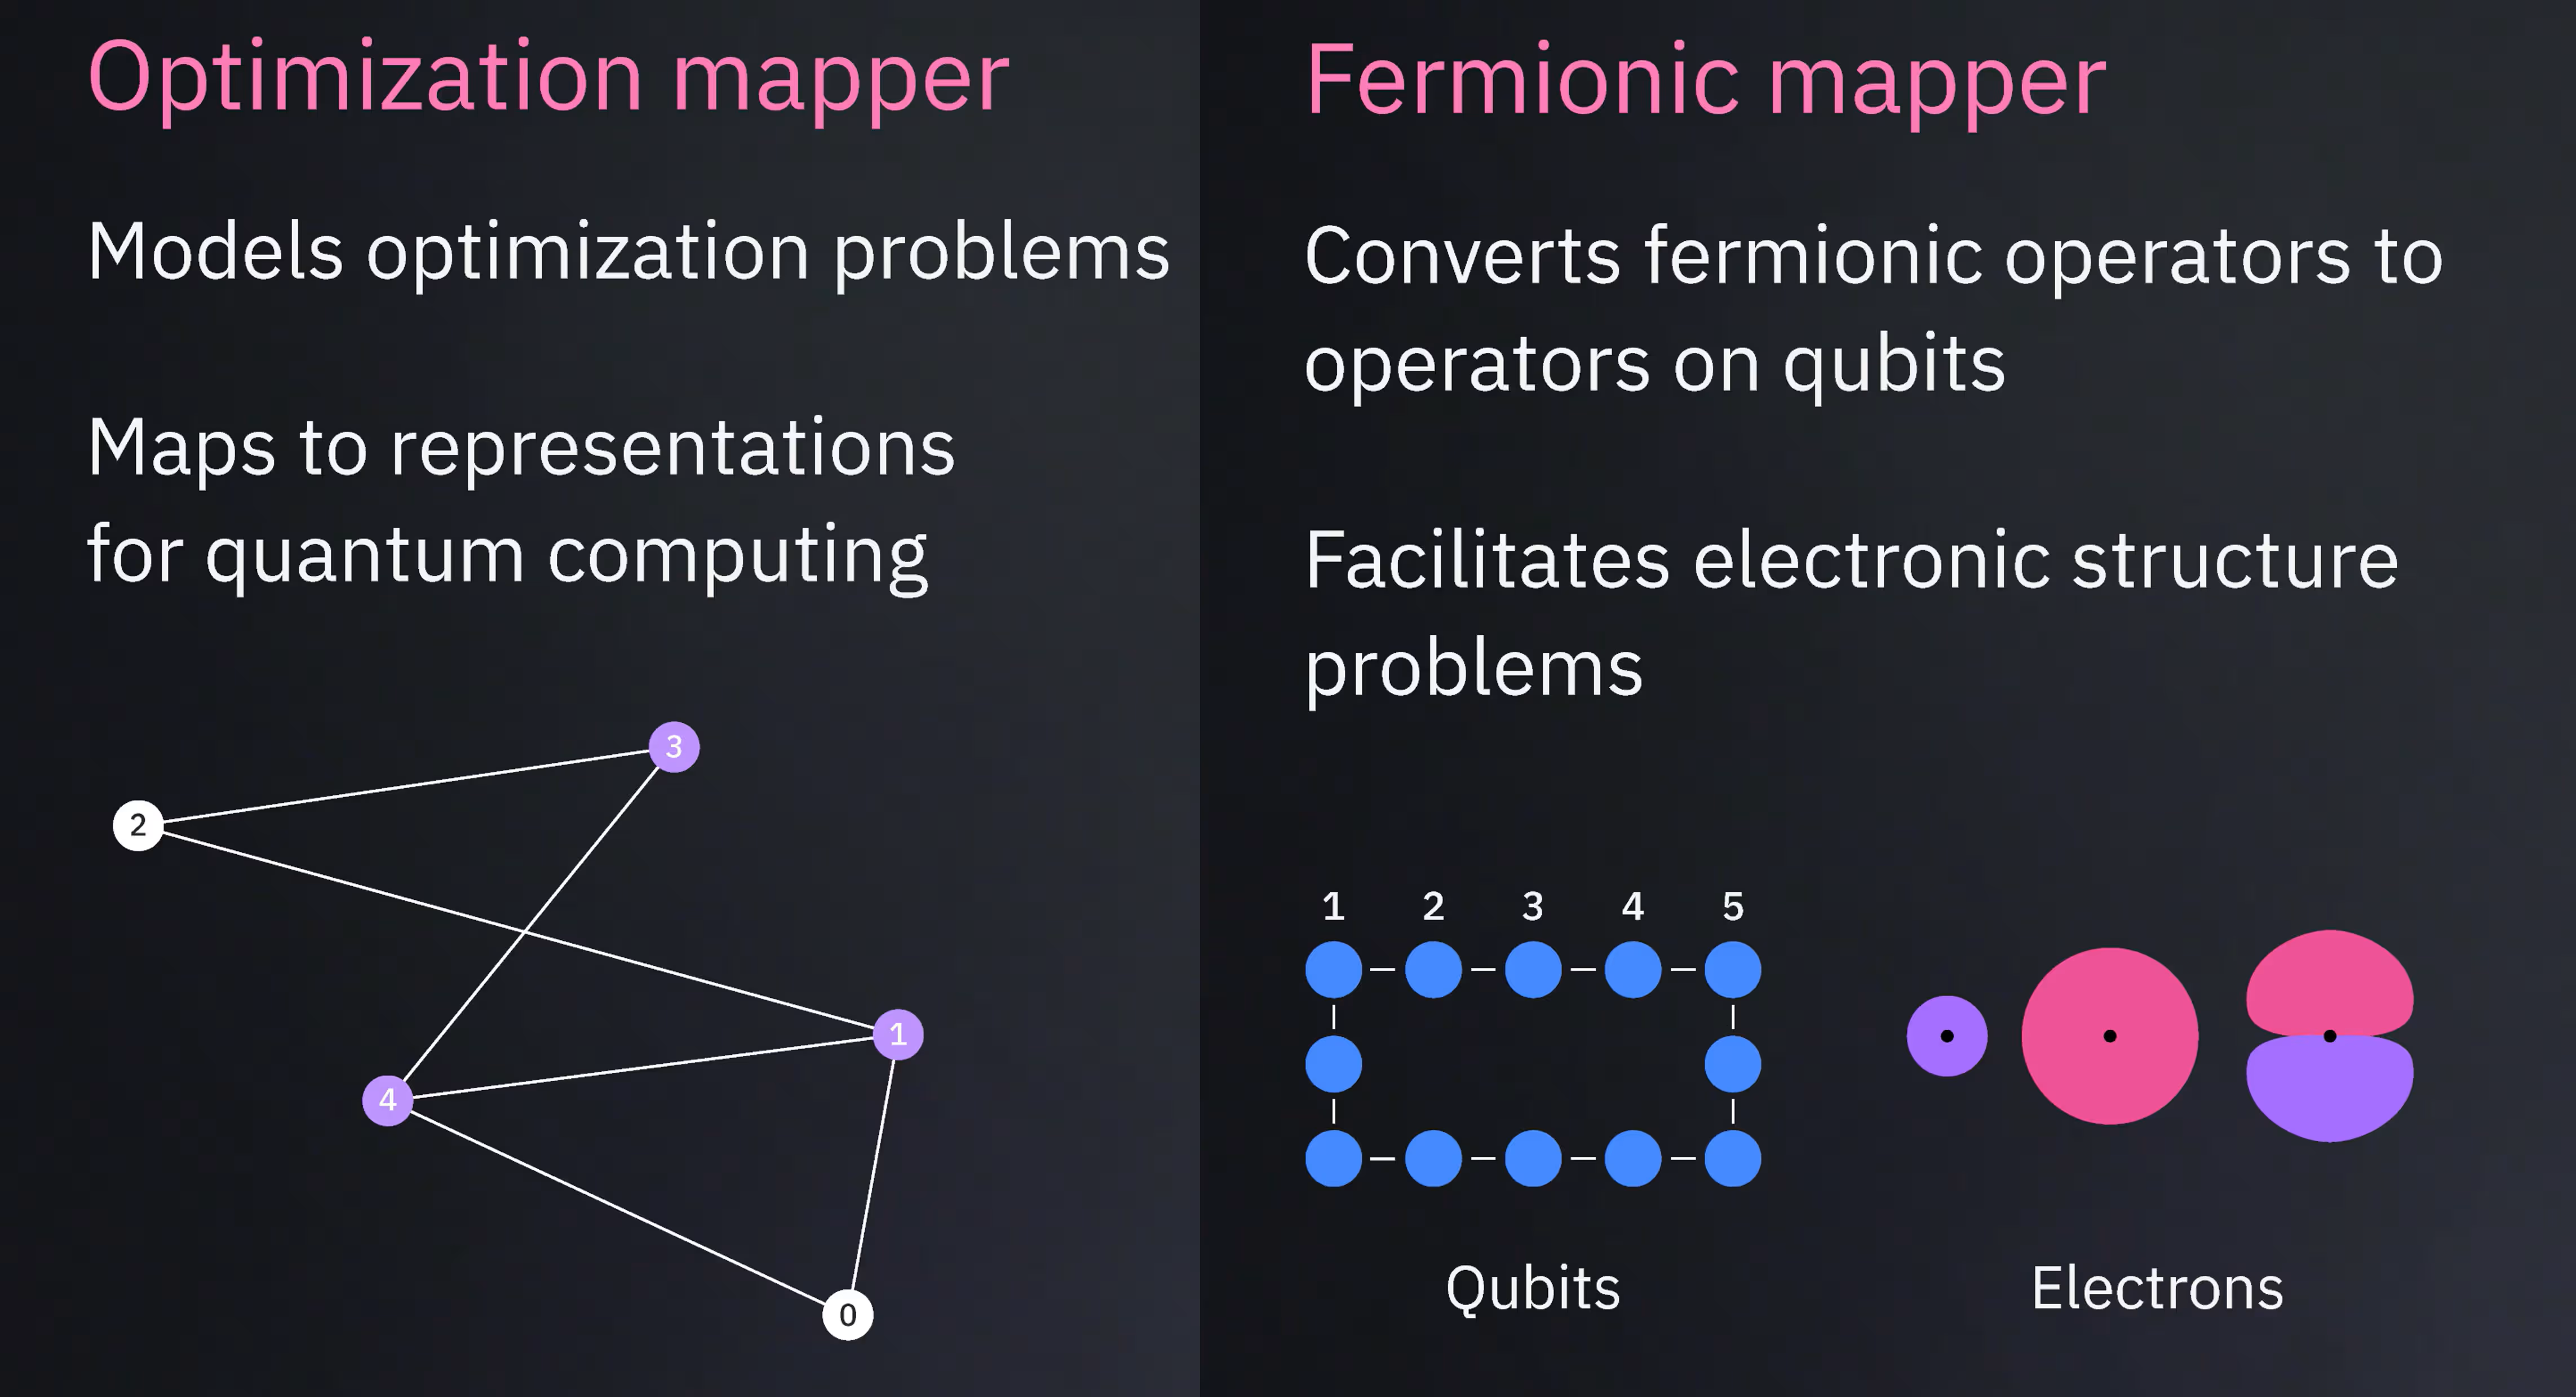
Fermionic mapper
Fermionic mapper converte gli operatori fermionici in operatori di qubit adatti all'hardware quantistico. Supporta mappature come Jordan-Wigner, che converte operatori su fermioni indistinguibili in operatori di Pauli su qubit distinguibili, preservando la statistica fermionica. Questo addon è utile per applicazioni di chimica quantistica e scienza dei materiali.
I due addon precedenti si concentrano sulla mappatura iniziale della struttura di un problema su un circuito quantistico. È altrettanto importante, tuttavia, mappare in modo efficiente l'evoluzione temporale di un processo su un circuito quantistico e ottimizzare un circuito riducendone la profondità. I prossimi addon affrontano questi compiti.
Multi-product formulas (MPF)
Multi-product formulas migliorano l'accuratezza delle simulazioni di evoluzione temporale quantistica combinando più approssimazioni. In particolare, si creano circuiti con numeri diversi di passi di Trotter, in modo da poter usare una combinazione pesata dei risultati dei circuiti. Per una data accuratezza target, MPF può spesso usare circuiti meno profondi rispetto ai metodi di Trotter standard. Il costo è che devi eseguire più circuiti e combinarne i risultati in modo classico.
AQC-Tensor
AQC-Tensor esegue la compilazione quantistica approssimata usando metodi di tensor network. Un caso d'uso comune è sostituire una porzione di un circuito profondo con un'approssimazione variazionale meno profonda. Il circuito risultante può raggiungere un'accuratezza simile con una profondità significativamente inferiore.

Transpilation
Hai già usato la transpilation molte volte in questo corso. Sai che, dopo aver costruito un circuito astratto, questo deve essere preparato per l'esecuzione sull'hardware. Tuttavia, non abbiamo ancora esplorato in dettaglio le molteplici fasi della transpilation.
Le fasi chiave della transpilation includono:
-
Layout: mappare i qubit logici sui qubit fisici
-
Translation: riscrivere le operazioni usando l'insieme di gate nativo del backend
-
Routing: inserire e ottimizzare le operazioni SWAP richieste dalla connettività dell'hardware
Questi processi sono interconnessi. Ad esempio, il layout dovrebbe minimizzare la profondità anche tenendo conto del routing. Il layout dovrebbe inoltre evitare i qubit e le connessioni più soggetti a errori. Queste fasi sono spesso automatizzate, ma gli utenti avanzati potrebbero scegliere di specificare layout personalizzati o altri vincoli quando necessario.

Per saperne di più sulla transpilation, consulta la guida Introduction to transpilation.
Verifica la tua comprensione
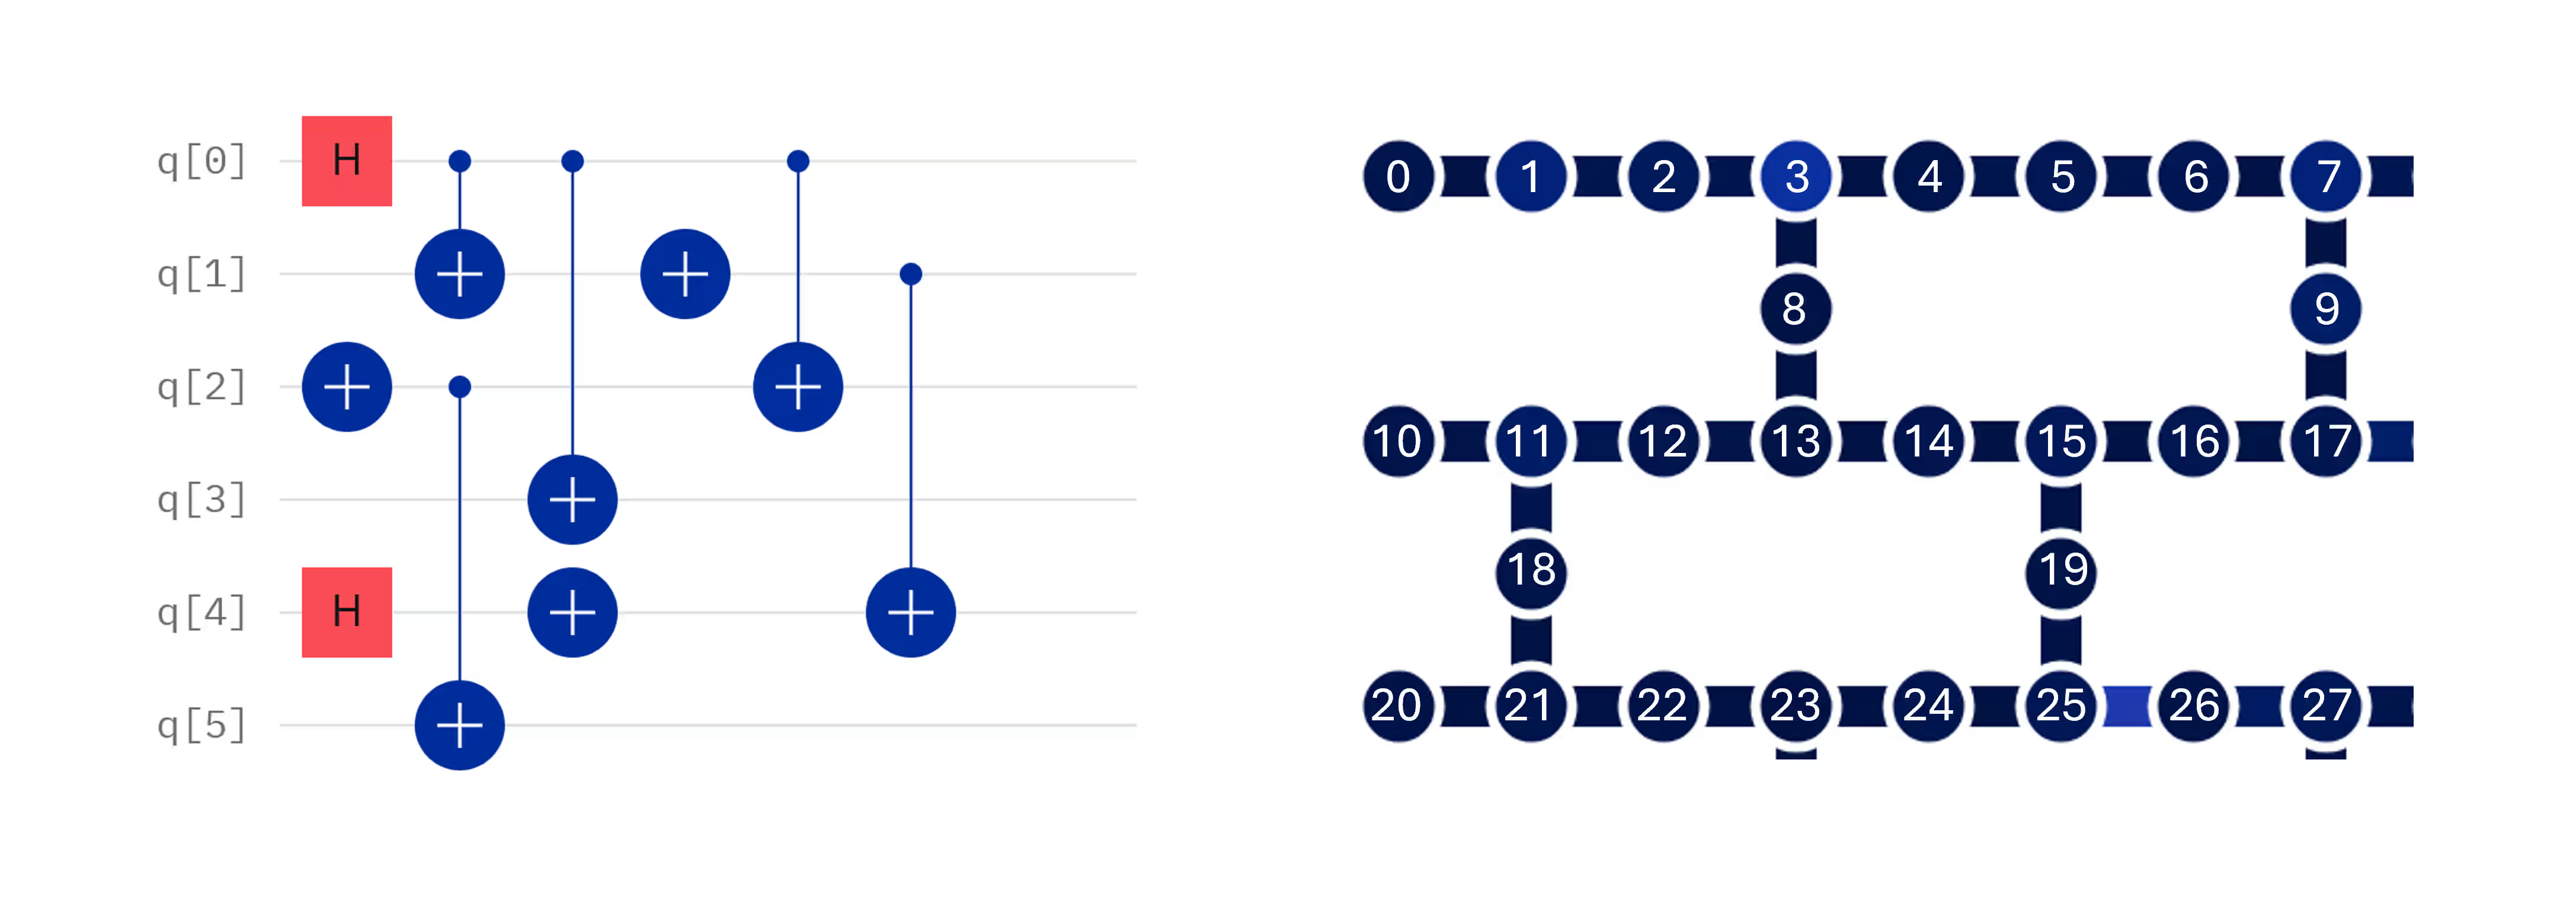
Osserva il circuito quantistico seguente e supponi di doverlo eseguire su un computer quantistico con layout heavy-hex, di cui è mostrata una parte. (a) Proponi una mappatura dai numeri dei qubit nel circuito astratto ai numeri dei qubit nel computer quantistico fisico che minimizzi il numero di gate SWAP richiesti. (b) La tua scelta è unica, o potrebbero esserci altre scelte altrettanto valide? (c) Anche se la tua scelta fosse l'unico layout ottimale per ridurre i gate SWAP, quali sono alcuni motivi per cui il Transpiler potrebbe scegliere una mappatura diversa?
Risposta
(a) Potrebbero esserci molte risposte corrette, ma nota che solo il qubit astratto 0 ha gate di entanglement (a due qubit) con tre vicini. Tutti gli altri partecipano a operazioni a due qubit con soli due vicini. Questo circuito può essere mappato su una topologia heavy-hex senza alcun gate SWAP. Qualsiasi layout che lo ottenga è accettabile. Usando per riferirci al qubit astratto zero e per il qubit zero transpilato, un possibile layout è:
(b) Questo layout non è unico. Molti altri layout evitano del tutto i gate SWAP. Un altro esempio è:
(c) A volte un qubit specifico è più soggetto a errori della maggior parte degli altri sul chip. Inoltre, alcune connessioni tra qubit sono più soggette a errori di altre. Il Transpiler cerca di trovare un layout che eviti gate SWAP non necessari, ma che usi anche i qubit e le connessioni a più alta fedeltà disponibili sul computer quantistico selezionato.
Ridurre gli effetti di rumore ed errori
Diversi addon di Qiskit si concentrano specificamente sulla riduzione dell'impatto del rumore e delle imperfezioni hardware.
Operator backpropagation e trasformazioni di circuiti consapevoli del rumore
Abbiamo già discusso la propagazione degli operatori nel contesto dei controlli di Pauli coerenti nella correzione degli errori. Tuttavia, la propagazione degli operatori è utile in modo più generale. Ci sono due modi principali per usare la propagazione di un operatore attraverso un circuito quantistico: (1) assorbire gli ultimi layer di un circuito quantistico negli osservabili misurati e (2) tenere conto dei probabili effetti degli errori nel circuito e compensarli misurando un osservabile diverso. I prossimi due strumenti usano questi approcci.
Operator backpropagation
Operator backpropagation riduce la profondità del circuito assorbendo nell'osservabile misurato i gate dalla fine di un circuito. Ad esempio, considera il circuito seguente.

Questo circuito contiene layer di rotazione e di entanglement che appaiono non banali, seguiti da una scala di gate CNOT e da una misura di Z sul qubit 5. Questo circuito ha una profondità a due qubit pari a 7. Tale profondità è calcolata prima della transpilation. In pratica, la backpropagation si applica tipicamente dopo la transpilation, ma questo esempio ha scopo puramente didattico. Ricorda che esistono regole per propagare un osservabile oltre un gate. In particolare, quando un gate CNOT ha target e controllo , un osservabile su diventa quando viene propagato all'indietro oltre il gate CNOT: . In questo circuito di esempio, se propaghi l'osservabile all'indietro attraverso l'intera scala di gate CNOT, ottieni l'osservabile , o nella notazione standard di Qiskit, semplicemente . Se misuriamo questo osservabile invece del solo , possiamo rimuovere l'intera scala di gate CNOT, il che riduce la profondità a due qubit da 7 a 2. Questo osservabile richiede ancora una misura in una sola base su ciascun qubit, quindi non aumenta il numero di shot necessari. Questo non è sempre il caso. In generale, osservabili più complicati richiedono più shot e talvolta più misure in basi diverse.
La strategia complessiva dell'operator backpropagation comprende i passaggi seguenti:
-
Accorciare il circuito eseguito
-
Sostituire l'osservabile originale con un osservabile esteso
-
Scambiare profondità del circuito con maggiori requisiti di campionamento
Il circuito precedente è un esempio evidente in cui la backpropagation è vantaggiosa. In generale, tuttavia, non è facile identificare i circuiti che traggono maggior beneficio dalla backpropagation. Per decidere quando usarla, verifica quanta profondità puoi rimuovere dal tuo circuito e confronta tale riduzione con i maggiori requisiti di campionamento.
Propagated noise absorption (PNA)
Propagated noise absorption è strutturalmente simile all'operator backpropagation. Tuttavia, invece di propagare un operatore all'indietro attraverso i gate ideali di un circuito, PNA incorpora un modello di rumore appreso e propaga direttamente nell'osservabile gli effetti del rumore. PNA fa quanto segue:
-
Apprende il comportamento del rumore dall'hardware
-
Propaga il modello di rumore attraverso il circuito
-
Produce un osservabile modificato che compensa il rumore dei gate
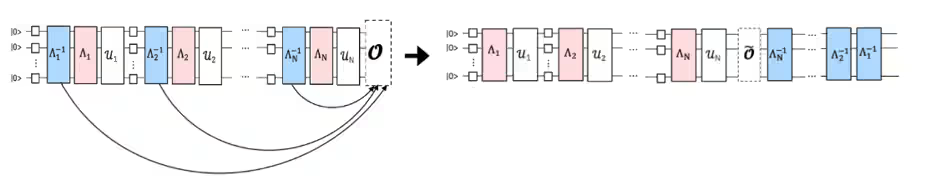
Quando l'osservabile modificato viene misurato su hardware rumoroso, i valori di aspettazione risultanti approssimano meglio il risultato ideale privo di rumore. PNA ha due tipi di overhead. Primo, devi apprendere il modello di rumore, il che richiede l'esecuzione di circuiti aggiuntivi. Secondo, PNA può produrre osservabili più complicati, il che può aumentare i requisiti di campionamento.
Circuit cutting
Circuit cutting suddivide un circuito grande in sottocircuiti più piccoli che possono essere eseguiti in modo indipendente. Si eseguono poi abbastanza misure da ricombinare i risultati. Il circuit cutting fa quanto segue:
-
Riduce i requisiti hardware
-
Consente calcoli più grandi del numero di qubit disponibili (circuiti più larghi)
-
Aiuta ad affrontare i limiti di profondità e connettività (circuiti più profondi)
-
Ricostruisce il risultato originale tramite post-elaborazione classica

Samplomatic
Molte delle tecniche nelle sezioni precedenti complementano altri metodi di soppressione e mitigazione trattati in tutto il corso, tra cui:
-
Dynamical decoupling
-
Pauli twirling
-
M3
-
TREX
-
Zero-noise extrapolation (ZNE)
-
Probabilistic error cancellation (PEC)
In molti workflow puoi applicare tecniche diverse a regioni diverse dello stesso circuito. Come abbiamo visto, molte di queste tecniche comportano anche un overhead quantistico. Perciò a volte abbiamo bisogno di un controllo fine e dettagliato sull'apprendimento del rumore, sul campionamento e sull'applicazione delle sequenze di twirling. Queste sono alcune delle motivazioni alla base di Samplomatic.
Samplomatic è una libreria open source che consente workflow personalizzati di campionamento, randomizzazione e mitigazione degli errori.
Il suo primo compito è analizzare un circuito e suddividerlo in regioni etichettate, o box. Questi box hanno due scopi:
-
Partizionano visivamente il circuito.
-
Creano regioni indicizzate che possono essere configurate in modo indipendente.
Gli utenti possono associare annotazioni che descrivono come ciascun box debba essere trattato durante l'esecuzione. Alcuni esempi:
-
Applicare il Pauli twirling a tutti i box
-
Applicare il twirling solo a box selezionati
-
Usare gruppi di twirling diversi in regioni diverse
-
Iniettare rumore appreso in layer specifici
-
Personalizzare le strategie di mitigazione a un livello di granularità fine
Samplomatic identifica anche le regioni in box ripetute. Poiché layer identici presentano tipicamente caratteristiche di rumore simili, devi eseguire l'apprendimento del rumore una sola volta per ogni layer unico.
Output di Samplomatic
Samplomatic produce due oggetti principali:
-
Circuito template
-
Samplex
Il circuito template è un circuito inscatolato (boxed), transpilato e parametrizzato, pronto per l'esecuzione. Il samplex contiene tutte le informazioni necessarie per generare ed elaborare le varianti del circuito. Il contenuto del samplex include:
-
Valori dei parametri per i circuiti parametrizzati
-
Selezioni di randomizzazione
-
Distribuzioni di campionamento
-
Informazioni di post-elaborazione
-
Metadati di esecuzione aggiuntivi
Formalmente, un samplex è una distribuzione di probabilità sui parametri di un circuito template, insieme alle informazioni ausiliarie necessarie per l'esecuzione e la post-elaborazione. Un importante vantaggio pratico è che sia il circuito template sia il samplex vengono creati localmente sul lato client. Di conseguenza, puoi ispezionarli, validarli ed eseguirne il debug prima di usare qualsiasi risorsa hardware.
Samplomatic offre molti vantaggi, tra cui il controllo granulare dell'allocazione adattiva degli shot e della randomizzazione. Offre anche vantaggi logistici, come flussi di post-elaborazione strutturati. Uno dei vantaggi più importanti è il riutilizzo delle informazioni sul rumore apprese attraverso layer identici, che può far risparmiare una quantità significativa di tempo di calcolo quantistico durante l'apprendimento del rumore.
Lightcone ombreggiati
Prima di decidere dove applicare tecniche di mitigazione costose, è utile identificare le regioni di un circuito che contano di più per l'osservabile misurato. Questa esigenza motiva l'addon shaded lightcones. L'idea di lightcone (cono di luce) deriva dalla relatività, in cui le relazioni causali sono vincolate dalla velocità finita con cui può viaggiare l'informazione.
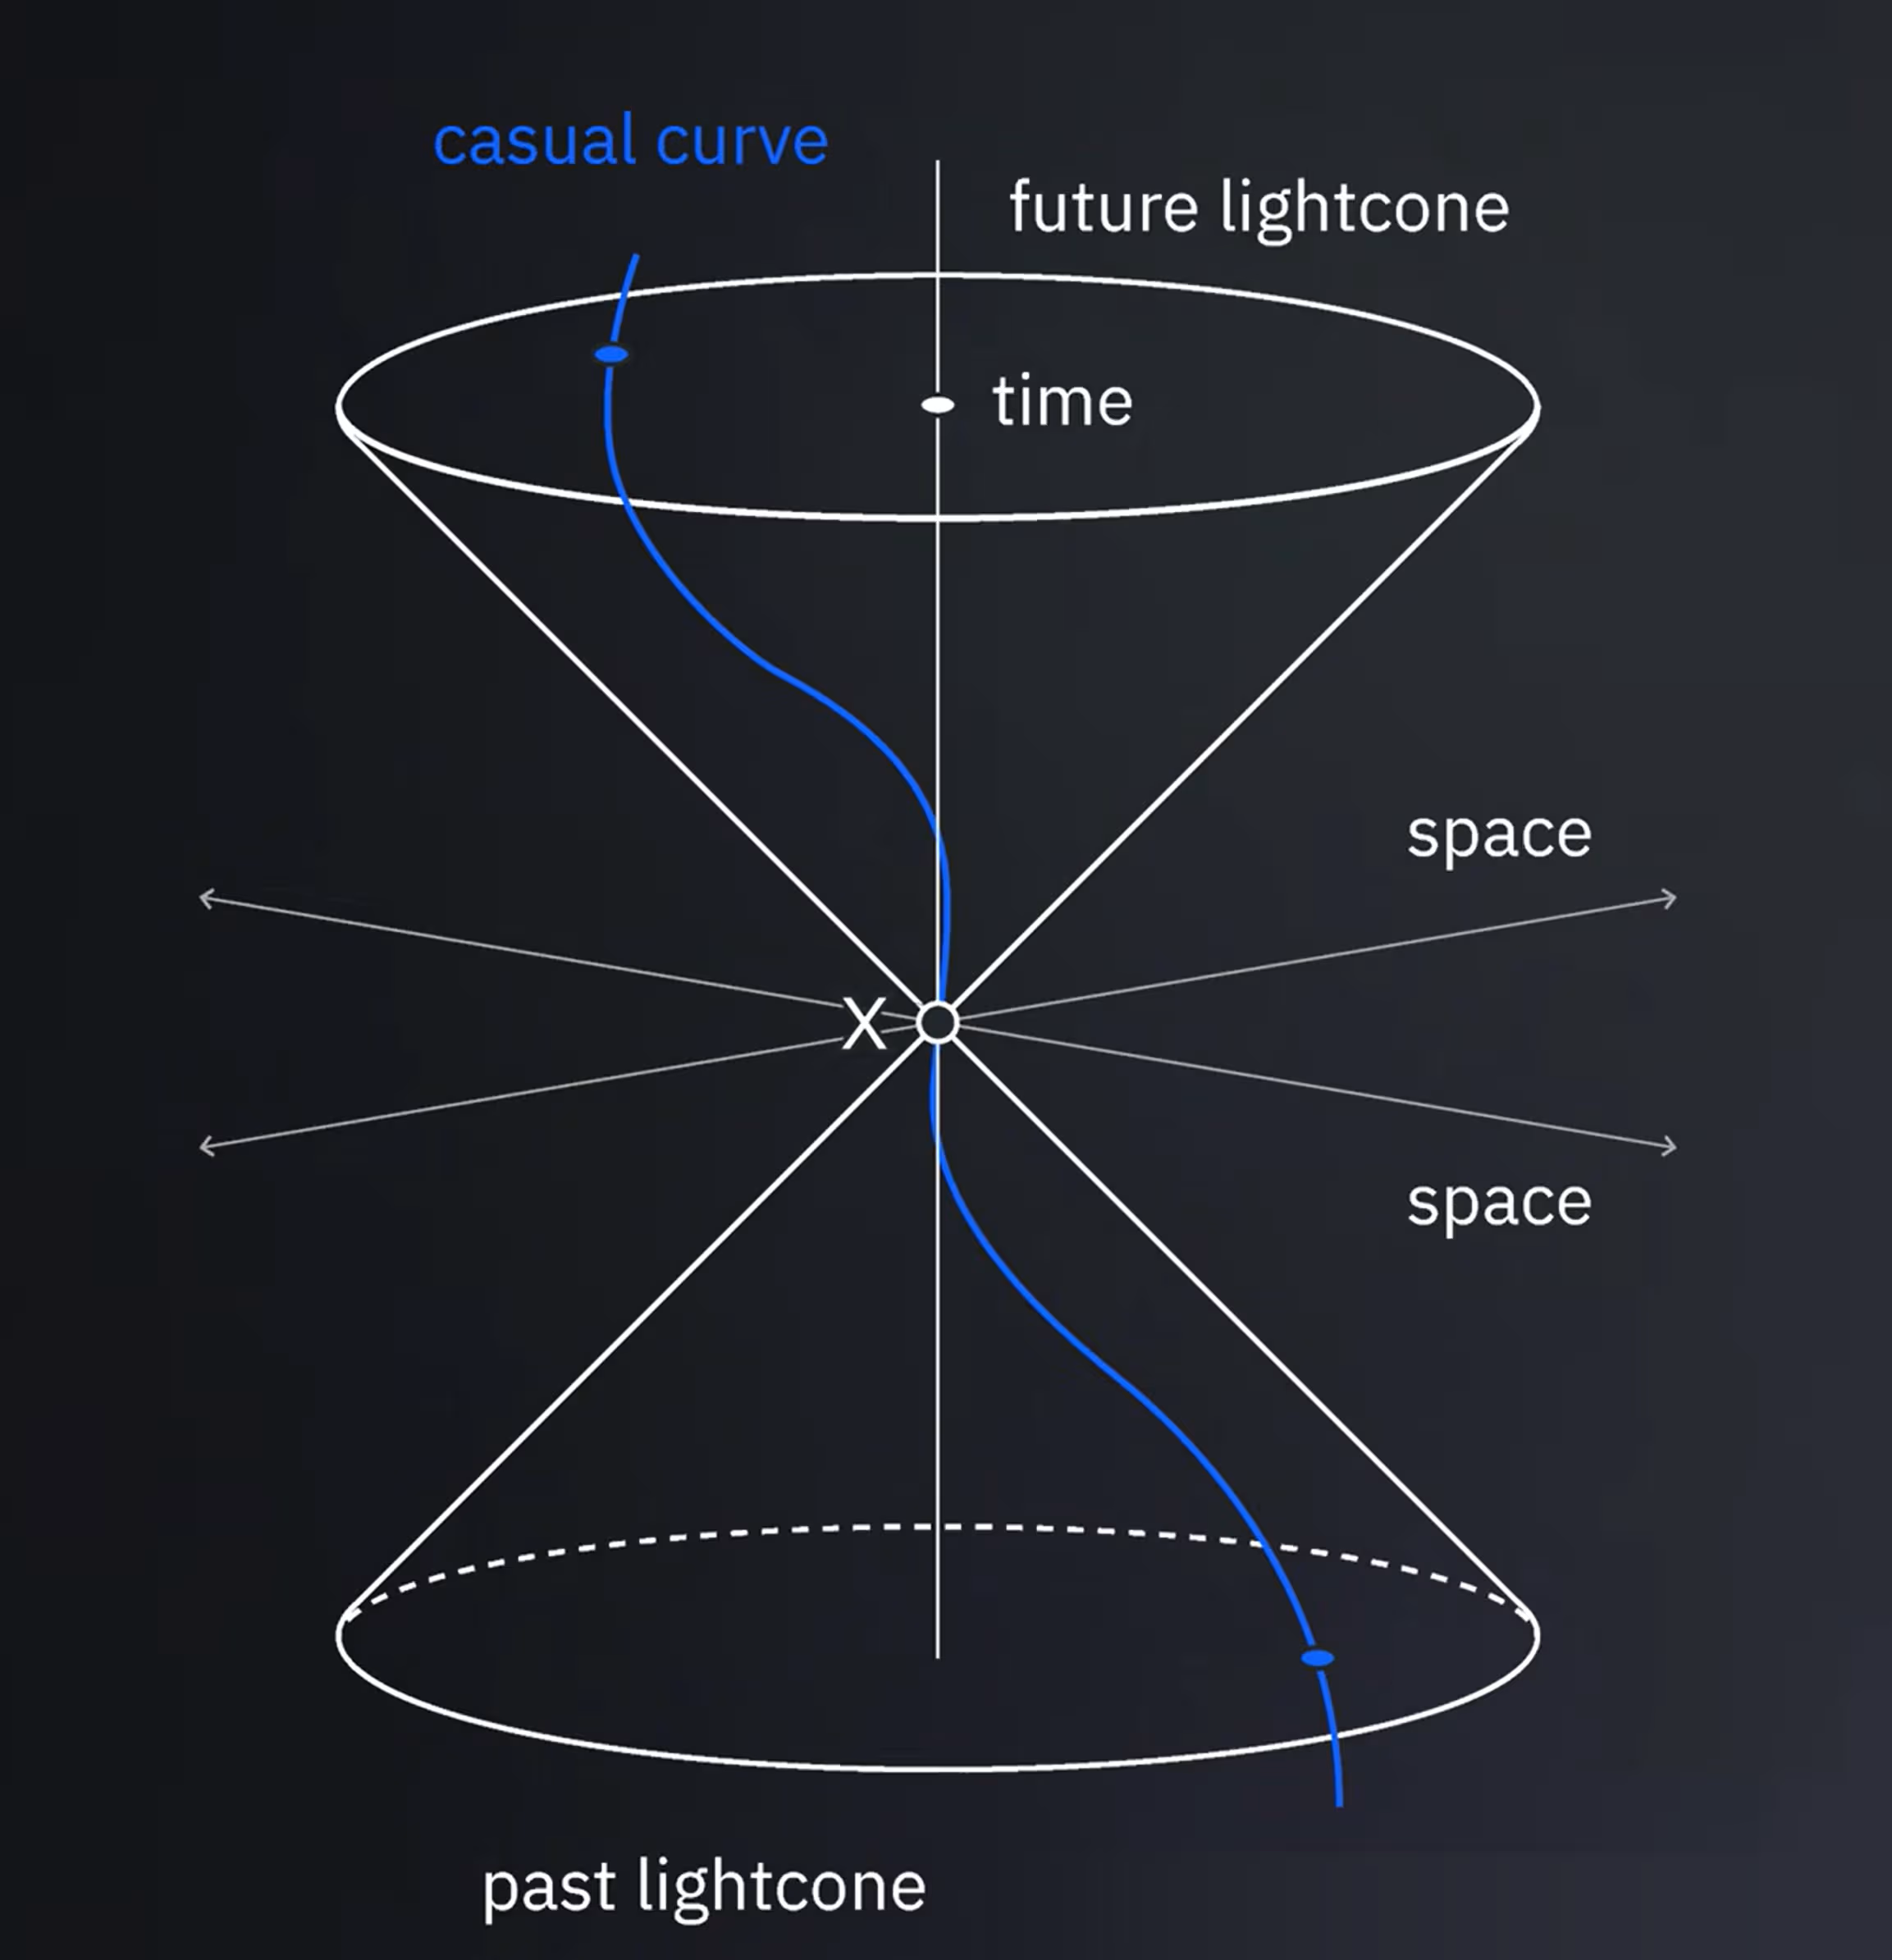
Un concetto simile si applica ai circuiti quantistici.
Considera un circuito di grandi dimensioni in cui interessa solo un'osservabile di basso peso. Un'osservabile di basso peso agisce in modo non banale solo su pochi qubit. Le osservabili di basso peso sono di interesse per molte ragioni. Ad esempio, possono rappresentare quanto segue:
-
Singoli termini all'interno di un Hamiltoniano più grande
-
Una regione di interazione localizzata
-
Informazioni raccolte su un piccolo insieme di qubit ancilla
-
Altre osservabili che coinvolgono solo pochi qubit
Non tutti gli errori nel circuito possono influenzare il risultato della misura. Questo vale in particolare per gli errori di Pauli, o per qualsiasi errore che possa essere modellato come un insieme di operazioni di Pauli. Ad esempio, osserva il circuito seguente:
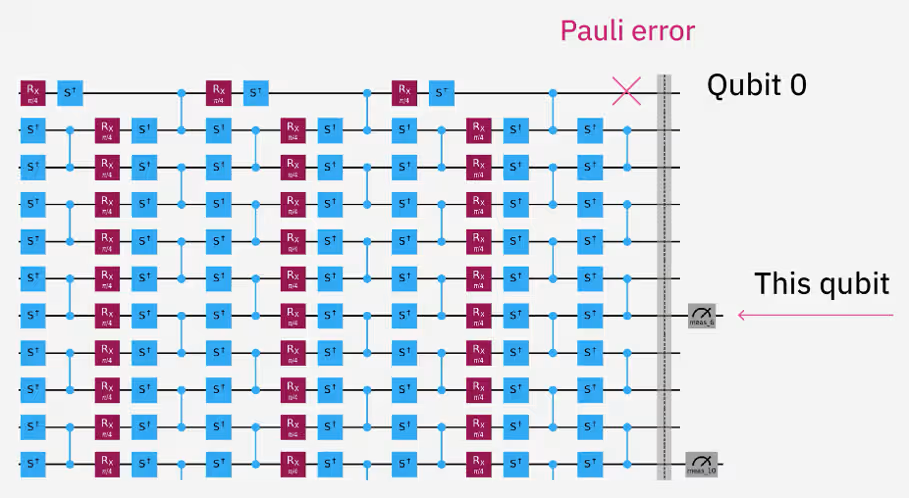
Un errore di Pauli sul qubit 0 nell'ultimo layer non può influenzare la misura sul qubit 6, perché non esiste alcun gate di collegamento che possa propagare l'errore dal qubit 0 al qubit 6. Nota che questo ragionamento non si applica a certi errori non unitari. Ad esempio, una transizione di tipo T1 verso lo stato fondamentale sul qubit 0 fa collassare il qubit 0 su uno stato della base computazionale. Se i qubit 0 e 6 erano stati precedentemente entangled (come lo sono in questo circuito), l'errore non unitario sul qubit 0 può influenzare il qubit 6. La discussione seguente si concentra sugli errori che possono essere rappresentati come operazioni di Pauli, o come miscele probabilistiche di operazioni di Pauli.
Nell'ultimo layer, solo un errore di Pauli sul qubit 5 o sul qubit 6 può influenzare direttamente la misura sul qubit 6.
Nel layer di entangling precedente, i qubit 5 e 6 sono entangled rispettivamente con i qubit 4 e 7. Pertanto, in quel layer di entangling o subito prima, un errore di Pauli su uno qualsiasi di questi quattro qubit può influenzare la misura successiva. Puoi continuare a risalire all'indietro lungo il circuito per trovare il sottoinsieme di gate e qubit causalmente connessi alla misura. Questo insieme causale forma una regione a forma di cono nello spazio (qubit) e nel tempo (layer), da cui deriva il termine lightcone. La forma esatta della regione varia da circuito a circuito. Poiché questa analisi dipende dalla connettività dell'hardware e dal posizionamento dei gate, è più utile dopo la transpilazione, il routing e l'ottimizzazione del layout.
Oltre la connettività causale
I lightcone ombreggiati estendono questa idea considerando anche quali tipi di errori contano.
Ad esempio, nota quanto segue:
-
Un errore Z immediatamente prima di una misura nella base Z non ha alcun effetto sul risultato della misura.
-
Un errore X immediatamente prima di una misura nella base Z può cambiare drasticamente il risultato.
Alcuni tipi di errore meritano quindi più impegno di mitigazione di altri. Questa distinzione può ridurre sostanzialmente l'overhead di tecniche come PEC. In pratica, l'addon genera analisi di sensibilità separate per ciascuno dei seguenti tipi di errore:
-
X errors
-
Z errors
-
Errori Y (o XZ a meno di una fase)
Questa sensibilità agli errori in genere appare diversa per ciascun tipo di errore, perché errori diversi causalmente connessi hanno impatti diversi sulla misura. Nota anche che la sensibilità cambia lungo il circuito. Un errore X immediatamente prima della misura può essere molto dannoso, mentre un errore che si verifica molti layer prima può avere un effetto minore dopo essersi propagato attraverso uno stato fortemente entangled.
I lightcone ombreggiati quantificano questa differenza assegnando un valore di sensibilità agli errori potenziali lungo tutto il circuito.
Le mappe risultanti indicano quanto segue:
-
Dove contano gli errori
-
Quali tipi di errore contano
-
Con quanta forza influenzano l'osservabile finale
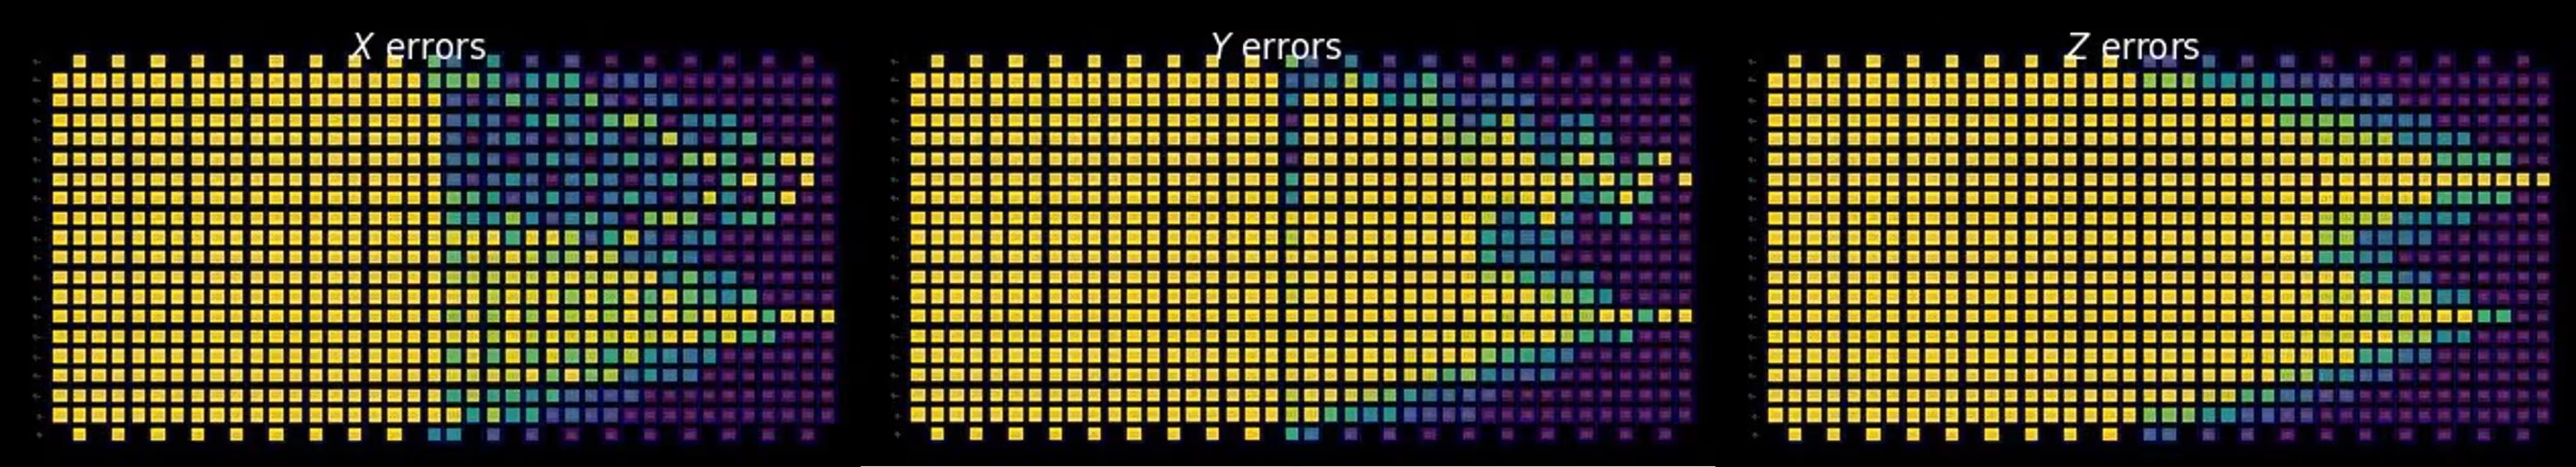
I lightcone ombreggiati non mitigano gli errori da soli, ma possono aiutare a concentrare l'impegno di mitigazione dove offre il massimo beneficio.
Apprendere e iniettare il rumore
Dopo che un circuito è stato costruito, ottimizzato e annotato, restano due compiti complementari: apprendere il rumore e usare il modello di rumore (ad esempio, per iniettare rumore o per propagarne gli effetti).
NoiseLearnerV3
NoiseLearnerV3 è lo strumento attuale per l'apprendimento del rumore. La precedente interfaccia NoiseLearner accettava circuiti interi e produceva modelli di rumore di Pauli-Lindblad. NoiseLearnerV3, invece, opera direttamente sulle istruzioni di circuito inscatolate (boxed). In sintesi, NoiseLearnerV3 fa quanto segue:
-
Accetta raccolte di layer di circuito etichettati
-
Riutilizza le informazioni dai layer ripetuti
-
Supporta l'apprendimento del rumore di misura
-
Supporta la post-elaborazione dei modelli appresi
-
Abilita flussi di lavoro di iniezione e scalatura del rumore
Questo design si allinea strettamente al flusso di lavoro orientato ai layer di Samplomatic. In particolare, NoiseLearnerV3 usa i seguenti metodi per ciascun insieme di istruzioni:
-
Apprendimento di Pauli-Lindblad per le operazioni dei gate
-
Apprendimento basato su TREX per le misure
Puoi quindi usare un modello di rumore appreso in molti dei metodi che abbiamo già trattato. Ad esempio, ricorda che l'estrapolazione a rumore zero (ZNE) con gate folding può portare a circuiti intrattabilmente profondi. Il metodo alternativo per scalare il rumore in quel caso era campionare da un modello di rumore noto, il che aumenta effettivamente il livello di rumore, anche per fattori non interi. Questo metodo, l'amplificazione probabilistica degli errori (PEA), è un buon esempio di come puoi usare un modello di rumore per mitigare gli errori. Un buon modello di rumore è richiesto anche per la cancellazione probabilistica degli errori (PEC) e per l'assorbimento del rumore propagato (PNA).
In breve, con un modello di rumore di alta qualità, il rumore diventa una risorsa programmabile anziché solo una fonte di errore.
Lightcone ombreggiati contro NoiseLearnerV3
NoiseLearnerV3 e SLC sono strettamente correlati, ma accettano input distinti e rispondono a domande diverse. SLC determina dove concentrare l'impegno di mitigazione. NoiseLearnerV3 caratterizza il rumore effettivamente presente in quelle regioni. Questi processi comportano anche tipi diversi di overhead. La tabella seguente riassume queste differenze.
| Lightcone ombreggiati | NoiseLearnerV3 | |
|---|---|---|
| Scopo | Identifica dove la mitigazione conta | Apprende come si comportano gli errori |
| Overhead | Principalmente overhead classico | Richiede esecuzioni su hardware |
| Output | Produce mappe di sensibilità | Produce descrizioni dei canali di rumore |
| Input | Usa la struttura del circuito e la propagazione degli operatori | Usa la struttura del circuito e dati sperimentali dell'hardware |
Esecuzione con Executor e runtime
Executor esegue il passaggio finale di esecuzione. Può operare su uno dei seguenti input:
-
Un circuito template e un samplex generati da Samplomatic
-
Un circuito quantistico convenzionale senza Samplomatic
Con questa flessibilità, puoi adottare quanti più o quanti meno componenti del flusso di lavoro di esecuzione diretta ti servono.
Executor lavora a stretto contatto con Samplomatic, che gestisce le scelte di randomizzazione, l'allocazione degli shot, le selezioni di iniezione del rumore e i relativi metadati di esecuzione, come descritto in precedenza.
Per esempi pratici del modello di esecuzione diretta, consulta la guida Modello di esecuzione diretta, nonché i tutorial e la documentazione degli addon di Qiskit su IBM Quantum® Platform.
Conclusione
I moderni flussi di lavoro quantistici si affidano sempre più a un insieme di strumenti complementari anziché a un'unica primitiva di esecuzione.
Questi strumenti supportano ogni fase del flusso di lavoro:
-
Mappatura del problema
-
Costruzione del circuito
-
Transpilazione e ottimizzazione
-
Soppressione degli errori
-
Mitigazione degli errori
-
Apprendimento del rumore
-
Esecuzione strutturata
-
Post-elaborazione
Insieme, strumenti come Samplomatic, Executor, NoiseLearnerV3, lightcone ombreggiati, assorbimento del rumore propagato, circuit cutting e AQC-Tensor offrono un controllo significativamente maggiore rispetto ai modelli di esecuzione precedenti.
Il campo continua a evolversi rapidamente. Man mano che i processori quantistici diventano più grandi e più connessi, è probabile che queste tecniche svolgano un ruolo sempre più importante nel raggiungere un vantaggio quantistico utile e, alla fine, nell'integrarsi senza soluzione di continuità con i flussi di lavoro di calcolo quantistico fault-tolerant.