Mitigazione degli errori
Questa lezione fornisce il contesto su varie tecniche di mitigazione degli errori per aiutarti a sviluppare l'intuizione su come e quando usarle al meglio. È importante notare che le applicazioni moderne di queste tecniche sfrutteranno strumenti più sofisticati, come Samplomatic, Shaded Lightcones ed Executor. Questi workflow saranno trattati nelle lezioni successive.
Questo video offre una panoramica delle tecniche di mitigazione degli errori. Il testo seguente aggiunge più dettagli ed esplora questi metodi usando Qiskit.
Panoramica delle tecniche di mitigazione degli errori
La mitigazione degli errori indica qualsiasi processo che tenta di ridurre gli effetti degli errori nei calcoli quantistici dopo che si sono verificati. È diversa dalla soppressione, che tenta di prevenire gli errori, e dalla correzione degli errori, che codifica l'informazione su molti qubit fisici e verifica la coerenza di tale informazione per preservarla in un singolo qubit logico. In questa lezione, le tecniche di mitigazione degli errori si comprendono meglio come metodi per costruire stimatori migliori dei valori di aspettazione ideali o campionatori migliori delle distribuzioni di probabilità, non come metodi per correggere gli stati quantistici durante l'esecuzione. Esamineremo i metodi di mitigazione degli errori seguenti, tutti disponibili in Qiskit e nei suoi addon, e che sono strumenti promettenti nella ricerca del vantaggio quantistico.
Twirled readout error extinction (TREX) rende casuale il processo di misura applicando operazioni di Pauli scelte a caso prima della misura e annullando poi in modo classico i loro effetti noti sulle bitstring osservate. Sotto opportune ipotesi sul rumore di misura, questo converte il canale di errore di lettura in una forma più semplice e simmetrica, più facile da calibrare e mitigare.
Matrix-free measurement mitigation (M3) è una tecnica scalabile di mitigazione degli errori di misura che evita di costruire esplicitamente la matrice di assegnazione o la sua inversa.
Zero noise extrapolation (ZNE) approssima il valore che un'osservabile avrebbe in assenza di rumore, scalando artificialmente il rumore di un fattore noto ed estrapolando poi al caso di rumore zero. Ciò richiede che il rumore scali in modo prevedibile. Tale prevedibilità potrebbe richiedere altri metodi trattati in questa lezione (pulse stretching, gate folding e probabilistic error amplification (PEA)).
Probabilistic error cancellation (PEC) è tra le tecniche di mitigazione degli errori più potenti, ma anche più costose dal punto di vista computazionale. Funziona apprendendo il comportamento del rumore del sistema e tentando di annullarlo costruendo statisticamente una stima non distorta del calcolo ideale. PEC produce osservabili corrette statisticamente, non risultati con errori corretti.
Ora approfondiremo ciascuno di questi metodi.
M3
Gli errori di misura sono una delle fonti di rumore più persistenti e dipendenti dall'hardware nei dispositivi quantistici a breve termine. Anche quando uno stato quantistico viene preparato ed evoluto correttamente, il passaggio finale di lettura può riportare in modo errato il vero risultato nella base computazionale. Questi errori derivano da una discriminazione imperfetta tra gli stati fisici corrispondenti a e , dal rilassamento durante la misura e da imperfezioni dell'elettronica di misura. Di conseguenza, la distribuzione osservata delle bitstring è spesso una versione distorta della vera distribuzione (ideale), con probabilità riassegnata in modo errato tra gli esiti.
La mitigazione delle misure affronta questo problema modellando esplicitamente il modo in cui gli esiti delle misure vengono assegnati erroneamente. Nella formulazione standard, questo comportamento è descritto da una matrice di assegnazione , i cui elementi rappresentano la probabilità di registrare l'esito quando il vero stato della base era . Se il rumore di misura è classico e stazionario, il vettore di probabilità osservato è legato alla distribuzione ideale da una semplice relazione lineare,
Nota che la matrice di assegnazione è una mappa stocastica classica, non un canale quantistico. Agisce sulle letture classiche, non sugli stati quantistici sottostanti che sono stati campionati per ottenere le letture.
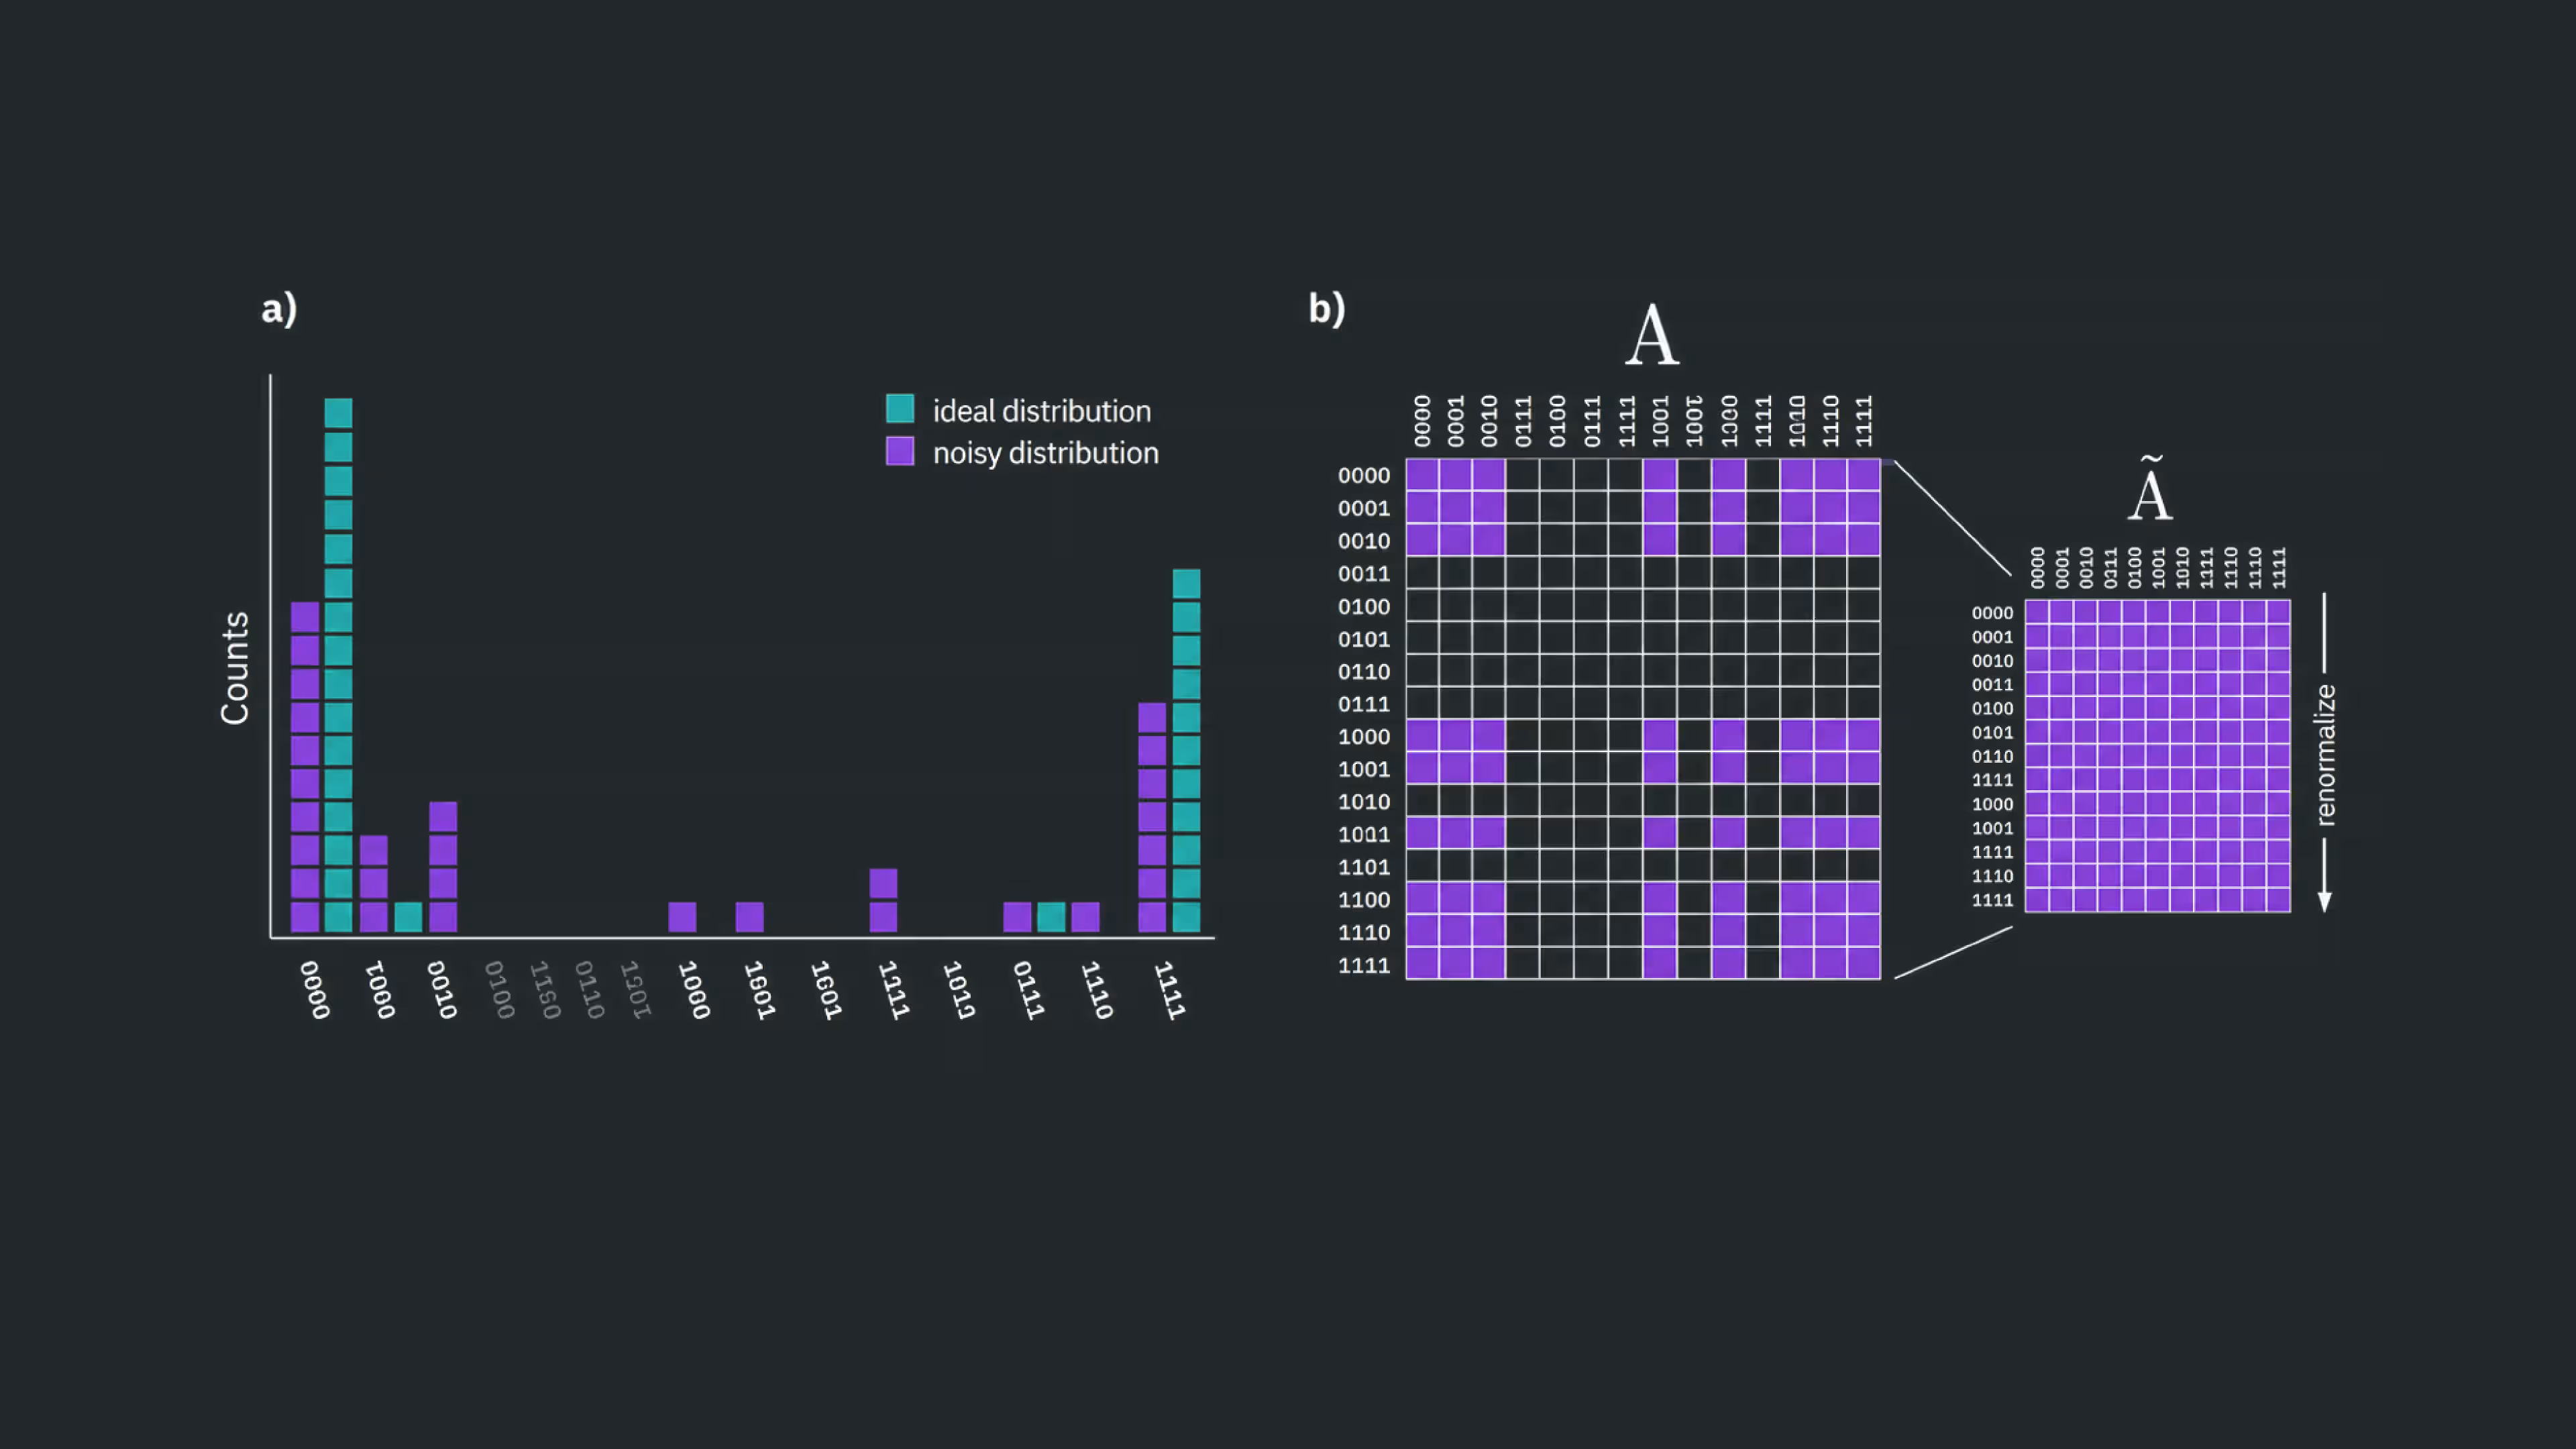
La matrix-free measurement mitigation (M3) sfrutta questa struttura per costruire una stima mitigata di senza mai formare o invertire l'intera matrice , cosa irrealizzabile per un grande numero di qubit. M3 sfrutta invece il fatto che molti carichi di lavoro quantistici a breve termine producono distribuzioni fortemente piccate o a bassa entropia, in modo che la mitigazione si concentri solo sul sottoinsieme di esiti che contribuiscono in modo significativo alla distribuzione osservata.
Per costruire il modello di assegnazione, è necessario eseguire esperimenti di calibrazione aggiuntivi sull'hardware quantistico. Questi consistono tipicamente nel preparare stati noti della base computazionale e registrare come vengono riportati dal sistema di misura. L'overhead di calibrazione scala con il numero di qubit misurati, mentre il costo computazionale della mitigazione dipende dalla struttura della distribuzione osservata. Questo costo è molto inferiore a quello che sarebbe necessario per caratterizzare esplicitamente l'intera matrice di assegnazione . Sebbene questo overhead di calibrazione sia reale, è leggero rispetto alle tecniche a livello di circuito come la zero-noise extrapolation o la probabilistic error cancellation, il che rende M3 uno strumento pratico e ampiamente usato per mitigare gli errori di lettura negli esperimenti quantistici a breve termine.
Nota che la calibrazione è utile solo nella misura in cui il processo di misura rimane sufficientemente stabile tra le esecuzioni di calibrazione e l'esperimento di destinazione.
Svolgeremo prima a mano un caso semplice per illustrare come funziona, poi useremo gli strumenti integrati in Qiskit per mostrare l'uso di M3 su una scala più realistica.
Piccolo esempio di M3
Iniziamo costruendo un semplice stato di Bell.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "mthree": "mthree", "numpy": "numpy", "qiskit": "qiskit", "qiskit_aer": "qiskit-aer", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
import numpy as np

qc = QuantumCircuit(2, 2)
qc.h(0)
qc.cx(0, 1)
qc.measure([0, 1], [0, 1])
<qiskit.circuit.instructionset.InstructionSet at 0x714a5fa4d630>
Possiamo usare un simulatore con un modello di rumore perché limitiamo questo esempio a un circuito molto piccolo. Configuriamo esplicitamente il nostro modello di rumore con un errore di lettura della forma:
if true=0: [95% chance of reading 0, 5% chance of reading 1]
if true=1: [8% chance of reading 0, 92% chance of reading 1]
Questi tassi di errore di lettura sono molto più alti di quelli che si osservano nei veri computer quantistici IBM®. I valori elevati sono stati scelti per ragioni didattiche, in modo da vedere chiaramente l'effetto di M3.
from qiskit_aer import AerSimulator
from qiskit_aer.noise import NoiseModel, ReadoutError

ro_error = ReadoutError([[0.95, 0.05], [0.08, 0.92]])

noise_model = NoiseModel()
noise_model.add_readout_error(ro_error, [0])
noise_model.add_readout_error(ro_error, [1])

backend_noisy = AerSimulator(noise_model=noise_model)
Possiamo eseguire il circuito sul simulatore rumoroso per osservare gli effetti dell'errore di lettura.
result = backend_noisy.run(qc, shots=5000, seed_simulator=123).result()
raw_counts = result.get_counts()
raw_counts
{'01': 290, '11': 2165, '10': 304, '00': 2241}
Nel nostro esempio semplificato, abbiamo definito noi l'errore di lettura per il nostro modello di rumore. Ma con un vero computer quantistico, l'errore di lettura non è noto a priori. Deve invece essere stimato sperimentalmente. A tale scopo creiamo circuiti che preparano un qubit in uno stato noto della base computazionale o e lo misurano. In assenza di errore di lettura misureremmo esattamente lo stato preparato. Raccogliendo statistiche da queste misure, possiamo costruire una matrice di assegnazione che descrive l'errore di lettura. In questo esempio semplificato, dovrebbe somigliare a quella che abbiamo definito.
Per un sistema più realistico, bisognerebbe accumulare statistiche per ogni qubit fisico. Questo a volte non è banale, perché la transpilazione mappa un circuito astratto sull'hardware e il numero del qubit cambia. Lo riprenderemo nell'esempio successivo. In questo esempio con il simulatore abbiamo assegnato lo stesso modello di errore di lettura a ogni qubit, quindi è sufficiente un'unica caratterizzazione.
# Define a function to make a state and measure it.
def measure_state(state):
    qc = QuantumCircuit(1, 1)
    if state == 1:
        qc.x(0)
    qc.measure(0, 0)
    return backend_noisy.run(qc, shots=5000, seed_simulator=123).result().get_counts()
# Use the function to get statistics on readout errors
cal_counts_0 = measure_state(0)  # True state = 0
cal_counts_1 = measure_state(1)  # True state = 1

cal_counts_0, cal_counts_1
({'1': 244, '0': 4756}, {'0': 420, '1': 4580})
# Create the normalized readout error matrix

# def normalize(d):
#    s = sum(d.values())
#    return {k: v/s for k,v in d.items()}
# p0 = normalize(cal_counts_0)
# p1 = normalize(cal_counts_1)

p0 = {k: v / sum(cal_counts_0.values()) for k, v in cal_counts_0.items()}
p1 = {k: v / sum(cal_counts_1.values()) for k, v in cal_counts_1.items()}

A_1q = np.array(
    [
        [p0["0"], p1["0"]],  # row: measured 0, columns true 0/1
        [p0["1"], p1["1"]],
    ]
)
A_1q
array([[0.9512, 0.084 ],
       [0.0488, 0.916 ]])
Nota che questa è molto vicina alla matrice di errore di lettura usata per costruire il simulatore.
Di nuovo, su un vero computer quantistico avremmo statistiche come queste per più qubit fisici. Per questo simulatore assumiamo che i due qubit abbiano errori di lettura identici e indipendenti, il che ci permette di costruire la matrice di assegnazione a due qubit A_2q come prodotto tensoriale delle corrispondenti matrici a un qubit. Nota inoltre che lo scopo di M3 non è costruire l'intera matrice di assegnazione. M3 si concentra invece sul sottoinsieme di esiti che contribuiscono in modo significativo alla distribuzione osservata. Costruiremo l'intera matrice per il nostro esempio molto piccolo per vedere come funziona. L'implementazione di M3 in qiskit-ibm-runtime è più sofisticata di questo esempio semplificato perché deve gestire molti qubit con caratteristiche di lettura distinte, evitando comunque di costruire l'intera matrice di assegnazione.
A_2q = np.kron(A_1q, A_1q)
print(A_2q)
[[0.89794576 0.07107    0.07107    0.005625  ]
 [0.04965424 0.87653    0.00393    0.069375  ]
 [0.04965424 0.00393    0.87653    0.069375  ]
 [0.00274576 0.04847    0.04847    0.855625  ]]
Per questo esempio assumiamo che gli errori di lettura su qubit diversi siano indipendenti, il che permette di costruire la matrice di assegnazione a due qubit come prodotto tensoriale delle corrispondenti matrici a un qubit.
Otteniamo i risultati grezzi e mitigati per il confronto.
bitstrings = ["00", "01", "10", "11"]
# Normalize raw counts
raw_probs = np.array([raw_counts.get(b, 0) for b in bitstrings], dtype=float)
raw_probs /= raw_probs.sum()
raw_probs
array([0.4482, 0.0592, 0.0598, 0.4328])
A questo punto abbiamo caratterizzato sperimentalmente come il processo di misura distorce le probabilità degli esiti ideali. Il nostro obiettivo ora è annullare questa distorsione e applicare la correzione risultante alle probabilità grezze.
Poiché stiamo eseguendo un'inversione lineare anziché una correzione fisica, le "probabilità" risultanti non sono necessariamente sempre positive. Quasi-probabilità negative molto piccole sono attese e riflettono il fatto che la mitigazione delle misure produce uno stimatore anziché una distribuzione di probabilità fisica.
# Explicit inversion is feasible only for very small systems
# This is why M3 avoids creating the entire A matrix.

A_inv = np.linalg.inv(A_2q)

# Note: mitigated_probs might contain negative values.
# This is expected and reflects estimator, not physical, probabilities.

mitigated_probs = A_inv @ raw_probs
print(mitigated_probs)
[ 4.96000451e-01 -4.69852308e-04 2.17747967e-04 5.04251654e-01]
Le convertiamo in conteggi per il grafico.
shots = sum(raw_counts.values())  # e.g., 5000
ideal_probs = [0.50, 0.00, 0.00, 0.50]  # ideal Bell distribution
# Convert probabilities to integer counts for plotting only.
# Not physically meaningful when probabilities are negative

def probs_to_counts(bitstrings, probs, shots):
    """
    Convert a probability vector into a Qiskit-style counts dictionary.
    Ensures integer shot counts and correct normalization.
    """
    counts = {}
    # First convert to raw integer counts
    int_counts = [round(p * shots) for p in probs]
    # Fix rounding error by adjusting the last entry
    diff = shots - sum(int_counts)
    int_counts[-1] += diff
    # Build dict
    for b, c in zip(bitstrings, int_counts):
        if c > 0:
            counts[b] = c
    return counts

mitigated_counts = probs_to_counts(bitstrings, mitigated_probs, shots)
ideal_counts = probs_to_counts(bitstrings, ideal_probs, shots)
Infine osserviamo le distribuzioni grezza, mitigata e ideale. I "conteggi" mitigati qui sotto sono solo un ausilio di visualizzazione ottenuto riscalando le quasi-probabilità mitigate.
from qiskit.visualization import plot_histogram

plot_histogram(
    [raw_counts, mitigated_counts, ideal_counts],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
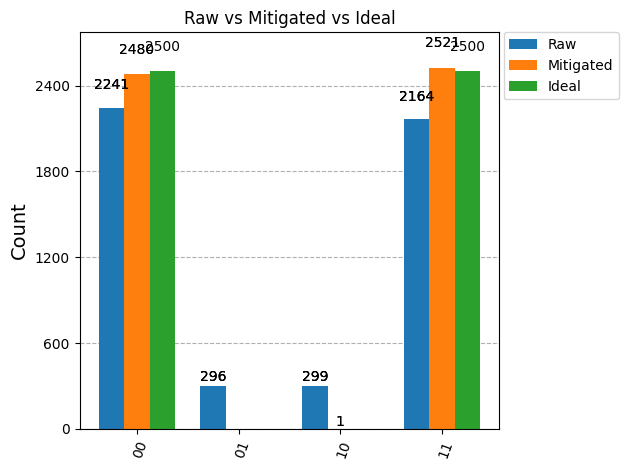
Chiaramente, i risultati mitigati con M3 sono molto più vicini alle distribuzioni ideali, e possiamo capire perché.
Applicare M3 a workflow più realistici è molto più complesso. Considera:
- I veri computer quantistici contengono molti qubit fisici, ciascuno con le proprie caratteristiche di errore di lettura. Questi errori devono essere modellati e combinati in modo appropriato.
- L'intera matrice di assegnazione cresce esponenzialmente con il numero di qubit e diventa rapidamente impraticabile da costruire esplicitamente. Per questo M3 si concentra sul sottoinsieme di esiti che contribuiscono in modo significativo alla distribuzione osservata anziché costruire l'intera matrice di assegnazione.
- Per i problemi reali di interesse, la distribuzione ideale potrebbe non essere nota.
Per tutti questi motivi, il workflow completo di mitigazione è incapsulato nell'addon di Qiskit mthree.
Esempio più grande di M3
Applichiamo ora M3 a un circuito più grande, per il quale determinare a mano il sottospazio rilevante di sarebbe laborioso, ma che è comunque abbastanza semplice da farci conoscere la distribuzione ideale: uno stato GHZ. Iniziamo importando il pacchetto mthree e definendo un circuito quantistico GHZ.
import numpy as np
from qiskit import QuantumCircuit

# from qiskit_ibm_runtime.fake_provider import FakeCasablancaV2
import mthree

num_qubits = 10

qc = QuantumCircuit(num_qubits)
qc.reset(range(num_qubits))
qc.h(0)
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)
qc.measure_all()
qc.draw("mpl")
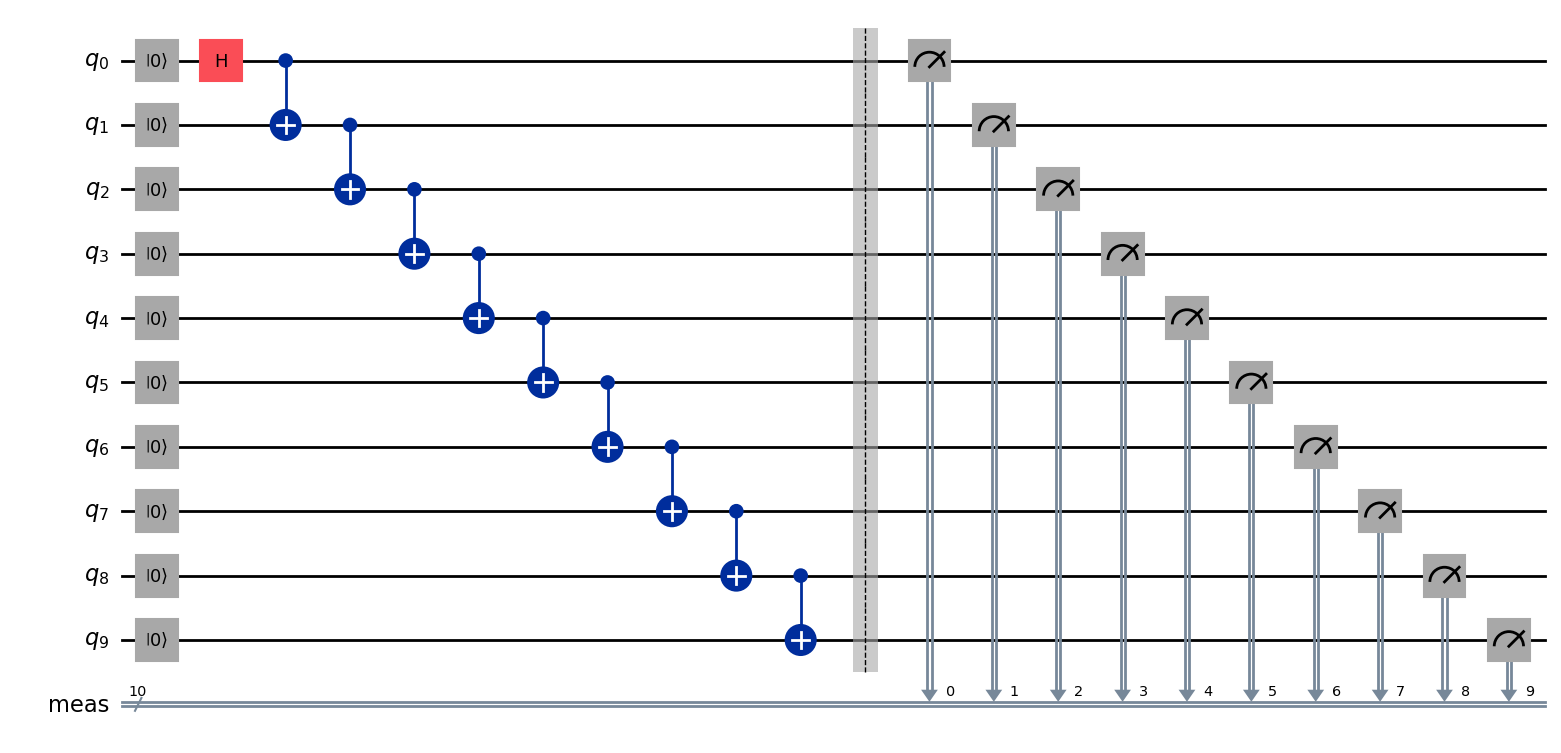
Per eseguirlo su un vero computer quantistico, importiamo qiskit_ibm_runtime e gli altri pacchetti necessari. Usiamo SamplerV2 per ottenere una distribuzione degli output.
# Import packages needed for using real quantum computers

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime.executor_sampler import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

# --------- Configuration ----------
service = QiskitRuntimeService(channel="ibm_quantum_platform", instance="your crn here")

# backend_real = service.backend("ibm_fez")     # adjust if needed
backend_real = service.least_busy(simulator=False, operational=True)
Ora transpiliamo il circuito sul nostro backend. Qui impostiamo il livello di ottimizzazione a 0 per concentrarci sugli effetti di M3, senza aggiungere altri strumenti. Questo significa che la fedeltà finale non sarà rappresentativa di ciò che è ottenibile sull'hardware IBM Quantum® usando l'intera suite di strumenti disponibili, ma ci permette di concentrarci specificamente sull'utilità di M3.
# Exclude any optimization to focus only on M3 effects
opt_level = 0
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend_real)
qc_isa = pm.run(qc)
Ora configuriamo il Sampler, disabilitando di nuovo le tecniche aggiuntive di soppressione degli errori come il dynamical decoupling e il twirling.
shots = 8192

# No twirling
sampler_no_twirl = Sampler(mode=backend_real)
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = False
sampler_no_twirl.options.default_shots = shots
sampler_no_twirl.options.dynamical_decoupling.enable = False
Infine, eseguiamo il nostro job.
# This job took 7 seconds on ibm_fez. Your actual execution time can vary.
job = sampler_no_twirl.run([qc_isa])
res_real = job.result()
job_id = job.job_id()
print("job number for real  ", job_id)
job number for real d7ark4e5nvhs73a2fu6g
Possiamo estrarre i conteggi grezzi dal circuito qui sopra.
counts_real = []
for i in range(len(res_real)):
    counts_real.append(res_real[i].data.meas.get_counts())
Ora eseguiamo mthree sul nostro backend per caratterizzare il modello di assegnazione usato per la mitigazione delle misure. Riscaliamo la distribuzione grezza usando queste informazioni. Nota che questo può talvolta produrre probabilità negative molto piccole (da cui il termine quasi-probabilità).
# Added 6 sec on ibm_fez, on top of original 7 sec to run circuits. Your time might differ.
mit_real = mthree.M3Mitigation(backend_real)
mappings_real = mthree.utils.final_measurement_mapping(qc_isa)
mit_real.cals_from_system(mappings_real)
quasis_real = mit_real.apply_correction(counts_real, mappings_real)
La correzione di mthree produce quasi-probabilità, anziché conteggi. Possiamo riscalare a conteggi a mano. La funzione di supporto qui sotto converte in conteggi e arrotonda a valori interi. Inoltre, per i circuiti grandi ci saranno molte stringhe errate con pochissimi conteggi, che però ingombrano un istogramma. La seconda funzione di supporto qui sotto elimina le stringhe con meno conteggi di una soglia scelta da noi, per darci una visione chiara dei termini dominanti della distribuzione.
def quasidistribution_to_counts(quasi_list, shots):
    return [
        {bitstr: int(round(float(prob) * shots)) for bitstr, prob in quasi.items()}
        for quasi in quasi_list
    ]

def filter_counts_by_threshold(counts_list, t):
    filtered = []

    for counts in counts_list:
        new_counts = {}
        for bitstr, val in counts.items():
            c = int(round(float(val)))  # FORCE conversion
            if abs(c) >= t:
                new_counts[bitstr] = c
        filtered.append(new_counts)

    return filtered
quasi_counts = quasidistribution_to_counts(quasis_real, shots)
trim_threshold = 30
trimmed_quasi = filter_counts_by_threshold(quasi_counts, trim_threshold)
trimmed_raw = filter_counts_by_threshold(counts_real, trim_threshold)
Possiamo anche produrre facilmente la distribuzione ideale teorica, in cui gli stati tutti-zero e tutti-uno hanno uguale probabilità e tutti gli altri esiti hanno probabilità zero, per il confronto.
ideal = [
    {
        "0" * num_qubits: int(round(float(shots) / 2)),
        "1" * num_qubits: int(round(float(shots) / 2)),
    }
]
Infine, possiamo visualizzare i nostri risultati.
from qiskit.visualization import plot_histogram

plot_histogram(
    [trimmed_raw[0], trimmed_quasi[0], ideal[0]],
    legend=["Raw", "Mitigated", "Ideal"],
    sort="asc",
    title="Raw vs Mitigated vs Ideal",
)
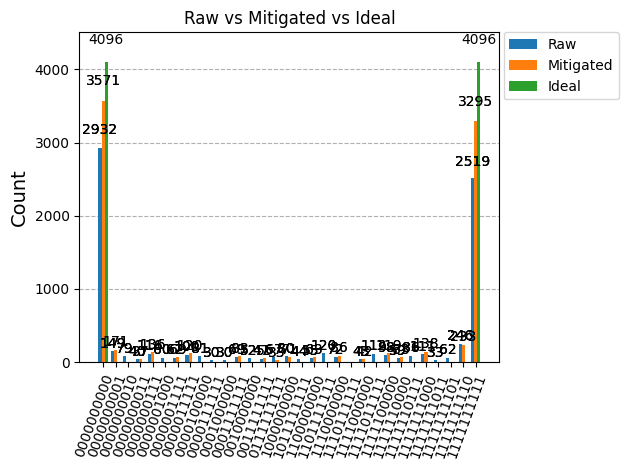
I risultati mitigati sono più vicini alla distribuzione ideale rispetto a quelli non mitigati. Possiamo quantificarlo meglio usando i conteggi per le bitstring ideali.
def extract_all_zero_and_all_one(counts):
    """
    Extract counts for the all-0 and all-1 bitstrings.

    Parameters
    ----------
    counts : dict[str, int]
        Counts dictionary.

    Returns
    -------
    dict[str, int]
        Dictionary containing only 00...0 and 11...1 entries if present.
    """
    n = len(next(iter(counts)))  # infer bitstring length
    zero_state = "0" * n
    one_state = "1" * n

    return {k: counts[k] for k in (zero_state, one_state) if k in counts}

correct_counts_raw = extract_all_zero_and_all_one(trimmed_raw[0])
correct_counts_mitigated = extract_all_zero_and_all_one(trimmed_quasi[0])
keys = ["0" * num_qubits, "1" * num_qubits]
fidelity_raw = (
    correct_counts_raw.get(keys[0]) + correct_counts_raw.get(keys[1])
) / shots
fidelity_mit = (
    correct_counts_mitigated.get(keys[0]) + correct_counts_mitigated.get(keys[1])
) / shots
print("Percent correct raw counts: ", fidelity_raw)
print("Percent correct mitigated counts: ", fidelity_mit)
Percent correct raw counts:  0.6654052734375
Percent correct mitigated counts:  0.838134765625
Questo semplice strumento ha migliorato la nostra fedeltà del 26% rispetto alla fedeltà non mitigata, con un overhead piuttosto basso. Chiaramente M3 può essere molto prezioso. Ma il circuito GHZ è stato scelto come buon caso d'uso perché è fortemente piccato su due stati di output. Alcuni problemi producono conteggi distribuiti in modo più uniforme (stati ad alta entropia). Per circuiti molto profondi con molti qubit, gli errori dei gate e il rumore non legato agli errori di misura porteranno spesso a uno stato ad alta entropia. In questi casi, M3 opera su uno spazio degli stati piuttosto grande. Ci sono tre approcci possibili:
(1) Accettare che questo sia un limite di M3.
(2) Nota che il limite superiore dello spazio della matrice formata da M3 è num_shots num_shots, anziché , e il primo è molto più piccolo per un grande numero di qubit .
(3) Solo con grande cautela, rimuovere dai conteggi grezzi forniti a M3 le bitstring con probabilità molto bassa. Ciò potrebbe introdurre un bias, e la limitazione del supporto dei tuoi stati può interferire con la convergenza in approcci come il metodo di Krylov. Va fatto solo quando sai esattamente perché lo stai facendo e puoi prevederne tutti gli effetti. Per questo tale eliminazione non è una funzionalità integrata di M3.
Per saperne di più sull'addon di Qiskit mthree, consulta esempi, istruzioni di installazione, contesto e riferimenti API nella sua documentazione.
Twirled readout error extinction (TREX)
Twirled Readout Error Extinction (TREX) è una tecnica di mitigazione degli errori di misura usata sui computer quantistici moderni. Il suo obiettivo è rimuovere il bias introdotto dagli errori di lettura classici senza richiedere la caratterizzazione completa o l'inversione della matrice di assegnazione delle misure.
TREX non è correzione degli errori e non migliora la fedeltà dello stato. Garantisce invece che gli stimatori dei valori di aspettazione siano privi di bias rispetto al rumore di lettura, fino all'errore statistico, mediando su basi di misura casuali e riscalando. Sull'hardware IBM Quantum, TREX è il metodo di mitigazione predefinito per la stima dei valori di aspettazione e corrisponde a resilience_level = 1 nella primitiva Estimator di IBM Quantum.
Natura degli errori di lettura sull'hardware superconduttore
Nei qubit superconduttori IBM, gli errori di lettura sono dominati da:
-
Probabilità di bit-flip asimmetriche (ad esempio, più frequente del contrario)
-
Rilassamento dipendente dallo stato durante la misura stessa
-
Crosstalk lieve ma non trascurabile tra risonatori di lettura vicini
È importante notare che questi errori possono spesso essere modellati come un processo stocastico classico che agisce sugli esiti delle misure. TREX sfrutta un'idea standard del noise tailoring: la randomizzazione (twirling) della procedura di misura. TREX procede tipicamente in due fasi:
-
Twirling e "untwirling" classico
-
Riscalamento dei valori di aspettazione tramite circuiti di calibrazione
Supponi che il valore di aspettazione di un'osservabile sia legato a stime rumorose, come segue:
dove è un fattore fisso che scala la stima e è un bias dovuto alle fonti descritte sopra. Usiamo qui come promemoria del fatto che stiamo trattando solo l'errore di lettura; resta ancora l'errore dei gate da considerare.
Subito prima della misura, ogni qubit viene coniugato in modo casuale con un operatore di Pauli (come I o X). Gli esiti delle misure vengono poi "untwirlati" in modo classico.
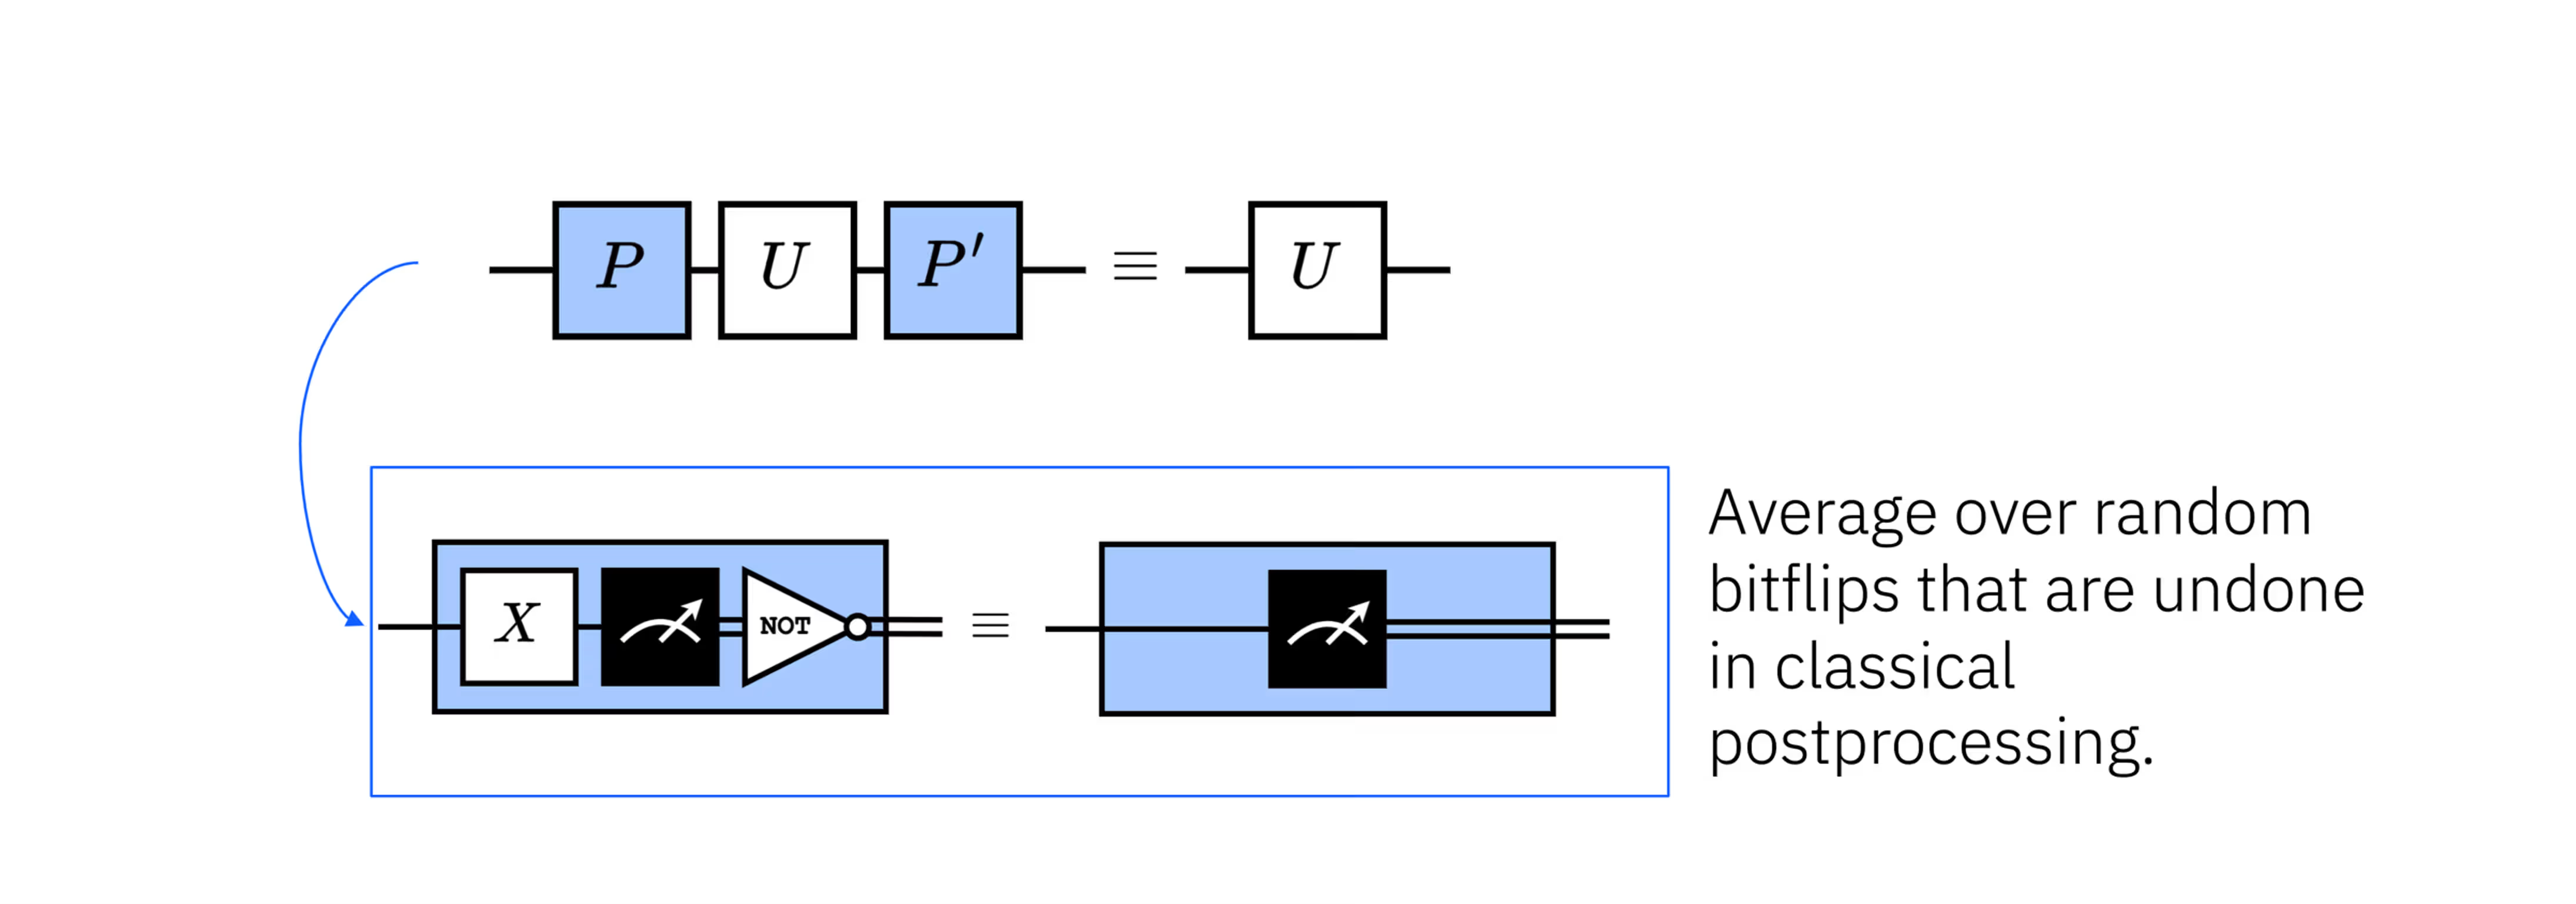
Mediare su queste randomizzazioni simmetrizza il canale di lettura. Di conseguenza, le asimmetrie sistematiche del processo di lettura vengono convertite in un canale di errore più simmetrico, il cui effetto residuo può essere trattato tramite calibrazione e riscalamento. In termini semplici, se ad esempio ci fosse un bias verso lo stato , perderemmo alcune misure di . Applicando il twirling attorno alla misura, scambiamo in modo casuale quale esito logico è associato al processo di lettura fisico, poi annulliamo quello scambio in modo classico. Mediare su molte di queste misure randomizzate elimina la preferenza sistematica per un esito riportato rispetto all'altro. Questo rimuove il bias di misura dominante sotto le ipotesi del modello TREX, così che abbiamo:
Tuttavia, i valori di aspettazione potrebbero comunque richiedere un riscalamento. La seconda fase consiste nell'usare circuiti di calibrazione (circuiti con esiti noti) per stimare il fattore di scala . Questo può poi essere usato per ottenere una stima molto migliorata.
I valori di aspettazione delle osservabili di Pauli diventano stimatori non distorti dei loro valori ideali. Non viene appreso né invertito alcun modello di rumore esplicito, ed è per questo che TREX è numericamente stabile e poco costoso. Ancora una volta, l'errore dei gate non è stato affrontato qui.
Nella stima di un valore di aspettazione di un'osservabile , può esserci varianza dovuta al campionamento finito, possono esserci molti tipi di errori incoerenti e coerenti, e può esserci anche un bias, , dovuto all'errore di lettura. Questo bias deriva da fonti come le transizioni asimmetriche di cui abbiamo parlato. In pratica, questo bias è tipicamente ben modellato come un canale stocastico classico che agisce dopo l'evoluzione quantistica. TREX trasforma il canale di misura effettivo in modo che lo stimatore di sia privo di bias rispetto all'errore di lettura. Questo è relativamente facile da vedere usando l'esempio più semplice di gate di twirling: X. Se c'è asimmetria in rispetto a , ma scambiamo in modo casuale quale stato viene letto (rimettendolo a posto in seguito, in modo classico), allora questo rimuove ovviamente l'asimmetria sistematica (anche se il campionamento finito implica comunque che possa restare una lieve asimmetria stocastica nella misura). In pratica, i gate di twirling per TREX non si limitano a I e X, ma questo basta per una spiegazione.
TREX ci permette di ottenere una stima di un valore di aspettazione priva di bias dovuto all'errore di lettura. Potrebbe comunque restare un bias da qualche altra fonte (come una sovra-rotazione coerente); TREX riguarda solo la lettura. Poiché TREX sostituisce il bias sistematico con una simmetrizzazione casuale, in genere converte il bias in varianza stocastica aggiuntiva, aumentando la varianza dello stimatore a costo di campionamento fisso.
Verifica la tua comprensione
Supponi di usare l'estimator su un circuito che ha preparato lo stato nella stima di . Supponi inoltre che gli errori di misura facciano sì che gli esiti corrispondenti a vengano riportati come nel 10% dei casi, mentre gli esiti corrispondenti a vengano riportati come solo nell'1% dei casi. L'asimmetria tra questi errori di riporto introduce un bias di misura.
(a) In assenza di tali errori di misura, quale sarebbe il valore di aspettazione ideale dell'osservabile ?
(b) Con gli errori di misura o di lettura asimmetrici, qual è il valore di aspettazione dell'osservabile ?
(c) Considera un insieme limitato di gate di twirling di Pauli: I e X. Supponi che I e X siano applicati in modo casuale con probabilità del 50% in più shot. Si applicano ancora gli stessi tassi di errore di misura. Poi il gate di Pauli (I o X) viene annullato in modo classico. Costruisci una tabella di tutti i possibili esiti e delle loro probabilità dovute alla sovrapposizione iniziale, agli errori di misura asimmetrici e ai gate di Pauli assegnati in modo casuale.
(d) Usa la tabella per determinare il valore di aspettazione con la strategia di twirling.
(e) Confronta i valori di aspettazione: ideale, senza twirling e con twirling.
(f) Che cosa è stato omesso da questa trattazione e si trova invece in un'applicazione completa di TREX?
Risposta
(a) Puoi semplicemente usare l'intuizione e la simmetria per dire che . Per mostrarlo esplicitamente:
(b) Lo stato potrebbe collassare su o su quando viene misurato, ciascuno con il 50% di probabilità. Ma del 50% che collassa sullo stato , l'1% (ovvero lo 0,5% di tutti i casi) verrà riportato erroneamente come . Del 50% che collassa su , il 10% (ovvero il 5% di tutti i casi) verrà riportato erroneamente come . Questo ci lascia con:
- 54,5%
- 45,5% Ignorando tutti gli altri tipi di errori possibili, otterremmo una stima di
(c)
| Pauli | Esito ideale della misura | Esito dopo Pauli | Errore di lettura | Annulla Pauli | Esito finale riportato | Probabilità |
|---|---|---|---|---|---|---|
| I | 0 | 0 | Nessuno | I | 0 | 50% 50% 99% = 24.75% |
| I | 0 | 0 | I | 1 | 50% 50% 1% = 0.25% | |
| I | 1 | 1 | Nessuno | I | 1 | 50% 50% 90% = 22.5% |
| I | 1 | 1 | I | 0 | 50% 50% 10% = 2.5% | |
| X | 0 | 1 | Nessuno | X | 0 | 50% 50% 90% = 22.5% |
| X | 0 | 1 | X | 1 | 50% 50% 10% = 2.5% | |
| X | 1 | 0 | Nessuno | X | 1 | 50% 50% 99% = 24.75% |
| X | 1 | 0 | X | 0 | 50% 50% 1% = 0.25% |
(d) Dalle parti precedenti conosciamo i valori di aspettazione di Z in ciascuno degli stati finali. Dobbiamo solo calcolare la media pesata:
(e) In questo caso molto semplice, la nostra applicazione del twirling ha recuperato esattamente il valore di aspettazione ideale. Non è tipico. Ciò che è tipico è che il twirling annulli bias come quelli introdotti dalle transizioni asimmetriche e restituisca un valore di aspettazione più vicino a quello ideale.
(f) Questa è un'applicazione di un modello semplificato. Potrebbero mancare diverse cose. In particolare, qui non abbiamo eseguito circuiti di calibrazione per stimare un fattore di riscalamento . Questo è tipicamente necessario.
Dettagli di implementazione
TREX viene applicato automaticamente quando si usa la primitiva EstimatorV2 con resilience_level = 1 (il valore predefinito). Nota che non viene applicato automaticamente alla primitiva Sampler, perché Sampler restituisce distribuzioni di probabilità complete anziché valori di aspettazione.
Quando TREX è abilitato, il runtime genera varianti dei circuiti con twirling della misura inserendo Pauli a singolo qubit casuali immediatamente prima della misura. La post-elaborazione classica inverte questi Pauli. Queste varianti di circuito sono casuali tra shot diversi e anche tra qubit diversi all'interno di uno shot. Tutte le varianti di circuito vengono poi combinate in un unico estimator.
TREX è molto scalabile. Richiede circuiti di calibrazione aggiuntivi, per cui l'overhead di campionamento è tipicamente un piccolo fattore costante (spesso 2-4x). Ma la mitigazione è specifica per l'osservabile, non preserva la distribuzione.
TREX è progettato per integrarsi in modo pulito con molti metodi di soppressione e mitigazione degli errori, tra cui i seguenti:
-
Dynamical decoupling (DD) - agisce durante i tempi di inattività, ortogonale alla mitigazione della lettura.
-
Twirling dei gate o di Pauli - spesso complementare; TREX si basa già sul twirling ma riguarda solo il rumore di lettura.
-
Zero-Noise Extrapolation (ZNE) - ZNE riguarda il rumore dei gate, mentre TREX gestisce il bias di misura. Questa combinazione è usata al livello di resilienza 2.
-
Probabilistic error amplification e probabilistic error cancellation nei workflow di Estimator.
Tuttavia, alcuni metodi non possono (o non dovrebbero) essere combinati con TREX:
-
Correzione delle probabilità a livello di Sampler: TREX non restituisce probabilità corrette delle bitstring.
-
Mitigazione post-hoc su dati TREX già mitigati: la doppia correzione può reintrodurre bias.
Combinare TREX con una mitigazione della lettura basata su matrici di assegnazione come M3 è complicato. M3 presuppone un canale di misura fisso. TREX randomizza deliberatamente la misura, invalidando l'assunzione usata da M3. In questo senso, non è possibile combinare semplicemente queste tecniche. Tuttavia, se applichi il twirling della misura durante la calibrazione usata in M3, potresti riuscire a sfruttare contemporaneamente sia un approccio simile alla matrice di assegnazione sia un approccio di mitigazione basato sul twirling (anche se questo approccio di twirling non è del tutto identico a TREX). Questo è un tema ricorrente nella combinazione di tecniche di mitigazione e soppressione: aggiungere tecniche alla cieca fallisce; aggiungerle con cura, in modo che siano "consapevoli" l'una dell'altra, può funzionare e può essere molto vantaggioso.
TREX garantisce solo valori di aspettazione privi di bias dovuto agli errori di lettura; non riduce la varianza, né protegge da altri tipi di bias. Certamente non corregge tutti gli errori. Tuttavia, spesso rappresenta un miglioramento sostanziale ed è ottenibile con un overhead molto inferiore rispetto ad altri metodi che richiedono di apprendere modelli di rumore completi. TREX è spesso la mitigazione della lettura più economica e robusta disponibile, il che lo rende un'ottima scelta predefinita negli esperimenti.
TREX con Qiskit
Qui creiamo un semplice circuito a due qubit e usiamo Estimator per stimare il valore di aspettazione di un'osservabile molto semplice, ZX. Il valore di aspettazione ideale è 1. Confronteremo i valori di aspettazione con e senza TREX.
# Import packages needed for using real quantum computers

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit_ibm_runtime import QiskitRuntimeService, EstimatorV2, Session
import numpy as np

# --------- Configuration ----------

backend = service.backend("ibm_fez")  # adjust if needed
Crea il semplice circuito quantistico.
qc = QuantumCircuit(2)
qc.x(0)
qc.h(0)
qc.cx(0, 1)
qc.h(0)
qc.barrier()
qc.draw("mpl")

Traspila il circuito usando un pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend)

qc_t = pass_manager.run(qc)
Applica all'osservabile lo stesso layout ottenuto dalla traspilazione.
# Observable: X on qubit 0, Z on qubit 1, ideal expectation value is 1.0.
observable = SparsePauliOp("ZX")
observable_t = observable.apply_layout(qc_t.layout)
Esegui l'esperimento su un vero computer quantistico. Per prima cosa procediamo con reslience_level = 1; questo è il valore predefinito, ma lo abbiamo reso esplicito per distinguere i due casi.
# First, we run this on an ideal simulator to confirm the ideal expectation value.

from qiskit.primitives import StatevectorEstimator as Estimator

estimator = Estimator()

job = estimator.run(pubs=[(qc, observable)])

res = job.result()
val = res[0].data.evs

print("⟨ZX⟩ ideal:", val)
⟨Z₀⟩ ideal: 0.9999999999999996
# This took 27 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ with TREX:", val)
⟨Z₀⟩ with TREX: 0.9520029143897996
Ora impostiamo resilience_level a 0 per eseguire senza TREX.
# This took 12 sec on ibm_fez. Your runtime might differ.
with Session(backend=backend) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observable_t)])

    res = job.result()
    val = res[0].data.evs

print("⟨ZX⟩ without TREX:", val)
⟨Z₀⟩ without TREX: 0.8651
Come previsto, il valore di aspettazione è sostanzialmente più vicino a quello ideale (1) con TREX. Naturalmente, si trattava di un singolo valore di aspettazione su un singolo qubit. Ora prepariamo un circuito che usa gate non Clifford e molti qubit per verificare se il miglioramento di TREX rimane robusto in un contesto diverso.
import numpy as np

num_qubits = 20
qc = QuantumCircuit(num_qubits)
for i in range(num_qubits):
    qc.rx(np.pi * 7 / 8, i)
qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=20, num_clbits=0, params=[]), qubits=(<Qubit register=(20, "q"), index=0>, <Qubit register=(20, "q"), index=1>, <Qubit register=(20, "q"), index=2>, <Qubit register=(20, "q"), index=3>, <Qubit register=(20, "q"), index=4>, <Qubit register=(20, "q"), index=5>, <Qubit register=(20, "q"), index=6>, <Qubit register=(20, "q"), index=7>, <Qubit register=(20, "q"), index=8>, <Qubit register=(20, "q"), index=9>, <Qubit register=(20, "q"), index=10>, <Qubit register=(20, "q"), index=11>, <Qubit register=(20, "q"), index=12>, <Qubit register=(20, "q"), index=13>, <Qubit register=(20, "q"), index=14>, <Qubit register=(20, "q"), index=15>, <Qubit register=(20, "q"), index=16>, <Qubit register=(20, "q"), index=17>, <Qubit register=(20, "q"), index=18>, <Qubit register=(20, "q"), index=19>), clbits=())
Qui non c'è nulla di speciale nell'angolo di rotazione . Abbiamo semplicemente scelto una qualsiasi sovrapposizione non uniforme di e per sondare gli effetti delle transizioni erronee asimmetriche e come vengono trattate da TREX. Dato questo stato, il valore di aspettazione ideale di Z su ogni qubit, in assenza di qualsiasi errore (di lettura o di altro tipo), sarebbe:
Speriamo quindi di ottenere valori di aspettazione vicini a -0.924 su tutti i qubit. Vedremo se TREX migliora ciascun valore di aspettazione singolarmente e anche se migliora la media su tutti i qubit.
Verifica la tua comprensione
Verifica il valore di aspettazione qui sopra tramite calcolo diretto.
Risposta
Traspiliamo usando un pass manager.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

pass_manager = generate_preset_pass_manager(optimization_level=1, backend=backend_real)

qc_t = pass_manager.run(qc)
Ora costruiamo un'osservabile per ogni qubit, in modo da poter stimare tutti e venti i valori di aspettazione in un unico workflow. Cioè, per l' qubit, vogliamo un'osservabile con tutte identità , tranne nella posizione , dove vogliamo una . Ricorda di applicare anche alle tue osservabili il layout ottenuto dalla traspilazione.
# Observables: Z on qubit i for all i.
observables = []
for i in range(num_qubits):
    obs_string = "I" * i + "Z" + "I" * (num_qubits - i - 1)
    obs = SparsePauliOp(obs_string)
    observables.append(obs)
observables_t = [obs.apply_layout(qc_t.layout) for obs in observables]
Ora possiamo eseguire. La cella di codice qui sotto usa la session mode; se non hai accesso alle sessioni, puoi sostituirla con la batch mode per eseguire lo stesso workflow, ma con possibili tempi di attesa in coda tra un circuito e l'altro.
# This took 20 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 0,  # TREX turned off
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_no_trex = job.result()
    val_no_trex = res_no_trex[0].data.evs

print("⟨Z_i⟩ without TREX:", val_no_trex)
⟨Z_i⟩ without TREX: [-0.90645 -0.89755 -0.89125 -0.9165  -0.87655 -0.91035 -0.8757  -0.87905
 -0.66035 -0.8876  -0.87125 -0.89975 -0.83745 -0.89755 -0.82645 -0.90325
 -0.84385 -0.90195 -0.85865 -0.8884 ]
# This took 36 sec on ibm_fez. Your runtime might differ.

with Session(backend=backend_real) as session:
    estimator = EstimatorV2(
        mode=session,
        options={
            "resilience_level": 1,  # TREX
            "default_precision": 0.005,
        },
    )

    job = estimator.run(pubs=[(qc_t, observables_t)])

    res_trex = job.result()
    val_trex = res_trex[0].data.evs

print("⟨Z_i⟩ with TREX:", val_trex)
⟨Z_i⟩ with TREX: [-0.92086303 -0.90253698 -0.91688854 -0.93308327 -0.91273953 -0.9221892
 -0.903782   -0.93046052 -0.90348934 -0.90284174 -0.89499677 -0.91630959
 -0.89508481 -0.92233292 -0.90497141 -0.91867138 -0.91421506 -0.91646851
 -0.9268364  -0.91669818]
Qui confrontiamo gli errori assoluti medi con e senza TREX.
ideal = np.cos(7 * np.pi / 8)

mean_abs_error_no_trex = np.mean(np.abs(val_no_trex - ideal))
mean_abs_error_trex = np.mean(np.abs(val_trex - ideal))

print("The mean absolute error without TREX is: ", mean_abs_error_no_trex)
print("The mean absolute error with TREX is: ", mean_abs_error_trex)
The mean absolute error without TREX is:  0.05238453251128674
The mean absolute error with TREX is:  0.011980732757900719
zx = list(range(num_qubits))
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(zx, val_no_trex, c="blue", linestyle="-", label="No TREX", alpha=0.7)

## Add values with DD
ax.scatter(zx, val_trex, c="red", linestyle="-", label="With TREX", alpha=0.7)

# Add ideal reference line
ax.axhline(y=-0.924, color="black", linestyle="--", linewidth=2, label="Ideal ⟨Z⟩")

# Add labels and plot
ax.set_xlabel("Qubits")
ax.set_ylabel("<Z>")
ax.legend()
ax.set_title("<Z> in RX(7pi/8)|0> state with and without TREX")
ax.grid(True)

plt.show()
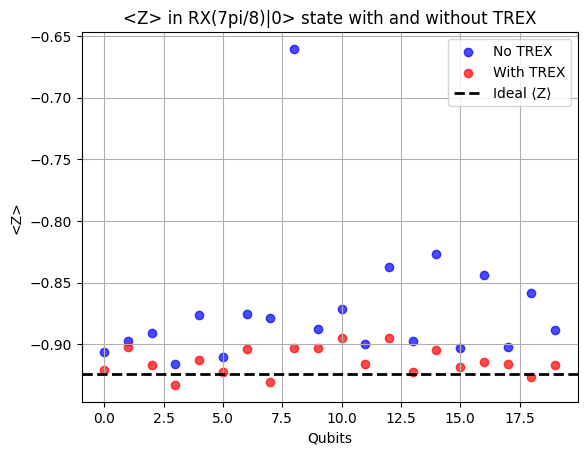
TREX sembra certamente aver aiutato. Il valore di aspettazione su ogni qubit è migliorato, con la sola eccezione del qubit 16. Un simile valore anomalo è da aspettarsi. Possiamo quantificare l'effetto complessivo di TREX sul circuito calcolando i valori medi.
mean_no_trex = sum(val_no_trex) / num_qubits
mean_trex = sum(val_trex) / num_qubits

print("Mean without TREX", mean_no_trex)
print("Mean with TREX", mean_trex)
Mean without TREX -0.8714950000000001
Mean with TREX -0.9137729590315635
In media, TREX ha avvicinato i nostri risultati a quelli ideali di circa il 2.9% e ci ha lasciato con un risultato che, in media, differisce dall'ideale teorico di appena lo 0.4%. È un ottimo risultato, e proprio questo miglioramento a basso overhead è il motivo per cui TREX è la mitigazione degli errori predefinita su Estimator. Ma dobbiamo sottolineare ancora una volta che TREX rimuove un bias nell'errore di lettura, non corregge tutti i nostri errori. Abbiamo scelto uno stato iniziale con buone probabilità di essere influenzato dall'asimmetria nella lettura. L'effetto sarebbe stato diverso se avessimo preparato ogni qubit in uno stato diverso. Per un argomento banale sul perché debba essere così, considera cosa accadrebbe se lasciassimo ogni qubit nello stato fondamentale . Non ci sarebbe alcuna possibilità di osservare (o correggere) un'asimmetria nell'errore di lettura tra gli stati e .
Zero-noise extrapolation (ZNE)
La zero-noise extrapolation (ZNE) è una delle tecniche di mitigazione degli errori più utilizzate. Anche la strategia generale è facile da capire, sebbene i dettagli della sua implementazione siano complessi. ZNE funziona così:
-
Esegue un circuito target a più "livelli di rumore" — modifiche al circuito che fanno scalare il suo rumore in modo prevedibile
-
Stima l'osservabile di interesse per ciascuna scala di rumore.
-
Estrapola fino a rumore zero usando un modello di fit (lineare, polinomiale, esponenziale e così via).
Il risultato è una stima di quale sarebbe stata l'osservabile nel limite di rumore zero implicito nel modello di estrapolazione.
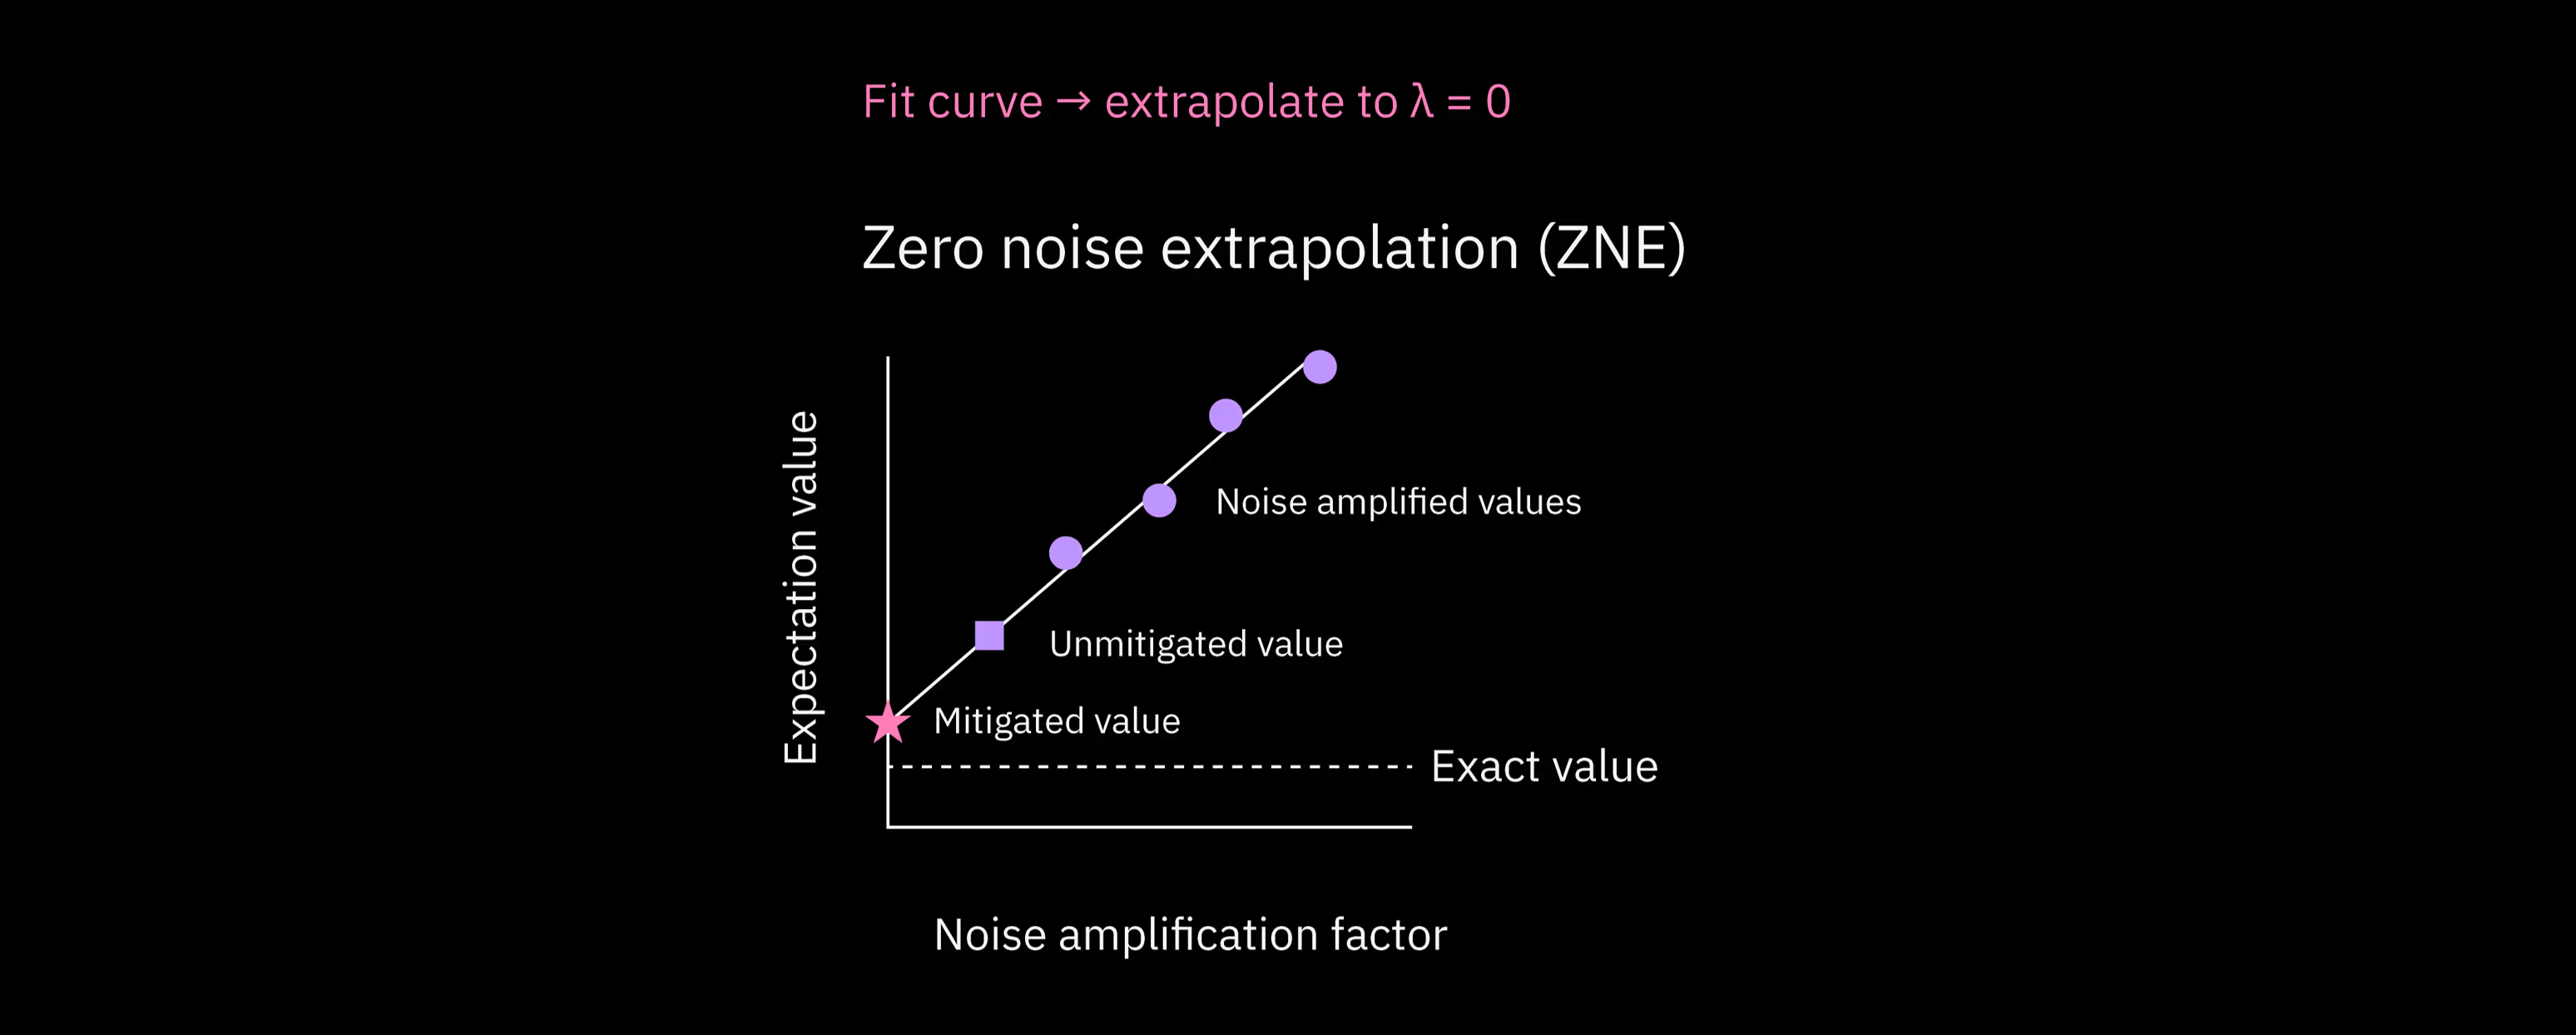
ZNE non garantisce che il rumore aumenti in modo regolare o lineare quando modifichiamo i circuiti. Piuttosto, assume che la scala del rumore si comporti abbastanza bene da consentire l'estrapolazione. La complessità di ZNE sta nel modo in cui si modificano i circuiti per soddisfare questa assunzione il meglio possibile. In questa lezione esamineremo alcuni approcci.
Scalabilità delle risorse in ZNE
In ZNE, l'overhead è principalmente un overhead quantistico. Cioè, per ottenere valori di aspettazione a livelli di rumore, devi eseguire il tuo esperimento su circuiti, ciascuno con molti shot. Per mantenere una precisione statistica fissa, il numero totale di campioni in genere aumenta man mano che si introducono circuiti con rumore scalato aggiuntivi.
Il numero di livelli di rumore che esamini, , dipenderà dal metodo usato per scalare il rumore. Per una semplice tecnica di scalatura del rumore (chiamata "gate-folding", discussa più avanti), è comunemente compreso tra 3 e 5. Un metodo diverso (probabilistic noise amplification (PNA)) consente fattori di rumore non interi e in genere produce livelli di rumore inferiori rispetto al gate-folding. L'overhead totale scala approssimativamente come:
dove è il numero di shot di base. Un'altra cosa da tenere a mente è che, se la scalatura del rumore comporta gate ripetuti, la profondità del circuito potrebbe aumentare di un fattore proporzionale al valore di scalatura del rumore. La scalatura del rumore che deriva dall'aumento della profondità è proprio lo scopo, ma tieni a mente la profondità totale.
ZNE è adatta a problemi in cui valgono i seguenti punti:
-
Hai bisogno di un metodo di mitigazione generico, efficace su molti tipi di errore.
-
La profondità del circuito non è troppo grande; ZNE fallisce quando il circuito scalato diventa troppo rumoroso per essere estrapolato.
-
Puoi tollerare un moderato overhead di runtime in cambio di una maggiore accuratezza.
In pratica questo rende ZNE ideale per molti circuiti variazionali, per la stima di valori di aspettazione e per altri algoritmi quantistici a breve termine. È implementata in Estimator usando resilience_level = 2. Nota che ZNE estrapola in uno spazio che ha un unico risultato in funzione del rumore in tutto il circuito. Ciò significa che si presta ai problemi di stima, ma non ai problemi di campionamento. Non è progettata per funzionare su distribuzioni di bitstring.
Fattori di rumore
Come possiamo aumentare esattamente il livello di rumore in un circuito? Ci sono due modi principali, sebbene esistano molte varianti.
-
Sostituire un gate o un blocco di gate con . Poiché i gate sui computer quantistici sono unitari, sappiamo che , per cui logicamente: . Tuttavia, ogni ripetizione di o aggiunge un errore simile o identico, permettendoci di aumentare i livelli di rumore/errore. Nota che la sostituzione mostrata sopra ci porta dal rumore originale del gate (livello di rumore 1) a tre volte quel livello di rumore in (livello di rumore 3). In pratica, possiamo ripetere gli ultimi due gate volte: per ottenere un livello di rumore . Questo si chiama gate folding ed è una tecnica di scalatura del rumore molto comune.
-
Esistono altri metodi per aumentare il livello di rumore, come la probabilistic error amplification (PEA). In PEA, per prima cosa si apprende un modello di rumore adatto al circuito, tipicamente espresso come canale di Pauli. Il rumore viene poi amplificato campionando da una versione riscalata di questo canale di rumore appreso. Regolando il campionamento, puoi scalare in modo continuo l'intensità effettiva del rumore, anche a valori non interi.
In pratica, il gate folding può scalare gli errori in modo molto affidabile, ma può anche portare a circuiti molto profondi. Se ti servono solo tre livelli di rumore (1, 3 e 5), significa aumentare la profondità del circuito di un fattore 5 e ottenere comunque risultati ragionevoli. Quindi, se il tuo circuito target ha una profondità a due qubit, dopo la traspilazione, di 60 o più, PEA è probabilmente più adatta del gate-folding.
I gate possono essere ripiegati localmente (cioè ripetendo per ogni gate a due qubit non appena si presenta), oppure possono essere raggruppati in un blocco di gate e il blocco può essere ripetuto (come i gate ). Spesso il folding locale è preferibile in vista delle assunzioni fatte da ZNE, ma entrambi sono possibili.
Il trattamento statistico dei risultati a rumore scalato in ZNE richiede molte sfumature. Per esempio, al quintuplo del livello di rumore i tuoi risultati avranno sicuramente varianza maggiore e saranno meno affidabili. Dovrebbero essere trattati con lo stesso peso dei punti dati a rumore inferiore? No. Tuttavia, per vedere ZNE in azione, ignoreremo parte di questa complessità in un esperimento con un modello giocattolo, in cui costruiremo a mano i circuiti ripiegati e faremo un'estrapolazione ingenua con pesi uguali per illustrare i passaggi chiave. Faremo però seguire un esperimento che usa la funzionalità ZNE integrata in Qiskit, e vedremo che gestisce in modo sostanzialmente migliore la complessità che stiamo saltando.
ZNE a mano
Iniziamo selezionando un circuito quantistico e un'osservabile per cui possiamo calcolare il valore di aspettazione ideale in assenza di rumore ed errori. Scegliamo uno stato GHZ , con un numero pari di qubit. La nostra osservabile è . La scegliamo per diversi motivi:
- Il valore di aspettazione è banale da calcolare nel caso ideale. Poiché il numero di qubit è pari, otteniamo un
1da ogni , moltiplicati insieme, oppure un-1da ogni , moltiplicati insieme un numero pari di volte. - Sarà piuttosto sensibile a errori e rumore, poiché un singolo errore su un qubit può far passare il risultato complessivo di quello shot da +1 a -1.
- Il valore di aspettazione è lontano da 0. ZNE può incontrare difficoltà quando il valore di aspettazione ideale è molto vicino a zero, perché livelli di rumore elevati tendono a randomizzare i risultati, rendendoli positivi tanto spesso quanto negativi. Il risultato è che valori di rumore elevati finiranno per dare valori vicini a quello ideale; questo può rendere l'estrapolazione molto delicata.
Tenendo presente questa motivazione, costruiamo i nostri circuiti.
from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
num_qubits = 10  # must be even

# # Noise amplification factors used for folding (2* integer +1 for gate folding)
noise_steps = [1, 3, 5]
ghz_amp = []

for j in noise_steps:
    qc = QuantumCircuit(num_qubits)
    qc.h(0)
    # Since CX^2 = I, odd repetitions implement folded versions of the gate.
    for i in range(num_qubits - 1):
        for gates in range(j):
            qc.cx(i, i + 1)
    qc.barrier()
    ghz_amp.append(qc)
Nota la sottigliezza per cui qui . Anche se il gate folding era stato presentato come composto da operatori della forma , qui la stessa struttura appare come CNOT CNOT CNOT.
Verifichiamo che il nostro circuito sia davvero il normale circuito GHZ:
ghz_amp[0].draw("mpl")
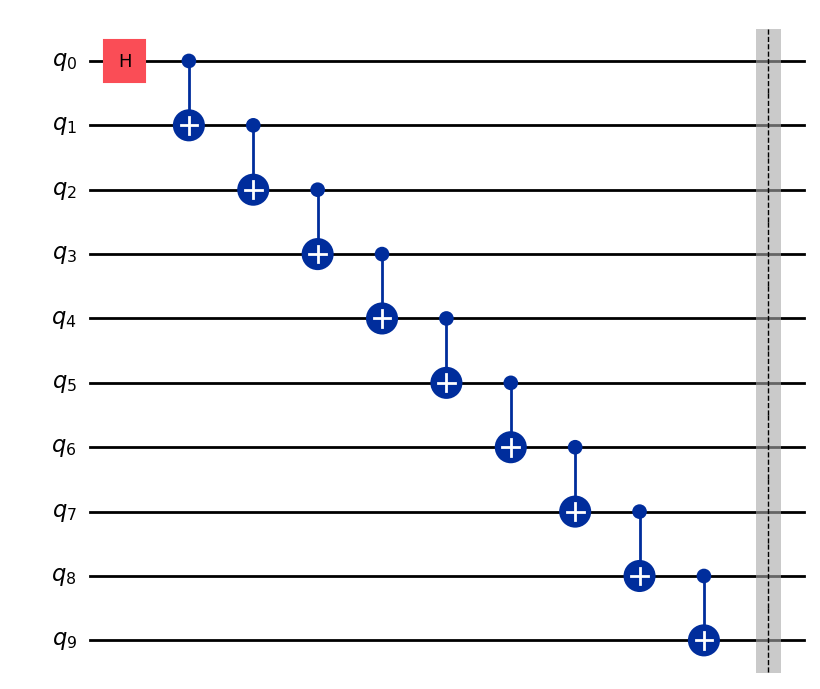
Puoi guardare gli altri circuiti per verificare che abbiano la struttura attesa.
Ora costruiamo le nostre osservabili.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
observables = []
for j in range(len(noise_steps)):
    observables.append(observable)
Costruiamo un pass manager e lo applichiamo ai nostri circuiti. Poi prendiamo i layout e li applichiamo alle nostre osservabili.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=0,
)

qcs_transpiled = []
obs_transpiled = []

for j in range(len(ghz_amp)):
    # Transpile the circuit
    qc_pm = pm.run(ghz_amp[j])
    qcs_transpiled.append(qc_pm)
    # Extract the final layout
    layout = qc_pm.layout
    # Apply the layout to the observable
    obs_transpiled.append(observable.apply_layout(layout))
Formatta i pubs.
pubs = [(qc, obs) for qc, obs in zip(qcs_transpiled, obs_transpiled)]
Ora eseguiamo Estimator. Vorremmo concentrarci sul ruolo di ZNE, e quindi potremmo voler impostare resilience_level = 0 per evitare di confondere gli effetti del twirling con l'effetto di ZNE. Tuttavia, vogliamo anche confrontare la nostra ZNE "a mano" con le impostazioni ZNE integrate in Qiskit, che includono il twirling. Impostiamo quindi qui resilience_level = 1. Impostando resilience_level = 2 si invocano le impostazioni ZNE di Qiskit, che useremo a breve.
# This took 21 sec on ibm_fez. Your actual runtime might vary.
options = EstimatorOptions(resilience_level=1)

estimator = Estimator(
    mode=backend_real,
    options=options,
)

job = estimator.run(pubs)

res = job.result()
Ora stampiamo i livelli di rumore e i valori di aspettazione.
# We save this for later comparisons
value_no_zne = res[0].data.evs

# Print all values used for extrapolation
print("Noise level 1: ", res[0].data.evs)
print("Noise level 3: ", res[1].data.evs)
print("Noise level 5: ", res[2].data.evs)
Noise level 1:  0.8327970939283861
Noise level 3:  0.5612869745718734
Noise level 5:  0.3130254281266217
Questa è la parte in cui siamo più disinvolti: eseguiamo un fit lineare su questi dati senza prestare alcuna attenzione alla varianza di ciascun valore ottenuto e senza provare a prevedere teoricamente se il fit debba essere lineare. Ancora una volta, la ZNE integrata fa un lavoro molto migliore di quello che stiamo facendo a mano.
# Data
noise_factors = np.array([1, 3, 5])
values = np.array([res[0].data.evs, res[1].data.evs, res[2].data.evs])

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.12994291645044112
Zero-noise extrapolated value: 0.9588652482269501
Procediamo a tracciare il grafico prima dell'interpretazione.
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Zero-noise estimate")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
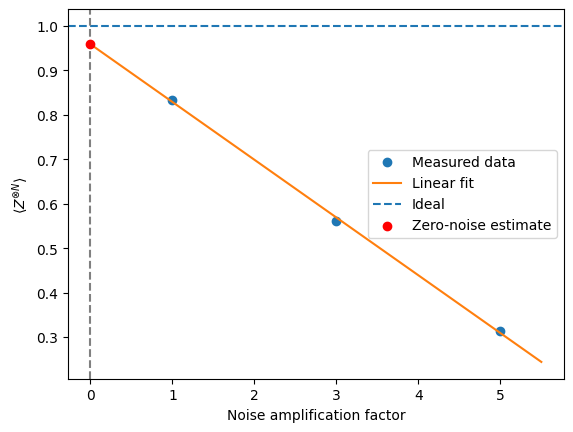
Al momento della realizzazione di questa lezione, dall'estrapolazione al caso di rumore zero otteniamo un valore di aspettazione di 0.959. I tuoi valori potrebbero differire. Questo è sostanzialmente meglio del valore di aspettazione del circuito grezzo, 0.83, circa il 13% più vicino al valore ideale. Ma puoi anche vedere che stiamo usando un punto dati in cui il valore di aspettazione era sceso a 0.31. Ovviamente questo punto dati è di qualità inferiore. Se a quel punto dati fosse stato dato un peso minore nella nostra approssimazione lineare, e la retta fosse stata adattata maggiormente ai primi due punti dati, vediamo che la stima estrapolata a zero sarebbe stata più alta (più vicina al valore ideale). Questo tipo di considerazione viene gestito automaticamente nella ZNE integrata in Estimator.
ZNE integrata in Estimator
Vediamo ora cosa succede quando usiamo la funzionalità ZNE integrata in Estimator. Iniziamo definendo un semplice circuito GHZ, senza alcun gate folding.
num_qubits = 10  # must be even

qc = QuantumCircuit(num_qubits)
qc.h(0)

for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

qc.barrier()
CircuitInstruction(operation=Instruction(name='barrier', num_qubits=10, num_clbits=0, params=[]), qubits=(<Qubit register=(10, "q"), index=0>, <Qubit register=(10, "q"), index=1>, <Qubit register=(10, "q"), index=2>, <Qubit register=(10, "q"), index=3>, <Qubit register=(10, "q"), index=4>, <Qubit register=(10, "q"), index=5>, <Qubit register=(10, "q"), index=6>, <Qubit register=(10, "q"), index=7>, <Qubit register=(10, "q"), index=8>, <Qubit register=(10, "q"), index=9>), clbits=())
Definiamo la stessa osservabile di prima.
pauli_string = "Z" * num_qubits
observable = SparsePauliOp(pauli_string)
Definiamo ancora una volta un pass manager, usando optimization_level = 1. Torneremo su questa scelta più avanti.
pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)
Traspila il circuito e applica il layout alle osservabili.
# Transpile the circuit
qc_transpiled = pm.run(qc)

# Extract the final layout
layout = qc_transpiled.layout

# Apply the layout to the observable
obs_transpiled = observable.apply_layout(layout)
Eseguiamo Estimator usando ZNE e twirling, e confrontiamo i risultati con la nostra implementazione di ZNE a mano. In particolare, li confrontiamo con il risultato senza ZNE (value_no_zne).
# This used 18 sec on ibm_fez. Your actual QPU time might vary.

options_zne = {
    "resilience_level": 2,
    "resilience": {
        "zne": {
            "noise_factors": [1, 3, 5],
        }
    },
    "twirling": {
        "enable_gates": True,
        "enable_measure": True,
        "num_randomizations": "auto",
    },
}

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
Possiamo recuperare i valori a ciascun fattore di rumore con la sintassi job_zne.result()[0].data.evs_noise_factors. Come prima, potremmo usare ingenuamente questi risultati per ottenere un fit lineare ed estrapolare al caso di rumore zero, ma l'estimator con resilience_level = 2 ha già fatto un lavoro migliore, tenendo conto della varianza e di altre considerazioni. Di seguito mostriamo cosa produrrebbe un'estrapolazione lineare e cosa ha effettivamente prodotto la ZNE integrata.
# Data
noise_factors = np.array([1, 3, 5])
values_qiskit_zne = np.array(job_zne.result()[0].data.evs_noise_factors)

# Linear fit: E(lambda) = m * lambda + b
coeffs = np.polyfit(noise_factors, values_qiskit_zne, deg=1)
slope, intercept = coeffs

print(f"Best-fit slope: {slope}")
print(f"Zero-noise extrapolated value: {intercept}")
Best-fit slope: -0.11745451044574956
Zero-noise extrapolated value: 0.9045922788100509
print("Exp val ideal: 1.0")
print("Exp val with no ZNE: ", value_no_zne)
print("Exp val with ZNE: ", value_zne)
print("Fractional improvement: ", (value_zne - value_no_zne) * 100 / 1.0, "%")
Exp val ideal: 1.0
Exp val with no ZNE:  0.8327970939283861
Exp val with ZNE:  0.9877508802932561
Fractional improvement:  15.495378636487 %
import matplotlib.pyplot as plt

x_fit = np.linspace(0, 5.5, 100)
y_fit = slope * x_fit + intercept
y_ideal = 1.0

plt.figure()
plt.plot(noise_factors, values, "o", label="Measured data")
plt.plot(x_fit, y_fit, "-", label="Linear fit")
plt.axhline(y_ideal, linestyle="--", label="Ideal")
plt.axvline(0, linestyle="--", color="gray")
plt.scatter(0, intercept, color="red", zorder=3, label="Linear")
plt.scatter(0, value_zne, color="black", zorder=3, label="Proper ZNE")

plt.xlabel("Noise amplification factor")
plt.ylabel(r"$\langle Z^{\otimes N} \rangle$")
plt.legend()
plt.show()
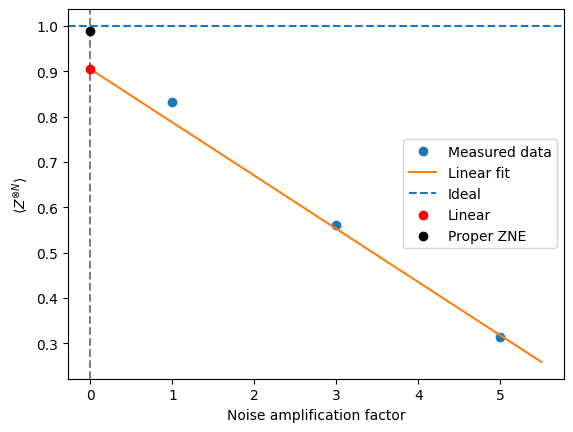
Vediamo che la ZNE integrata ha migliorato la nostra stima di oltre il 15% e ha funzionato decisamente meglio del nostro tentativo a mano.
Prima di proseguire, nota che durante tutta questa esplorazione di ZNE abbiamo impostato optimization_level = 1 nel pass manager. Livelli di ottimizzazione più alti riducono l'errore, e a volte la riduzione dell'errore può rendere gli errori meno prevedibili nella scalatura. Come spesso accade, c'è un equilibrio: riduci gli errori, tranne quando li stai aumentando intenzionalmente di un fattore noto.
Combinare i metodi
ZNE si basa su quanto segue:
-
Un parametro di scalatura del rumore ben definito
-
Una scalatura dei valori di aspettazione con sufficientemente regolare e prevedibile
-
Lo stesso canale di rumore effettivo, a intensità diverse
-
Nessun bias introdotto che non scali con
ZNE si combina bene con tecniche che rimuovono bias non scalanti (come M3) o rendono il rumore più regolare (come il twirling), ma è in conflitto con tecniche che tentano di cancellare del tutto il rumore (PEC) o di rimodellarlo dinamicamente (DD).
In particolare, M3 affronta solo l'errore di misura/lettura, che in pratica può essere trattato separatamente dagli errori dei gate (che sono il fulcro dei processi di scalatura degli errori in ZNE). M3 è in gran parte indipendente dal gate folding; può essere combinato senza problemi con ZNE. TREX è molto simile e può essere combinato con ZNE.
Il Pauli twirling, a differenza di M3 e TREX, si concentra sui gate. Tuttavia, ricorda che il Pauli twirling non mitiga direttamente errore/rumore; piuttosto, lo cambia per renderlo più prevedibile. Il Pauli twirling potrebbe in realtà essere utile al processo ZNE, rendendo gli errori dei gate più lineari nella scalatura e quindi l'estrapolazione più accurata.
Il dynamical decoupling (DD) è più sfumato. DD altera dinamicamente il comportamento del rumore annullando parzialmente certi errori tramite l'aggiunta di sequenze di gate. Se è possibile costruire i circuiti in modo tale che DD si comporti allo stesso modo anche quando i gate o i blocchi sono ripiegati, allora in linea di principio si potrebbero combinare ZNE e DD, ma in pratica DD a volte interferisce con la scalatura. Se vuoi combinarli, le cose da considerare includono le seguenti:
- DD viene applicato in modo coerente a tutti i livelli di rumore?
- Il folding preserva la struttura di DD?
- La scalatura del rumore risultante si comporta ancora in modo monotono?
L'ultimo metodo di mitigazione degli errori che discuteremo come approccio a sé stante non è compatibile con ZNE: la probabilistic error cancellation.
Probabilistic Error Cancellation (PEC)
A differenza di ZNE o della mitigazione della misura, PEC tenta di cancellare il rumore a livello di gate ricostruendo in aspettazione il canale ideale. La Probabilistic Error Cancellation (PEC) è la tecnica di mitigazione degli errori più potente e più costosa trattata in questa lezione. PEC si basa sull'inversione esplicita del canale di rumore, eseguita statisticamente anziché fisicamente. PEC funziona così:
-
Caratterizza il modello di rumore in termini di una base di "operazioni di errore".
-
Esprime l'inverso del canale di rumore come distribuzione di quasi-probabilità su operazioni fisiche.
-
Campiona da questa distribuzione durante l'esecuzione del circuito per costruire statisticamente una stima non distorta del calcolo ideale.
Concettualmente, PEC è come una correzione degli errori virtuale — "annulla" il rumore combinando operazioni rumorose in schemi casuali pesati con cura. Dal punto di vista procedurale, tuttavia, PEC non è strettamente legata ai codici di correzione o rilevazione degli errori. La stima non distorta di PEC del valore di aspettazione ideale e privo di rumore ha il costo di un overhead di campionamento molto grande e di una forte dipendenza da una caratterizzazione accurata del rumore.
Sui computer quantistici IBM, PEC è vista al meglio come uno strumento di precisione anziché come un livello di mitigazione generico: è più appropriata per circuiti piccoli o piccole porzioni di circuiti più grandi, attività di benchmarking e studi ad alta accuratezza in cui un elevato overhead quantistico è accettabile.
Caratterizzare il canale di rumore
In PEC, ogni gate ideale di un circuito quantistico è modellato come un canale unitario ideale seguito da un processo di rumore. Sia la matrice densità dello stato quantistico. Il gate ideale è rappresentato da una matrice unitaria , che induce un canale quantistico:
Su hardware reale, questa evoluzione ideale è corrotta dal rumore. Modelliamo l'implementazione fisica del gate come un canale rumoroso effettivo:
dove è un canale di rumore che cattura gli errori stocastici associati al gate. In tutta questa discussione, , ed sono mappe lineari che agiscono sugli operatori densità. Il canale ideale è unitario e reversibile, mentre il canale di rumore (e quindi ) è una mappa completamente positiva che preserva la traccia (CPTP).
PEC assume che il canale di rumore sia noto o approssimativamente noto. Sull'hardware IBM Quantum, questa informazione si ottiene tipicamente dai dati di calibrazione del dispositivo, dai tassi di errore dedotti da esperimenti di benchmarking e da modelli di rumore semplificati, come le approssimazioni di Pauli o depolarizzanti per piccoli insiemi di gate. Sebbene PEC non richieda un modello di rumore perfettamente accurato, le sue prestazioni peggiorano rapidamente man mano che il canale di rumore assunto si discosta dal comportamento reale dell'hardware.
Decomposizione in quasi-probabilità del canale di rumore inverso
L'idea centrale di PEC è cancellare in aspettazione l'effetto del rumore costruendo un'approssimazione stocastica dell'inverso del canale di rumore. Formalmente, l'obiettivo è applicare una mappa lineare che annulli approssimativamente , in modo che:
in aspettazione su molte esecuzioni del circuito.
L'inverso è qui definito come l'inverso algebrico di trattato come superoperatore lineare che agisce sugli operatori. Questo inverso esiste solo se ha rango pieno; i processi di rumore non invertibili non possono essere mitigati esattamente con PEC.
Quando l'inversione è possibile, PEC esprime il canale di rumore inverso come una combinazione lineare di operazioni fisicamente implementabili:
Qui, ogni è un'operazione rumorosa che può essere eseguita sull'hardware (tipicamente gate nativi o brevi sequenze di gate), e i coefficienti reali formano una distribuzione di quasi-probabilità. A differenza delle probabilità ordinarie, i coefficienti possono essere negativi o superare 1.
La norma di quasi-probabilità:
quantifica il costo dell'inversione del rumore. Per qualsiasi canale di rumore non banale, . Sull'hardware IBM Quantum, questa decomposizione viene tipicamente eseguita:
- per singolo gate o per piccolo insieme di gate,
- assumendo modelli di rumore ristretti (spesso approssimazioni diagonali di Pauli),
- usando operazioni native specifiche del backend e vincoli di scheduling.
Ricostruzione Monte Carlo del circuito ideale
Per stimare il valore di aspettazione di un'osservabile , PEC usa un campionamento Monte Carlo basato sulla decomposizione precedente. Per ogni occorrenza di un gate rumoroso nel circuito, si applica la seguente procedura:
-
Seleziona casualmente un'operazione con probabilità:
-
Assegna un peso classico:
-
Esegui il circuito rumoroso randomizzato risultante sul backend quantistico.
-
Moltiplica il risultato misurato per il prodotto di tutti i pesi accumulati.
-
Fai la media dei risultati pesati su molte esecuzioni del circuito.
Lo stimatore risultante soddisfa
purché il modello di rumore descriva accuratamente l'hardware. PEC non introduce quindi alcun bias sistematico in aspettazione, ma sostituisce il bias con una grande varianza statistica. Ogni esecuzione produce una stima rumorosa ma pesata; solo dopo aver mediato molte di queste esecuzioni emerge il valore di aspettazione ideale.
Interpretazione concettuale
PEC è talvolta descritta come correzione degli errori virtuale. Sebbene questa formulazione non sia del tutto errata, non va confusa con la vera correzione degli errori quantistici. PEC non comporta alcuna codifica logica, alcuna estrazione della sindrome e alcun feedback in tempo reale. Gli errori non vengono prevenuti né corretti durante l'esecuzione del circuito.
Invece, PEC cancella il rumore statisticamente, combinando molte realizzazioni rumorose del circuito con pesi classici con segno, in modo che gli errori si cancellino solo dopo il post-processing classico. L'informazione non è protetta durante l'esecuzione; i risultati ideali vengono ricostruiti a posteriori.
Scalabilità delle risorse e costo
Il costo dominante di PEC deriva dall'amplificazione della varianza. La varianza dello stimatore PEC scala come:
cioè:
Questa scalatura è fondamentale e non può essere migliorata tramite post-processing classico.
Per circuiti contenenti molti gate rumorosi, ciascun gate contribuisce con un fattore , facendo crescere la norma di quasi-probabilità totale in modo approssimativamente moltiplicativo:
dove è la profondità del circuito. Sull'hardware IBM Quantum, questo porta tipicamente a una crescita esponenziale del costo di campionamento con la profondità del circuito, con una sensibilità particolarmente forte agli errori dei gate a due qubit. Questa scalatura pone limiti pratici all'applicabilità di PEC.
PEC è attualmente pratica solo quando si verificano una o tutte le seguenti condizioni:
-
I circuiti sono molto piccoli o poco profondi (spesso gate),
-
I modelli di rumore sono semplici e ben validati (per esempio, rumore di Pauli),
-
Un elevato costo statistico è accettabile,
-
L'obiettivo è l'accuratezza anziché il throughput.
Per questo motivo, PEC viene spesso applicata a:
-
Sottocircuiti isolati all'interno di workflow più grandi,
-
Passi di evoluzione a tempo breve,
-
Routine di preparazione dello stato o di misura,
-
Esperimenti di benchmarking e di validazione.
Lo stack software IBM (IBM Quantum Compute e gli strumenti di mitigazione degli errori) lo riflette trattando PEC come un'opzione specializzata, non come un livello di mitigazione predefinito.
I casi d'uso tipici di PEC includono:
-
Benchmarking di precisione dell'hardware quantistico,
-
Verifica di piccoli algoritmi quantistici,
-
Chimica quantistica ad alta accuratezza su sistemi ridotti,
-
Controllo incrociato di ZNE o di altri metodi di mitigazione.
Relazione di PEC con altri metodi di mitigazione
Molte altre tecniche di mitigazione sacrificano l'accuratezza in favore della scalabilità; PEC fa esattamente l'opposto, puntando sull'accuratezza prima di ogni altra cosa.
Poiché PEC potrebbe essere usato solo su un sottocircuito, qui è particolarmente importante chiedersi quali altri metodi di mitigazione possano essere combinati con esso. Per ragionare con chiarezza sulla compatibilità con PEC, è utile classificare le tecniche in base a ciò che fanno al rumore. Considera queste categorie generali:
-
Cancellazione del rumore: tenta di invertire i canali di errore
-
Scalatura del rumore: aumenta deliberatamente il rumore per estrapolare
-
Rimodellamento del rumore: modifica la struttura o lo spettro del rumore
-
Rimozione del bias: corregge gli errori che non scalano con il rumore dei gate
PEC rientra a pieno titolo nella categoria (1). Qualsiasi metodo che modifichi o riscali il canale di rumore deve essere esaminato con attenzione.
Tabella riassuntiva (alto livello)
| Tecnica | Compatibile con PEC | Note |
|---|---|---|
| ZNE | No | Annullare contro scalare e, a volte, adattare l'errore |
| Pauli twirling | Sì (con cautela) | Influisce sul comportamento dell'errore, ma potrebbe renderlo più facile da apprendere |
| TREX | Sì | Nessuna sovrapposizione nel flusso di lavoro. Pienamente compatibile. |
| Dynamical decoupling | Di solito no | Modifica il canale di errore |
PEC e ZNE affrontano le stesse fonti di errore (errori dei gate) tramite assunzioni o flussi di lavoro reciprocamente incompatibili, o entrambi. Ad esempio, in ZNE assumiamo che l'errore possa essere espanso in un parametro :
e che l'errore possa essere scalato in modo efficace per modellare questa espansione. PEC annullerebbe proprio l'errore su cui facciamo affidamento per la scalatura. Il parametro diventerebbe privo di significato. Un altro modo di pensarci è il seguente:
-
Applicare ZNE prima di PEC modifica il canale di rumore che stai cercando di invertire.
-
Applicare PEC prima di ZNE rimuove proprio il rumore su cui ZNE si basa per estrapolare.
PEC e ZNE vanno considerati paradigmi alternativi di mitigazione degli errori, non livelli componibili. Confrontarli fianco a fianco è istruttivo, mentre combinarli non lo è.
PEC e Pauli twirling sono in generale compatibili e spesso vantaggiosi. Il twirling può aiutare PEC perché converte gli errori coerenti in errori di Pauli stocastici. Questo semplifica il canale di rumore, rendendolo più facile da rappresentare e invertire. Per PEC ciò è estremamente prezioso, per i seguenti motivi:
-
Le decomposizioni quasi-probabilistiche sono molto più semplici per i canali di Pauli
-
La norma quasi-probabilistica è spesso significativamente più piccola
-
La varianza di campionamento si riduce
Molte dimostrazioni di PEC assumono o incorporano un rumore sottoposto a Pauli twirling. È importante chiarire che il Pauli twirling non mitiga gli errori da solo; rimodella il rumore in una forma che la probabilistic error cancellation può gestire in modo più efficiente.
PEC può e dovrebbe essere combinato con TREX. Questi approcci sono pienamente compatibili e svolgono ruoli ortogonali. TREX opera solo sulla misura, rimuove il bias di lettura tramite twirl randomizzati del canale di misura e non influisce sul rumore dei gate né sulla dinamica del circuito. PEC opera sul rumore dei gate. Poiché l'errore di misura è additivo anziché composizionale, è indipendente dalle sequenze di gate. È sicuro, e spesso auspicabile, applicare TREX insieme a PEC.
L'ordine di questi metodi è quello che ti aspetteresti:
- Esegui il circuito randomizzato di PEC
- Applica TREX per mitigare l'errore di lettura
- Applica la ponderazione e la media di PEC
PEC e DD sono in generale incompatibili, a meno che la caratterizzazione del rumore usata per PEC non venga eseguita con DD attivo. PEC assume che sia stazionario, ripetibile e caratterizzabile con accuratezza. DD rimodella esplicitamente il canale di rumore nel tempo modulando le interazioni sistema-ambiente e introducendo effetti non banali di temporizzazione degli impulsi. Di conseguenza, il rumore effettivo con DD non è lo stesso canale che si ha senza DD. A complicare ulteriormente le cose, il canale di rumore può dipendere in modo sensibile dalla schedulazione del circuito. Il risultato finale è che l'inversione del rumore diventa mal definita o non valida.
In teoria è possibile caratterizzare il rumore con DD attivo e costruire di conseguenza un modello PEC, ma questo è molto avanzato e al momento non è un flusso di lavoro raccomandato.
Applicare PEC a mano
PEC è complesso e non è consigliabile implementarlo a mano. Tuttavia, vogliamo svolgere i calcoli di un'applicazione di base su un singolo qubit per capire quali passaggi comporta il processo. Scegliamo uno stato misto ma non banale, in modo da vedere chiaramente gli effetti numerici.
Considera un qubit che dovrebbe trovarsi nello stato puro
La matrice densità ideale è:
Abbiamo scelto questa matrice densità perché non è diagonale ed è per un solo qubit, così che sia trattabile esaminarla "a mano".
Applichiamo ora un modello di rumore molto semplice ma realistico: un canale depolarizzante a singolo qubit, con piccola intensità .
Per semplificare l'aritmetica, prendiamo . Questo canale è completamente positivo e preserva la traccia (CPTP), come deve essere. È un canale di rumore realistico per l'hardware reale, o almeno realistico per descrivere una parte del rumore. Inoltre, questo canale di rumore è analiticamente invertibile, come mappa lineare. In altre parole, esiste una matrice inversa, ma ciò non significa che tale matrice corrisponda a un canale fisico CPTP, e certamente non corrisponde a un'unitaria implementabile su hardware.
Applichiamo ora il nostro canale depolarizzante alla matrice densità del singolo qubit e otteniamo:
Con : e .
So:
Applicandolo al nostro stato:
Calcoliamo esplicitamente:
Questa è ancora una matrice densità fisica e ha ancora traccia uno — ma ora è più mista.
Calcoliamo ora il canale inverso ideale, tenendoci ben pronti alla possibilità che non sia fisico. Verificheremo se lo è. Matematicamente, la mappa lineare inversa è:
Se questa azione inversa fosse a sua volta un canale fisico valido, saremmo tentati di provare a implementarla esattamente. Naturalmente dovremmo comunque capire come implementarla usando operazioni unitarie e passaggi classici, ma questo sarebbe l'obiettivo. Tuttavia, risulta che essa non è CPTP, e in generale non c'è alcuna garanzia che tali mappe inverse siano CPTP. Questo è fondamentale per la nostra discussione attuale, perché è il motivo per cui PEC esiste.
Potresti riuscire a vedere che non è CPTP semplicemente osservandola. Una verifica infallibile consiste nell'applicarla a una matrice densità e vedere se restituisce risultati fisici. Questo è lasciato come esercizio per verificare la tua comprensione.
Verifica la tua comprensione
Verifica se la mappa inversa vista sopra è CPTP applicandola a una nuova matrice densità:
Interpreta i risultati come fisici o non fisici.
Risposta
Come matrice densità fisica, questa corrisponde a una probabilità classica maggiore di 1 che il sistema si trovi nello stato e a una probabilità negativa che si trovi nello stato . Chiaramente questa mappa può produrre matrici densità prive di senso. Inoltre, per ispezione possiamo vedere che gli autovalori della matrice densità risultante sono 1.0625 e -0.0625, il che significa che non tutti gli autovalori sono positivi. Quindi la mappa non è "completamente positiva", la "CP" di CPTP.
Verifica la tua comprensione
Verifica con un calcolo esplicito che l'operazione inversa vista sopra annulli il canale di rumore e restituisca lo stato privo di rumore.
Risposta
Applicala allo stato rumoroso:
Questo è esattamente lo stato originale (a meno di arrotondamenti).
Ribadiamo per essere assolutamente chiari: non possiamo invertire esattamente il canale di rumore; l'inversa non è CPTP, né è un canale fisico valido. Tuttavia, possiamo invertire in modo efficace il canale come combinazione lineare di canali fisici.
Per il canale depolarizzante:
dove: ecc.
L'inversa può essere scritta come:
with:
-
= canali di Clifford fisicamente implementabili
-
= quasi-probabilità
-
Some
Questa è l'idea centrale di PEC:
-
Campiona i canali secondo ∣
-
Associa i segni ai risultati delle misure
-
I valori di aspettazione convergono al valore privo di rumore
Applichiamo PEC "a mano" alla stima di usando la matrice densità e vediamo se riusciamo a recuperare i risultati per . Per ci aspettiamo:
Nota inoltre che per la matrice densità rumorosa otteniamo:
È l'ordine di grandezza giusto, ma significativamente lontano dal caso ideale.
Vediamo ora passo per passo come, con il processo PEC, possiamo ricostruire il valore di aspettazione non distorto a partire dalla matrice densità rumorosa. Nei flussi di lavoro reali questo è probabilistico e sarà automatizzato. In questo flusso di lavoro "a mano" sceglieremo valori probabilistici realistici, ma forse comodi per la nostra presentazione. Questo non va inteso come un'affermazione che PEC sia perfetto. Serve semplicemente a mostrarti uno scenario plausibile che potrebbe verificarsi all'interno dei pacchetti PEC.
Ricorda che il nostro canale di rumore ha la forma:
L'inversa può essere scritta (esattamente):
based on symmetry of the transformation and the completeness of the Pauli operators. Inverting the noise channel somehow in the estimation process should yield an estimator that is unbiased and normalized. To do this, we must at least determine the coefficents and and then think about how to implement the inverse transformation. When done by a noise learner, the inversion of this noise channel would be done at the channel level, independent of a specific case like our density matrix. The coefficients and would come from this inversion.
Per questa introduzione è più semplice concentrarsi sull'effetto del canale sulla nostra matrice densità. Questo ci permette di lavorare con oggetti familiari come matrici densità e valori di aspettazione. A tal fine, considera cosa deve essere vero riguardo agli effetti di questa operazione inversa sul nostro processo di stima: lo stimatore prodotto da PEC deve essere normalizzato e non distorto. Ciò corrisponde a due condizioni:
-
Normalizzazione: per garantire che questa operazione non cambi la scala dell'osservabile, richiediamo che . Per capire perché è così, potremmo considerare l'azione dell'inversa su una matrice densità, oppure la sua azione sul valore di aspettazione di qualcosa di banale come stesso.
-
Calibrazione: in un flusso di lavoro reale usiamo circuiti di calibrazione per apprendere il comportamento del rumore a livello di gate. Usiamo poi la conoscenza del comportamento del rumore a livello di gate e la linearità dei valori di aspettazione per applicare il modello di rumore appreso al circuito più grande. Nel nostro caso siamo partiti dalla conoscenza artificiale che il valore di aspettazione ideale è . Ma sarebbe molto facile trovare uno stato per cui sappiamo teoricamente che questo sarebbe il valore ideale, e poi usare misure reali per la calibrazione. Un punto chiave è che, per PEC, di solito non si apprende un modello di rumore completo dell'intero circuito. Si apprendono invece modelli di rumore locali per i singoli gate o per i singoli livelli del circuito e li si usa per costruire la decomposizione quasi-probabilistica.
Usiamo queste condizioni per determinare e . Consideriamo l'ansatz
and apply it to an arbitrary single-qubit density matrix .
Ricorda che i canali di Pauli agiscono per coniugazione:
Applicando a si ottiene:
Prendendo la traccia, otteniamo:
Ogni operatore di Pauli è unitario, per cui la coniugazione preserva la traccia:
Therefore,
Affinché lo stimatore PEC sia normalizzato, la mappa inversa effettiva deve preservare la traccia di tutte le matrici densità. Cioè, richiediamo:
Questo implica il vincolo di normalizzazione:
Ma nel nostro caso, ciò produce la condizione:
Ora usiamo le informazioni di calibrazione per mettere in relazione il valore di aspettazione osservato con quello ideale noto.
Or equivalently,
Risolvendo le nostre due condizioni per e , otteniamo:
Questi coefficienti sommano a 1, ma uno di essi è negativo.
Possiamo recuperare il valore di aspettazione ideale modificando casualmente il circuito, misurando, moltiplicando il risultato per un peso con segno e facendo la media. In particolare, non viene ricostruita alcuna matrice densità e non viene implementato fisicamente alcun canale inverso.
Il passaggio chiave: questo è PEC
Per la nostra intensità di rumore , il canale inverso può essere scritto come:
Fatti importanti:
-
I coefficienti sommano a 1
-
Un coefficiente è negativo
-
Ogni termine è fisicamente implementabile
-
La negatività si sposta nel post-processing classico
Formiamo una distribuzione di campionamento a partire dai valori assoluti dei pesi:
(per ciascuno tra X, Y, Z)
Peso totale:
Per le probabilità di campionamento, dividi per W.
| Operazione | Probabilità | Segno |
|---|---|---|
| Non fare nulla () | 1.1875 / 1.375 ≈ 0.864 | + |
| Applica X | 0.0625 / 1.375 ≈ 0.045 | - |
| Applica Y | 0.0625 / 1.375 ≈ 0.045 | - |
| Applica Z | 0.0625 / 1.375 ≈ 0.045 | - |
Il segno deriva dal coefficiente originale, non dalla probabilità.
Ogni shot consiste nei seguenti passaggi:
-
Prepara lo stato
-
Lascia che l'hardware applichi il circuito rumoroso
-
Scegli casualmente un'operazione dalla tabella sopra usando le probabilità associate
-
Apply it
-
Misura , ottenendo
-
Moltiplica il risultato per
-
Registra quel numero
Vediamo ora esempi di alcuni shot.
Shot 1 (caso identità)
Supponiamo che l'operazione scelta casualmente sia l'identità (o, equivalentemente: non fare nulla). Sulla base delle argomentazioni e della tabella sopra, questo accadrà l'86.4% delle volte. Poiché il coefficiente di nell'inversa del canale di rumore è positivo, selezioniamo il segno . La nostra misura di Z potrebbe facilmente dare . Supponiamo che dia .
Il contributo corretto con PEC di questo shot sarebbe:
Shot 2 (di nuovo identità)
Supponiamo di ottenere di nuovo come operazione casuale (quindi il segno del termine è ancora inizialmente ), ma questa volta la nostra misura di Z dà . Questa volta il contributo è:
Shot 3 (scelta X)
Questa volta la nostra operazione casuale è X. Questo termine nell'inversa è negativo, quindi manteniamo il segno . Applichiamo X e poi misuriamo Z. Anche qui potremmo ottenere uno qualsiasi dei due autovalori; supponiamo di ottenere . Il contributo di questo termine è:
Shot 4 (scelta Z)
L'operazione casuale è Z. Questo ci dà il segno dalla tabella. Supponiamo di misurare Z e ottenere . Il contributo è:
Shot 5 (scelta Y)
L'operazione casuale è Y. Questo ci dà il segno dalla tabella. Supponiamo di misurare Z e ottenere . Il contributo è:
Media dei risultati
Immagina di raccogliere molti risultati di questo tipo ponderati con PEC:
Per costruzione, applichiamo l'identità l'86.4% delle volte. Applichiamo ciascuno degli altri gate il 4.5% delle volte. In un flusso di lavoro reale, non conosciamo gli stati sottostanti precisi, né l'intero canale di rumore. Ma conosciamo il fattore di ponderazione visto sopra e la probabilità relativa con cui applichiamo ciascuna operazione. In un flusso di lavoro reale, ci affidiamo alla matrice densità sconosciuta per ottenere i risultati delle misure. Verificheremo qui che questa procedura produrrebbe i risultati corretti.
Vogliamo calcolare la media di tutte le misure ponderate e con segno, incluse le applicazioni degli operatori di Pauli prima della misura. Chiamiamo il numero totale di tutti gli shot. Chiamiamo l'insieme di tutti gli shot per cui è stato applicato il Pauli e usiamo per indicizzare questi shot. Chiamiamo il risultato della misura del shot con l'applicazione dell' Pauli. Possiamo scrivere questa media come:
L'operatore di Pauli viene applicato in modo probabilistico con probabilità . Nel limite di un numero elevato di shot,
Possiamo usarlo per scrivere:
dove è il valore di aspettazione di Z solo sull'ensemble di shot in cui è stato applicato . Questo è utile perché sappiamo quale deve essere ciascuno di questi valori di aspettazione a partire dalla matrice densità. Di nuovo, in un flusso di lavoro reale, questo emergerebbe dalla misura, non da una matrice densità nota.
Verifica la tua comprensione
Verifica i valori di aspettazione riportati sopra tramite calcolo o ragionamento logico.
Risposta
Y e Z procedono esattamente come sopra.
Ora possiamo riscrivere il nostro valore di aspettazione complessivo come:
Se conosciamo i parametri e del rumore dei nostri gate (o più parametri per canali di rumore più complessi), questo è sufficiente per determinare (1) il fattore di peso complessivo e (2) le probabilità con cui dobbiamo applicare gli operatori di Pauli. Il risultato qui sopra mostra che, facendo così, mitighiamo il rumore e recuperiamo valori di aspettazione non distorti. La media su tutti questi shot è convergita a , anche se:
-
I singoli shot danno contributi maggiori di ±1
-
Alcuni shot hanno peso statistico negativo
-
Ogni operazione quantistica era fisica
Panoramica del workflow PEC
Nella PEC, tutti i passaggi sul computer quantistico sono:
-
Apprendimento del rumore
-
Preparazione dello stato per il tuo circuito di destinazione
-
Applicazione probabilistica dei gate di Pauli come descritto sopra
-
Measurement
La mappa inversa effettiva del rumore viene realizzata statisticamente nella post-elaborazione classica. Ciò consente un'inversione più generale dei canali di rumore che altrimenti avrebbe richiesto passaggi non fisici come probabilità negative.
Il prezzo che paghiamo per questo è la varianza. Ogni shot aveva in precedenza una "magnitudine" pari alle magnitudini dei possibili risultati di misura . Dopo il ridimensionamento con il fattore di peso , ha magnitudine (1.375 nel nostro esempio sopra).
Questa è l'origine dell'overhead di campionamento della PEC.
PEC integrata
Ora useremo la PEC così com'è integrata nei primitive di IBM Quantum. Qui è fondamentale distinguere tra la PEC completa a livello di gate e un modello locale di apprendimento del rumore per una PEC più scalabile, che è quello usato dai primitive di IBM Quantum. L'overhead della PEC completa ne limiterebbe l'applicazione a circuiti piccoli. Va bene, ma è più utile avere uno strumento che possa scalare fino a una dimensione in cui il calcolo quantistico diventa prezioso per problemi del mondo reale. Per questo motivo, i primitive di IBM Quantum usano una PEC a livello di layer con un modello di rumore di Pauli-Lindblad appreso, con rigorose salvaguardie di scalabilità. In questa implementazione della PEC, il rumore viene appreso per ogni layer di circuito ripetuto, non per ogni istanza di gate, e il modello di rumore è con Pauli twirling, locale e markoviano. I gate di Clifford vengono assorbiti nel modello di rumore, mentre i gate non di Clifford dominano il costo della mitigazione. L'overhead di campionamento è limitato per evitare crescite esponenziali.
Applicheremo la PEC integrata nei primitive di IBM Quantum a due scale: piccola (sei qubit) e media (30 qubit), per vedere come il costo viene tenuto sotto controllo in questa versione della PEC. Per ogni dimensione dell'esperimento, confronteremo anche esplicitamente i risultati della PEC con quelli senza mitigazione, con la ZNE e con il valore ideale.
Iniziamo importando alcuni pacchetti necessari.
import numpy as np

from qiskit import QuantumCircuit
from qiskit.quantum_info import SparsePauliOp, Statevector

# from qiskit_aer import AerSimulator
from qiskit.transpiler import generate_preset_pass_manager

from qiskit_ibm_runtime import (
    # QiskitRuntimeService,
    Estimator,
    EstimatorOptions,
)
Scegliamo un'osservabile da stimare. L'osservabile qui sotto è l'hamiltoniana di una catena di spin di tipo Ising con accoppiamento solo tra primi vicini nella componente della loro interazione e un termine a singolo qubit in , come se fosse dovuto a un campo esterno in .
Non c'è un motivo particolare per la scelta di questa hamiltoniana. Ci serve semplicemente una combinazione di osservabile e circuito non banale, in modo che la mitigazione degli errori possa fare il suo lavoro. Scaliamo esplicitamente l'hamiltoniana (usando i coefficienti), dividendo per il numero di qubit in modo che l'energia resti dello stesso ordine di grandezza all'aumentare del numero di qubit. Iniziamo con soli sei.
# This cell builds the observable

num_qubits = 6

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)
Come per la scelta dell'hamiltoniana, il circuito per la preparazione dello stato qui sotto non è scelto per ragioni fisiche. È scelto invece per avere una profondità a due qubit sufficiente e abbastanza gate non di Clifford da rendere utile la PEC. Non c'è motivo di pensare che questo circuito sia una buona approssimazione dello stato fondamentale di questa catena di spin, ad esempio.
qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.5, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)
qc.rz(3.141592653589793 / 8, 2)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")
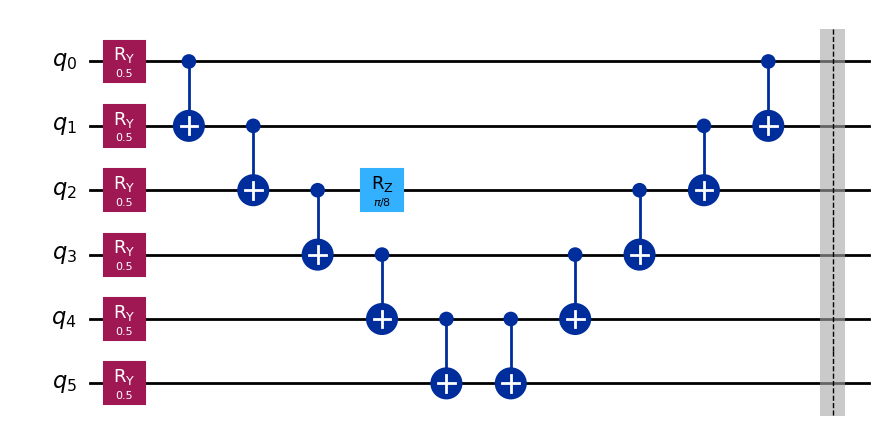
Traspiliamo il nostro circuito e applichiamo il layout risultante alle nostre osservabili.
# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)
Otteniamo il valore di aspettazione ideale usando il simulatore Statevector.
# Compute the ideal final state
state = Statevector.from_instruction(qc)

# Compute expectation value
ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.6651408876730361
Ci aspettiamo che gli altri valori ideali abbiano dimensioni simili. Ora eseguiamo questo su un vero computer quantistico IBM senza alcuna mitigazione degli errori.
# This took 3 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.569677734375
Ora applichiamo la ZNE allo stesso problema.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.6573718927156127
Infine, applichiamo la PEC.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

from qiskit_ibm_runtime.options import EstimatorOptions

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

result = job_pec.result()
value_pec = result[0].data.evs

print("PEC:", value_pec)
PEC: 0.6666196849843695
Qui sotto tracciamo i nostri risultati e li confrontiamo.
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
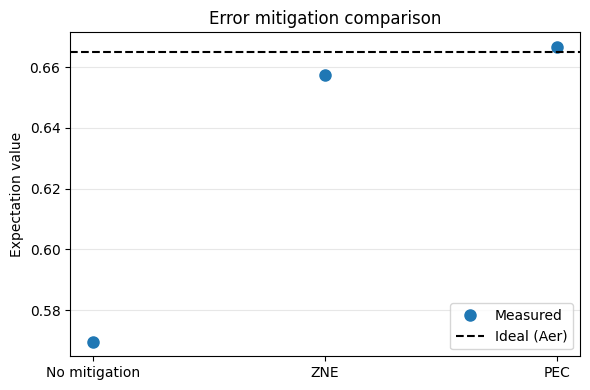
Ha funzionato molto bene. La nostra stima con la PEC dista solo lo 0.2% dal valore ideale.
Ma ricorda che l'overhead quantistico cresce in modo esponenziale. Abbiamo imposto un overhead massimo di max_overhead = 100. Dal tempo e dalla qualità dei risultati, sembra che potremmo non aver raggiunto quel massimo. Tuttavia, se aumentiamo la scala del calcolo mantenendo quel massimo, lo raggiungeremo e i nostri risultati ne risentiranno.
Possiamo vedere cosa succede quando portiamo il nostro circuito a 30 qubit. È interessante notare che su molti laptop il simulatore Statevector inizia ad andare in timeout intorno ai 24-28 qubit. Potremmo trovare modi computazionali per aggirare il problema. Ma abbracciamo invece il fatto che i computer quantistici saranno in grado di risolvere alcuni problemi su una scala che i computer classici non riescono a seguire. Questo è il punto. Cosa possiamo fare, allora, per convalidare i nostri risultati di calcolo quantistico in questi casi? Ci sono diverse risposte possibili:
- Alcuni problemi sono difficili da risolvere ma facili da verificare (come la fattorizzazione in numeri primi nell'algoritmo di Shor).
- Alcuni problemi hanno regimi di parametri o varianti che riducono la complessità e possono essere risolti in modo classico, o persino analitico, per confrontare alcuni punti. In questo caso, abbiamo scelto un'hamiltoniana intrinseca (abbiamo diviso per il numero di qubit). Il valore di aspettazione ideale dovrebbe essere abbastanza stabile. Vediamo come varia il valore di aspettazione ideale con il numero di qubit e se possiamo fare previsioni classiche sul valore a 30 qubit.
import numpy as np
import matplotlib.pyplot as plt

from qiskit import QuantumCircuit
from qiskit.quantum_info import Statevector, SparsePauliOp

num_qubits_max = 24

qubits = [4, 8, 12, 16, 20, 24]
exp_vals = []
for num_qubits in qubits:
    qc = QuantumCircuit(num_qubits)

    for i in range(num_qubits):
        qc.ry(0.7, i)
    for i in range(num_qubits - 1):
        qc.cx(i, i + 1)
    for i in range(num_qubits):
        qc.rz(np.pi / 5, i)
    for i in reversed(range(num_qubits - 1)):
        qc.cx(i, i + 1)
    qc.barrier()

    terms = []
    coeffs = []

    # XX interactions
    for i in range(num_qubits - 1):
        pauli = ["I"] * num_qubits
        pauli[i] = "X"
        pauli[i + 1] = "X"
        terms.append("".join(pauli))
        coeffs.append(1.0 / (num_qubits - 1))

    # Z fields
    for i in range(num_qubits):
        pauli = ["I"] * num_qubits
        pauli[i] = "Z"
        terms.append("".join(pauli))
        coeffs.append(0.5 / num_qubits)

    observable = SparsePauliOp(terms, coeffs)

    # Compute the ideal final state
    state = Statevector.from_instruction(qc)

    # Compute expectation value
    ideal_value = np.real(state.expectation_value(observable))
    exp_vals.append(ideal_value)

print(exp_vals)

plt.figure()
plt.plot(qubits, exp_vals, "o", label="Statevector")
plt.xlabel("Number of qubits")
plt.ylabel(r"$\langle O^{\otimes N} \rangle$")
plt.legend()
plt.show()
[np.float64(0.7181764372838925), np.float64(0.7181764372838922), np.float64(0.7181764372838931), np.float64(0.7181764372838906), np.float64(0.7181764372838907), np.float64(0.7181764372838709)]
In effetti, vediamo che abbiamo scelto un'hamiltoniana e uno stato che non cambiano con il numero di qubit. Questo è un uso molto scarso per un'applicazione di ricerca del calcolo quantistico, ma ottimo per fare benchmark delle tecniche di mitigazione degli errori. Possiamo usare con fiducia questo valore di aspettazione fisso come risultato ideale, anche aumentando il numero di qubit per testare la mitigazione degli errori.
num_qubits = 30

qc = QuantumCircuit(num_qubits)

# Clifford preparation
for i in range(num_qubits):
    #    qc.h(i)
    qc.ry(0.7, i)

# Clifford entanglement
for i in range(num_qubits - 1):
    qc.cx(i, i + 1)

# --- Non-Clifford "probe" ---
# Small-angle rotation (RZ(pi/8) ~= T gate)

for i in range(num_qubits):
    qc.rz(np.pi / 5, i)

# More Clifford mixing
for i in reversed(range(num_qubits - 1)):
    qc.cx(i, i + 1)

qc.barrier()

qc.draw("mpl")

# This cell builds the observable

terms = []
coeffs = []

# XX interactions
for i in range(num_qubits - 1):
    pauli = ["I"] * num_qubits
    pauli[i] = "X"
    pauli[i + 1] = "X"
    terms.append("".join(pauli))
    coeffs.append(1.0 / (num_qubits - 1))

# Z fields
for i in range(num_qubits):
    pauli = ["I"] * num_qubits
    pauli[i] = "Z"
    terms.append("".join(pauli))
    coeffs.append(0.5 / num_qubits)

observable = SparsePauliOp(terms, coeffs)

# service = QiskitRuntimeService()

# backend = service.least_busy(
##    operational=True,
#   simulator=False,
#   min_num_qubits=num_qubits,
# )

pm = generate_preset_pass_manager(
    backend=backend_real,
    optimization_level=1,
)

qc_transpiled = pm.run(qc)

layout = qc_transpiled.layout
obs_transpiled = observable.apply_layout(layout)

# Compute the ideal final state
# This might time out above about 26 qubits. The Hamiltonian has been "normalized".
# The same expectation value calculated on the smaller example above is still valid.
# state = Statevector.from_instruction(qc)

# Compute expectation value
# ideal_value = np.real(state.expectation_value(observable))

print("Ideal (noiseless) expectation value:")
print(ideal_value)
Ideal (noiseless) expectation value:
0.7181764372838709
# This took 5 sec on ibm_fez. Your actual runtime might vary.

options_none = EstimatorOptions(resilience_level=0)

estimator_none = Estimator(
    mode=backend_real,
    options=options_none,
)

job_none = estimator_none.run([(qc_transpiled, obs_transpiled)])

value_none = job_none.result()[0].data.evs
print("No mitigation:", value_none)
No mitigation: 0.5869884271731322
Ora eseguiamo questo circuito più grande con la ZNE.
# This took 17 sec on ibm_fez. Your actual runtime might vary.

options_zne = EstimatorOptions(resilience_level=2)

estimator_zne = Estimator(
    mode=backend_real,
    options=options_zne,
)

job_zne = estimator_zne.run([(qc_transpiled, obs_transpiled)])

value_zne = job_zne.result()[0].data.evs
print("ZNE:", value_zne)
ZNE: 0.7096089981595511
Infine, eseguiamo con la PEC l'esempio a 30 qubit.
# This took 4 min 57 sec on ibm_fez. Your actual runtime might vary.

options = EstimatorOptions()

# One does not use ZNE with PEC
options.resilience.zne_mitigation = False
options.resilience.pec_mitigation = True
options.resilience.pec.max_overhead = 100

estimator_pec = Estimator(
    mode=backend_real,
    options=options,
)

job_pec = estimator_pec.run([(qc_transpiled, obs_transpiled)])

value_pec = job_pec.result()[0].data.evs
print("PEC:", value_pec)
PEC: 0.3481257778627795
job_id_none = job_none.job_id()
job_id_zne = job_zne.job_id()
job_id_pec = job_pec.job_id()
print("job number with no mitigation:  ", job_id_none)
print("job number with ZNE  ", job_id_zne)
print("job number with PEC  ", job_id_pec)
job number with no mitigation:   d7uc79back5s73be1cv0
job number with ZNE   d7uc7c3ack5s73be1d40
job number with PEC   d7uc9k4inasc738smhu0
import matplotlib.pyplot as plt

methods = ["No mitigation", "ZNE", "PEC"]
values = [value_none, value_zne, value_pec]

ideal = ideal_value  # from Aer statevector

plt.figure(figsize=(6, 4))

plt.plot(methods, values, "o", label="Measured", markersize=8)
plt.axhline(ideal, color="black", linestyle="--", label="Ideal (Aer)")

plt.ylabel("Expectation value")
plt.title("Error mitigation comparison")
plt.legend()
plt.grid(axis="y", alpha=0.3)

plt.tight_layout()
plt.show()
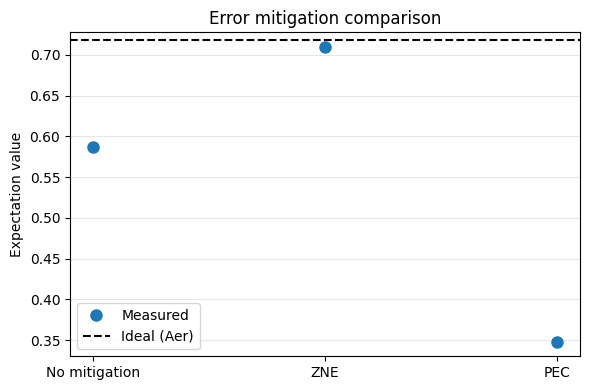
Non solo la PEC ha impiegato molto più tempo delle altre opzioni, ma abbiamo chiaramente raggiunto la nostra soglia massima di overhead. I risultati della PEC hanno pagato il prezzo dell'overhead, ma il limite all'overhead ha impedito una cancellazione sufficientemente accurata del modello di rumore appreso. Questo è fondamentale. Con sei qubit siamo riusciti a sfruttare la PEC e ottenere risultati migliori con un aumento solo modesto dell'overhead quantistico (circa un fattore 5). Con 30 qubit abbiamo pagato un prezzo molto più alto (circa 60 volte maggiore) e i risultati sono stati persino peggiori della stima non mitigata. Questo non significa che la PEC non possa mai funzionare con 30 qubit; potrebbe dipendere dal circuito. Il messaggio è semplicemente che la crescita esponenziale dell'overhead quantistico rende difficile l'esecuzione per circuiti grandi.
Punti chiave:
-
La mitigazione delle misure spesso aiuta e di solito comporta un overhead basso: rimuove un bias che non scala con la profondità del circuito e si combina in modo pulito con quasi tutto.
-
Alcune tecniche non possono essere combinate. Anche quando possono esserlo, assicurati di combinarle in modo coerente, così che una non annulli l'altra. Un buon esempio è assicurarsi che il twirling sia attivo durante la calibrazione per M3, se questi metodi devono essere combinati.
-
PEC e ZNE vanno considerate alternative l'una all'altra. Risolvono lo stesso problema con compromessi opposti:
-
PEC: produce valori di aspettazione non distorti al costo di una varianza esponenziale.
-
La ZNE di solito produce un bias residuo che dipende dal modello di estrapolazione, ma a un costo moderato.
-
-
Il DD può aiutare con lunghi periodi di inattività, ma rimodella il modello di rumore e può invalidare le ipotesi di estrapolazione o inversione.
-
Il Pauli twirling non riduce il rumore. Lo rimodella e spesso permette ad altre tecniche di funzionare meglio (ZNE e PEC).