Soppressione e modellazione degli errori
La soppressione degli errori può riferirsi a qualsiasi tecnica che anticipa e cerca di evitare determinati tipi di rumore ed errori. Questo è più facile da spiegare attraverso esempi concreti, ma tieni presente che questi metodi non si limitano agli esempi mostrati qui, e nuovi metodi vengono continuamente esplorati. A volte non è possibile sopprimere gli errori, ma è possibile influenzare il modo in cui si accumulano. Se possiamo far accumulare gli errori più lentamente, potremmo descrivere questo come una soppressione dell'errore complessivo, ma è più accurato considerarlo come una modellazione del rumore. In questa lezione trattiamo esempi canonici di soppressione degli errori (decoupling dinamico) e di modellazione/formatura del rumore (Pauli twirling).
Un video a corredo di questa lezione sarà pubblicato nei prossimi giorni e sarà incorporato qui.
Decoupling dinamico
Iniziamo con uno stato molto semplice su un singolo qubit e introduciamo un semplice modello di rumore. Questo non è sufficiente per spiegare completamente il decoupling dinamico, ma ci fornisce un esempio chiaro. Supponiamo di avere un qubit preparato in uno stato di sovrapposizione usando una gate di Hadamard:
Questo stato è visualizzato sulla sfera di Bloch come mostrato di seguito a sinistra. Nel caso ideale con rumore zero, questo qubit rimarrebbe in questo stato fino alla successiva operazione. Tuttavia, sappiamo dalla lezione precedente che non è ciò che osserviamo. Il rumore fa degradare l'informazione quantistica.
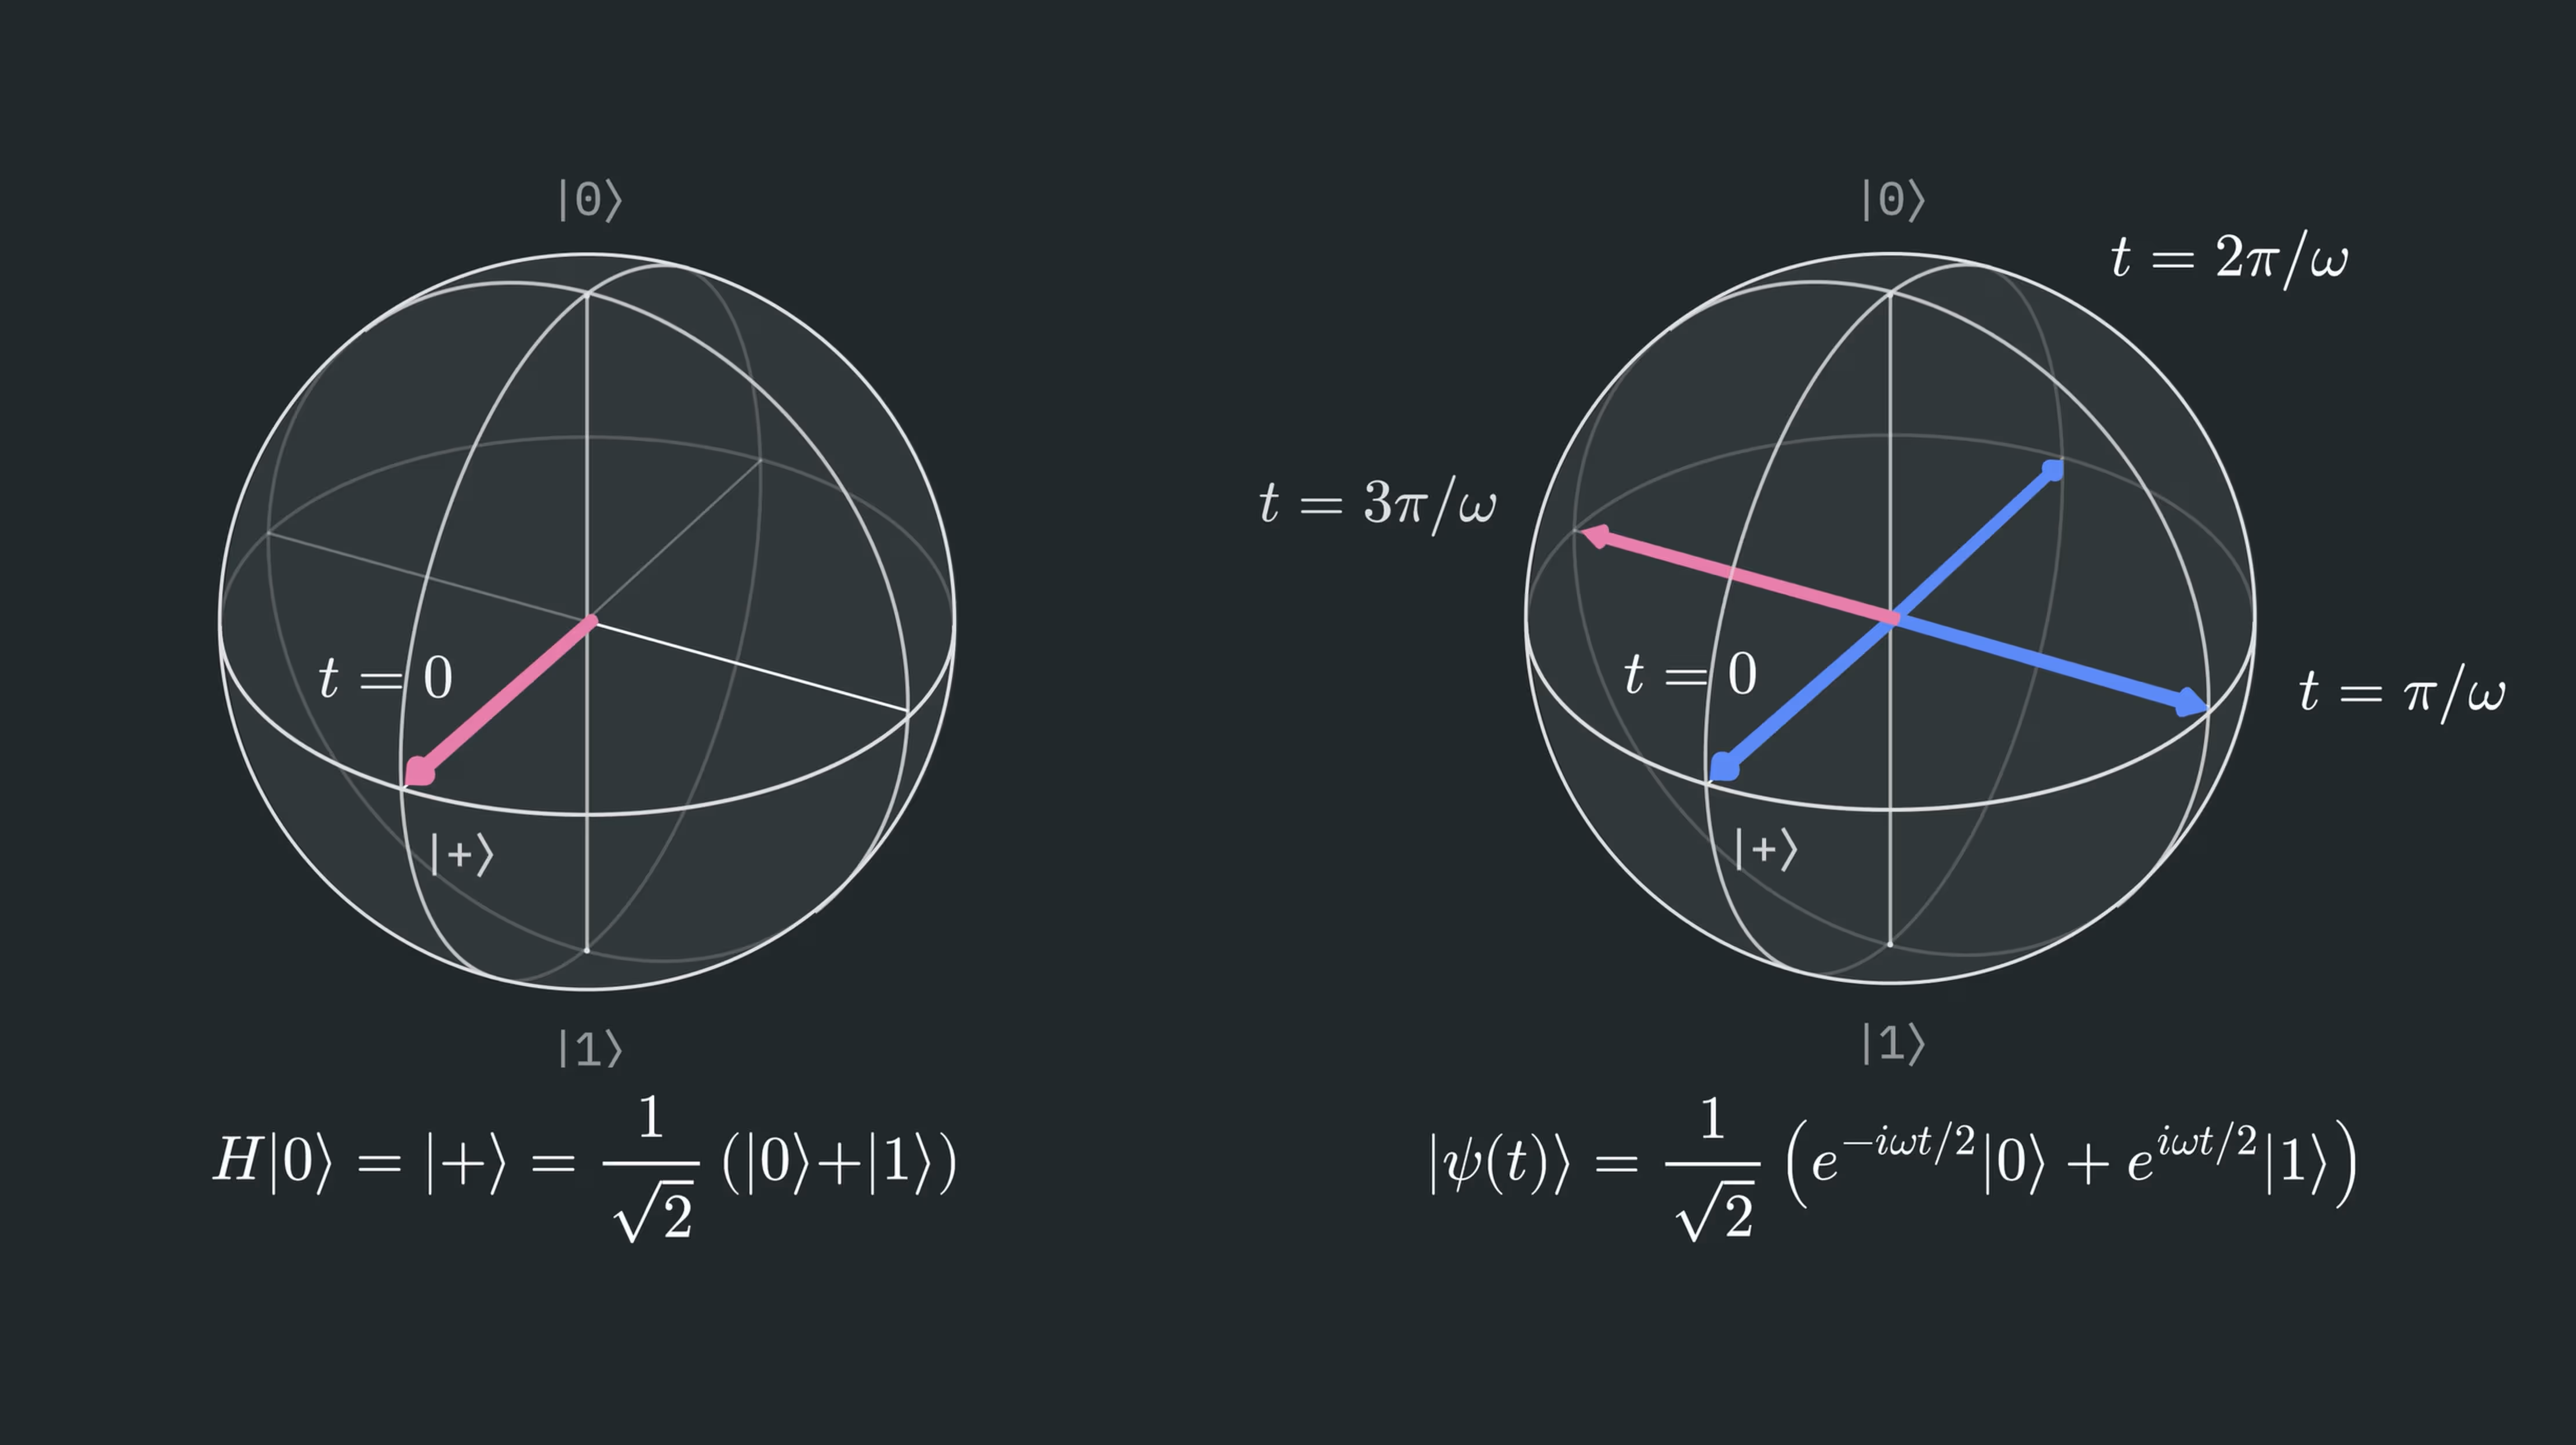
Il rumore o l'accoppiamento ambientale possono far cambiare la fase relativa tra gli stati di base. Cioè, le probabilità di e non cambiano, poiché i valori assoluti dei loro coefficienti non cambiano. Piuttosto, le fasi delle ampiezze cambiano, alterando le loro componenti reali e immaginarie. Per rendere questa discussione più concreta, consideriamo un tipo di interazione che può causare questo: l'accoppiamento a un campo magnetico orientato nella direzione Z: .
Consideriamo cosa succede allo stato con il passare del tempo:
Qui abbiamo usato il fatto che un campo magnetico nella direzione Z causa una precessione attorno all'asse Z con una frequenza che dipende dal momento magnetico effettivo e dall'intensità del campo magnetico. I dettagli sono meno importanti del fatto che questa interazione causa un'evoluzione attorno all'asse Z, risultando in un accumulo di fase opposto per i due stati di base computazionali. Applicando questo operatore a ciascun termine in , troviamo quanto segue:
Questa fase dipendente dal tempo corrisponde alla precessione attorno all'asse Z nella rappresentazione della sfera di Bloch. Questo è mostrato nella metà destra della figura sopra.
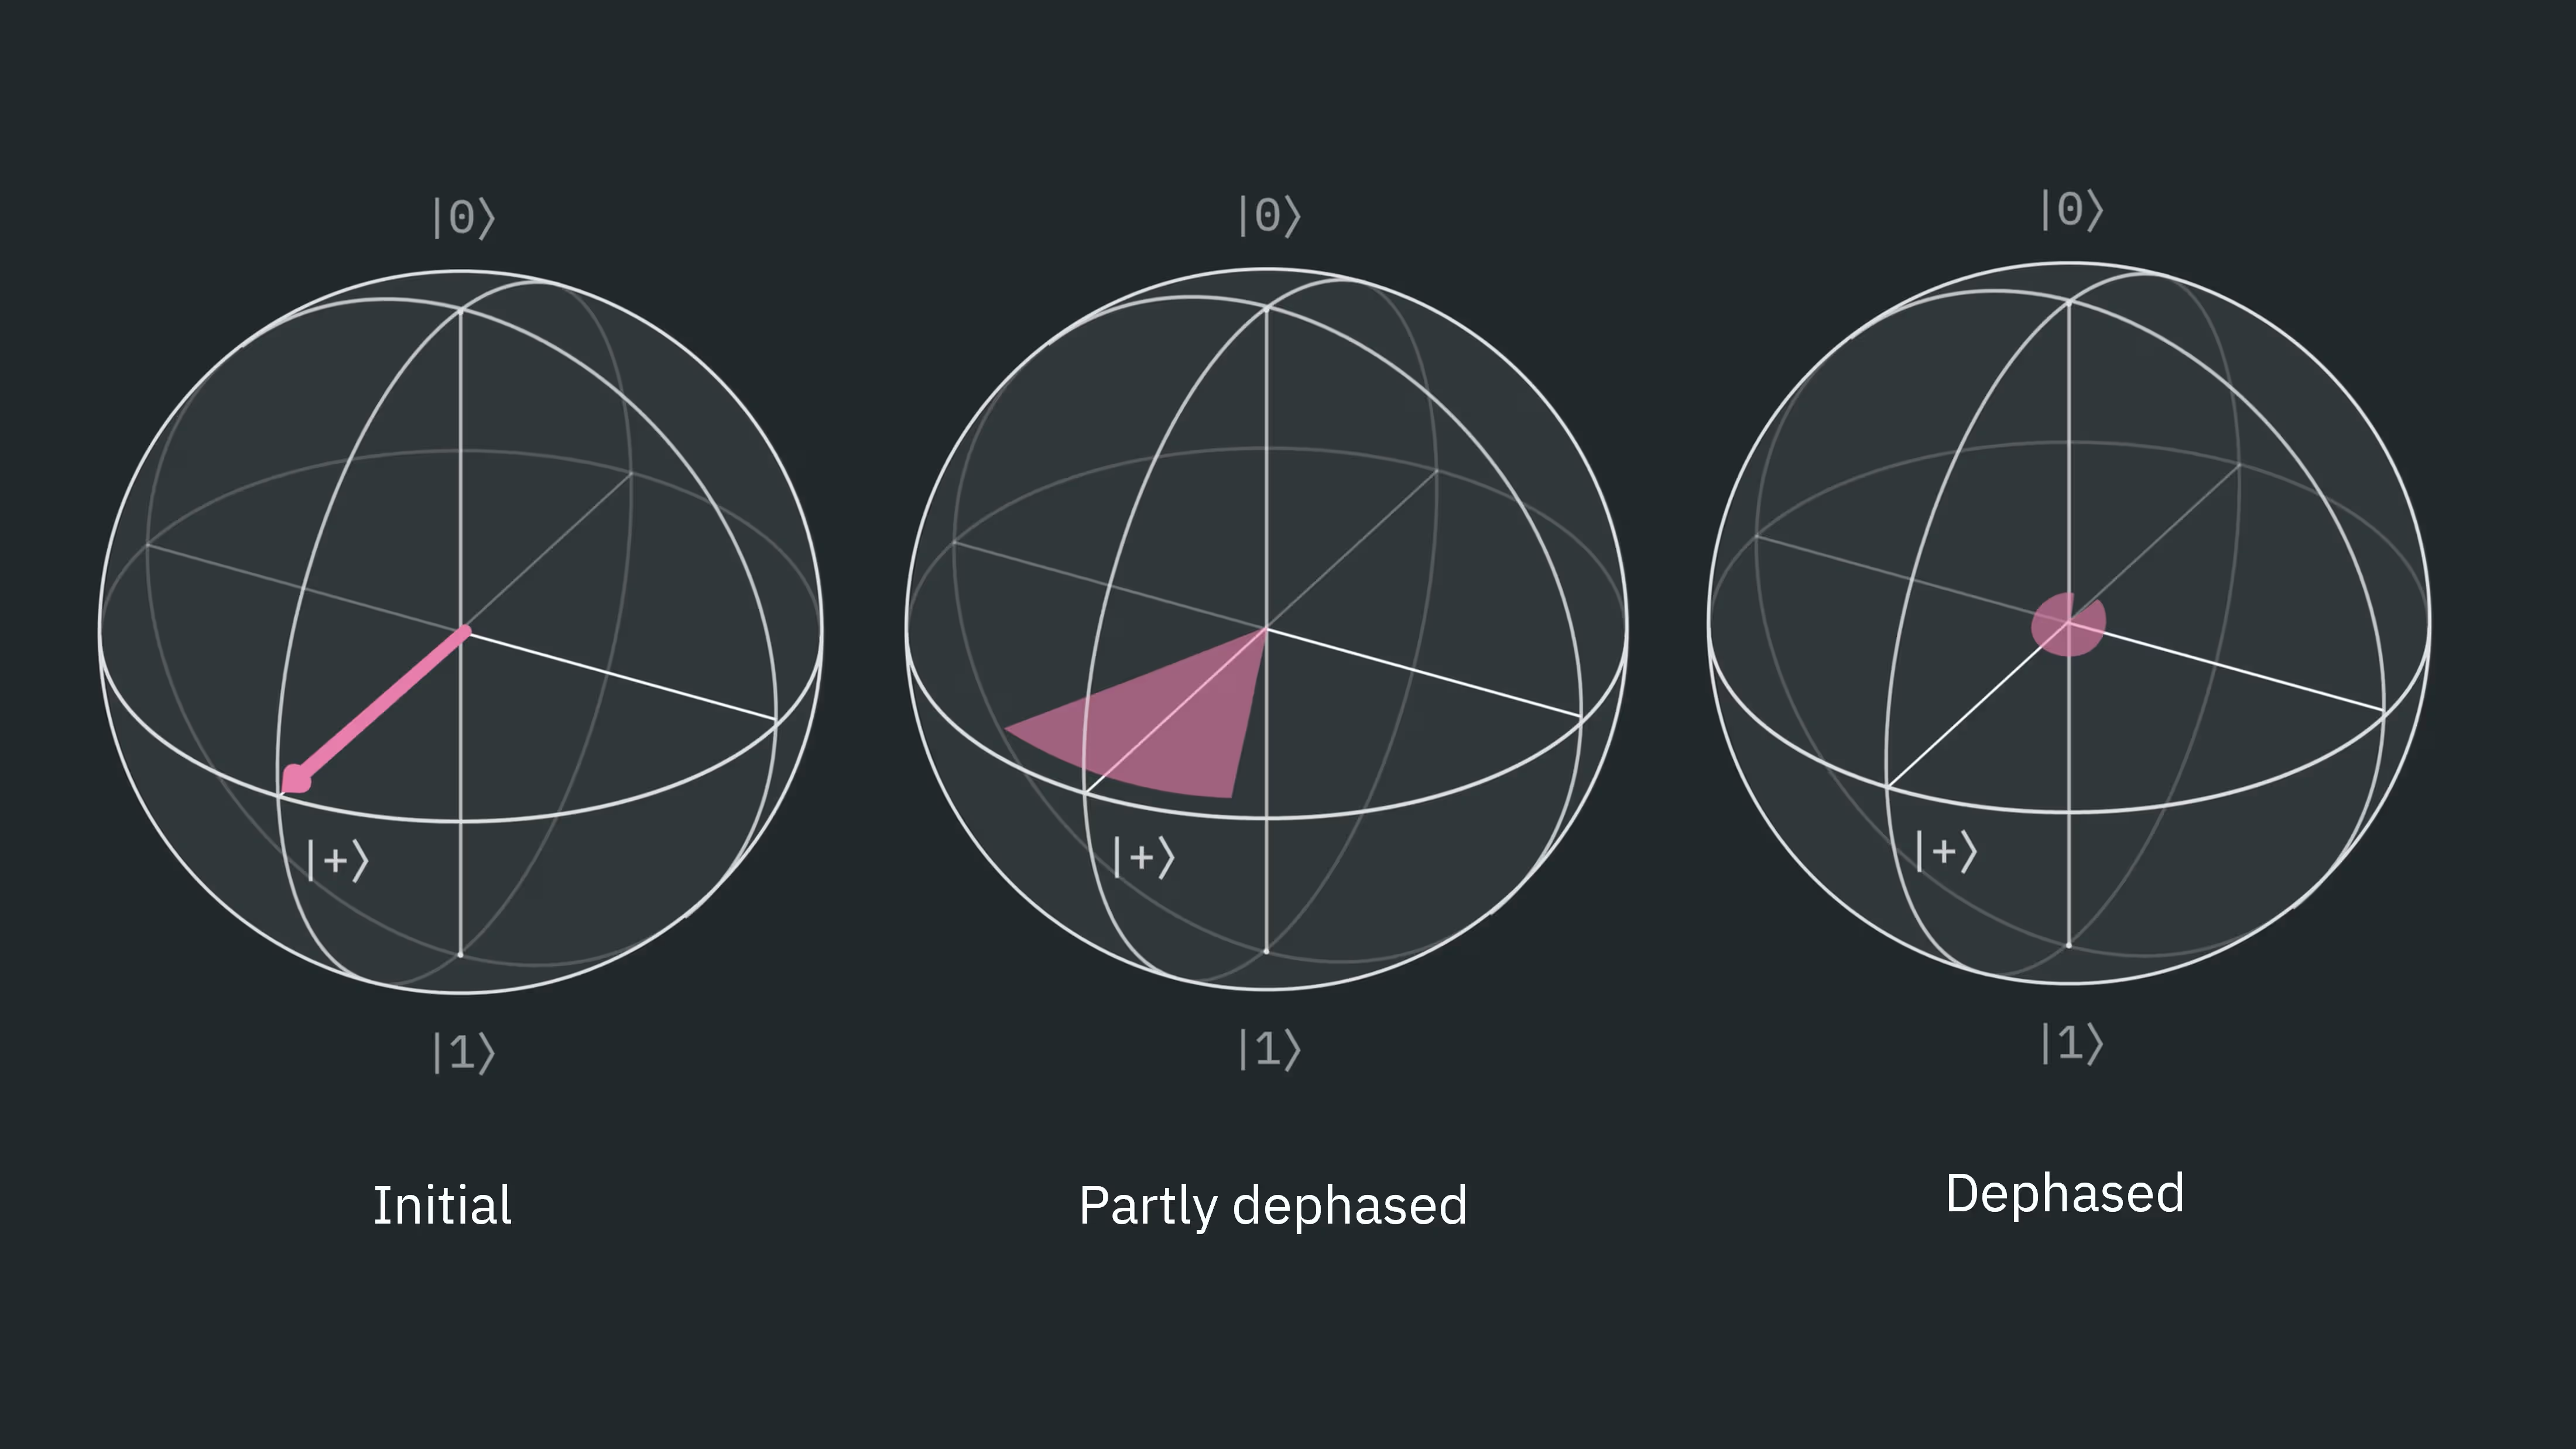
Se sapessimo che questa interazione sta avvenendo in modo controllato, potremmo prevederla. Per modellare questo tipo di rumore, consideriamo invece una distribuzione di possibili intensità di campo magnetico, ciascuna con una certa probabilità classica (altre fonti di rumore dovrebbero essere modellate diversamente). Dobbiamo considerare cosa succede quando c'è una probabilità classica non nulla che lo stato non sia ruotato affatto, e anche una certa probabilità che sia ruotato di una piccola quantità, o anche di una grande quantità. Questa distribuzione di possibili rotazioni è la ragione dello spargimento dello stato nella rappresentazione della sfera di Bloch qui sotto. Se c'è più rumore di defasamento di questo tipo, la fase sarà meno ben definita. Nel limite di forte defasamento, il qubit diventa completamente defasato, corrispondendo alla perdita della coerenza quantistica immagazzinata nello stato.
Naturalmente, in un esperimento non abbiamo idea di quale accoppiamento casuale si verificherà. Cosa possiamo fare al riguardo?
Supponiamo che l'accoppiamento ambientale rimanga approssimativamente costante per un intervallo di tempo . Consideriamo cosa accadrebbe se seguissimo questa prescrizione:
-
Lasciare che la fase cambi per un tempo
-
Applicare una gate X al qubit
-
Lasciare che lo stesso accoppiamento ambientale si verifichi per un ulteriore tempo
-
Applicare una seconda gate X
Dopo l'evoluzione temporale iniziale, avremmo esattamente lo stato sopra. Applicando la prima gate X abbiamo:
Ora, quando passa il secondo intervallo di , si verifica la stessa interazione. Ma ora le ampiezze sono associate agli autostati Z opposti, il che significa che il segno della rotazione attorno all'asse Z si è invertito. Dopo aver lasciato evolvere il sistema per un altro abbiamo lo stato:
E inserendo abbiamo:
Applicare la gate X finale non fa nulla in questo caso, ma è generalmente necessario:
Abbiamo recuperato lo stato quantistico originale, inclusa la sua fase relativa. Questo processo è un esempio particolarmente semplice di decoupling dinamico.
Più in generale, il decoupling dinamico (DD) implica l'inserimento di alcune gate a singolo qubit per ridurre l'effetto delle interazioni con sistemi esterni al qubit (disaccoppiandolo dall'ambiente). La rifocalizzazione completa di tutte le possibili storie di fase allo stato originale, come mostrato sopra, è in qualche modo idealizzata, ma rimane uno scenario possibile. Discutiamo quando il DD è utile e quali avvertenze esistono.
Verifica la tua comprensione
Nel testo sopra, abbiamo esaminato passo passo l'effetto di una sequenza DD XX sullo stato iniziale . Verifica se gli stessi passaggi sopra riportano anche lo stato al suo stato iniziale nelle stesse ipotesi di un campo magnetico a variazione lenta lungo la direzione z.
Risposta
Dopo l'evoluzione temporale iniziale, avremmo esattamente lo stato sopra. Applicando la prima gate X abbiamo:
Ora, quando passa il secondo intervallo di , si verifica la stessa interazione. Ma ora le ampiezze sono associate agli autostati Z opposti, il che significa che il segno della rotazione attorno all'asse Z si è invertito. Dopo aver lasciato evolvere il sistema per un altro abbiamo lo stato:
E inserendo abbiamo
Applicando la gate X finale, abbiamo:
Quando usare il DD
La prima e più ovvia avvertenza è che nella nostra trattazione abbiamo assunto un canale puramente di defasamento. Le interazioni del mondo reale tipicamente producono un misto di defasamento e altri meccanismi di errore. Nella trattazione sopra, abbiamo scelto di applicare specificamente gate X. Questa viene indicata come sequenza XX nel decoupling dinamico. Questa particolare sequenza è appropriata per errori puramente di defasamento. Ma ci sono altre sequenze che potrebbero essere più ampiamente applicabili, come XY4 (mostrata nel diagramma del circuito sotto) e la più complessa XY8.

Un'altra avvertenza è che il decoupling dinamico aggiunge gate a singolo qubit, che possono aggiungere errori a singolo qubit dovuti a imperfezioni della gate o persino a crosstalk. Questi tassi di errore a singolo qubit sono tipicamente molto più bassi degli errori delle gate multi-qubit, quindi questo di solito non è una grande preoccupazione, ma è qualcosa da tenere presente se molti qubit utilizzano il DD molte volte nel corso del tuo circuito.
Il DD è utile quando l'accoppiamento esterno ha il tempo di influenzare lo stato del qubit. Poiché i qubit sono meticolosamente ben isolati e gli accoppiamenti esterni dovrebbero essere deboli, questo tipo di rumore è più evidente quando un qubit rimane inattivo per lunghi periodi. Per tempi di inattività brevi, l'effetto del DD potrebbe essere quello di aggiungere errori di gate a singolo qubit sopprimendo pochissimo rumore; la fedeltà del tuo circuito potrebbe effettivamente ridursi.
Punto chiave: Usa il decoupling dinamico quando i qubit rimangono inattivi per periodi sufficientemente lunghi, e presta attenzione al tipo di sequenza DD utilizzata.
Decoupling dinamico con Qiskit
Esploriamo l'uso del DD esaminando il caso di diversi qubit preparati nello stato , che poi rimangono inattivi per un lungo tempo. In assenza di errori, preparare lo stato multi-qubit e poi applicare una gate di Hadamard prima della misurazione (misurando quindi nella base X) dovrebbe sempre dare 0. Con il rumore, il risultato della misurazione sarà 0 solo una frazione delle volte anziché con probabilità del 100%. Calcoliamo il valore di aspettazione medio di X su più qubit. Cioè, siamo interessati a quanto segue:
dove con l'operatore X nella -esima posizione da destra e è lo stato dell'intero sistema.
Questo circuito contiene ritardi intenzionali, il che è in qualche modo artificioso per un benchmark. Tuttavia, è molto comune che i circuiti reali contengano qubit che rimangono inattivi durante parte dell'esecuzione. Puoi pensare a questo come un modello semplificato di un circuito più complesso in cui alcuni qubit rimangono inattivi per parte del calcolo. Questo tipo di benchmarking basato sull'evoluzione degli stati è spesso indicato come Ramsey benchmarking.
Iniziamo caricando i pacchetti necessari e configurando il servizio.
# Added by doQumentation — required packages for this notebook
!pip install -q matplotlib numpy qiskit qiskit-aer qiskit-ibm-runtime
# Load key packages

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit
import numpy as np

# --------- Configuration ----------

service = QiskitRuntimeService()  # assumes credentials are saved
backend = service.backend("ibm_fez")  # adjust if needed
Ora definiamo alcune funzioni helper. Prima di tutto, vogliamo affrontare il punto riguardante i lunghi tempi di inattività. Cosa significa esattamente "lungo" in questo contesto? Potremmo semplicemente riportare il tempo di inattività in microsecondi. Tuttavia, è utile sapere quante gate a due qubit potrebbero essere eseguite durante lo stesso intervallo. Questo rende i tempi di inattività più direttamente indicativi della profondità del circuito che avrebbe potuto essere eseguita durante lo stesso periodo. La prima funzione helper ottiene la gate a due qubit nativa del backend e determina la durata di quella gate.
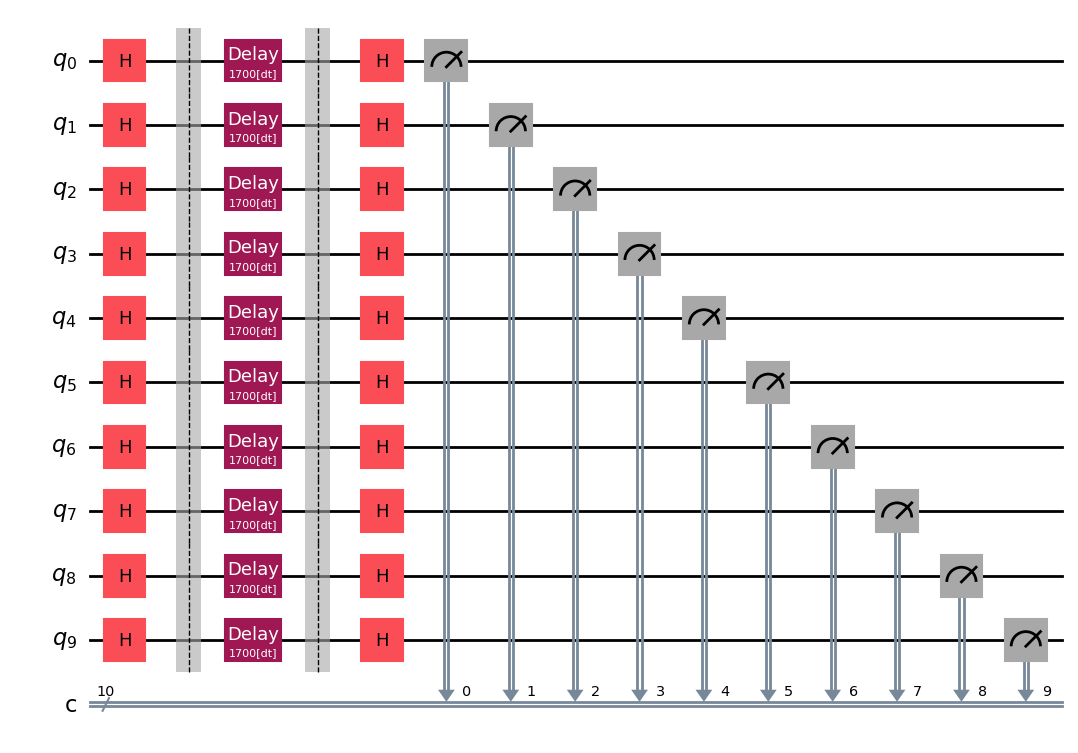
La seconda funzione crea semplicemente un circuito di Ramsey (uno con qubit nello stato ), implementa un ritardo, ruota usando una gate H, e poi misura. Ricorda che una gate di Hadamard (H) mappa in , quindi misurare nella base Z dopo la gate di Hadamard corrisponde al qubit che era in immediatamente prima della gate di Hadamard.
La nostra funzione finale converte i conteggi grezzi dei risultati di misurazione 0 e 1 in un valore di aspettazione di X.
from typing import Tuple
from qiskit.providers import Backend
from numpy.typing import NDArray

# --------- Utilities ----------
def detect_twoq_gate_and_duration(
    backend: Backend, pair: tuple[int, int] = (0, 1)
) -> Tuple[str, float]:
    props = backend.properties()
    candidates = ["cx", "ecr", "cz"]
    for name in candidates:
        try:
            dur = props.gate_length(name, list(pair))
            if dur is not None:
                return name, dur
        except Exception:
            pass
    raise RuntimeError(
        "Could not find a two-qubit gate duration among cx/ecr/cz on this backend."
    )

def make_multiqubit_ramsey_circuit(n: int, delay_dt_ticks: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q)
    qc.barrier()

    for i in range(n):
        qc.delay(delay_dt_ticks, q[i], unit="dt")
    qc.barrier()

    qc.h(q)
    qc.measure(q, c)
    return qc

def counts_to_x_expectations(counts: dict[str, int], n: int) -> NDArray[np.float64]:
    total = sum(counts.values())
    if total == 0:
        return np.zeros(n)

    p0 = np.zeros(n, dtype=float)
    for bitstring, cnt in counts.items():
        bits_rev = bitstring[::-1]
        for i in range(n):
            if bits_rev[i] == "0":
                p0[i] += cnt
    p0 /= total
    return 2.0 * p0 - 1.0
Ora specifichiamo i dettagli del nostro test, incluso il numero di qubit e la sequenza di gate da usare nel DD (in questo caso XX). Nota in particolare che impostiamo il livello di ottimizzazione a zero. In pratica, spesso sceglieresti un livello di ottimizzazione più alto; qui usiamo il livello 0 per assicurarci che gli effetti degli errori mirati dal DD rimangano visibili. Infine, determiniamo il tempo caratteristico per le gate a due qubit su questo backend e stampiamo alcuni tempi rilevanti.
n_qubits = 10  # number of qubits to test in parallel
shots = 4096
opt_level = 0  # we want to ignore optimization for now
num_steps = 6  # number of delay points
gates_per_step = 20  # "equivalent 2q gates" per step
dd_sequence = "XX"  # "XX" for your request; you might try "XY4" too

# --------- Derive timing: dt and 2q gate time ----------
dt = backend.dt  # seconds per dt
twoq_name, t2q = detect_twoq_gate_and_duration(backend, (0, 1))  # seconds
delay_unit_dt = int(round(t2q / dt))  # dt ticks equivalent to one 2q gate

print(f"Backend: {backend.name}")
print(f"dt = {dt*1e9:.3f} ns per tick")
print(f"Using 2q gate '{twoq_name}' with duration ~ {t2q*1e9:.1f} ns")
print(f"One 2q gate ≈ {delay_unit_dt} dt ticks")
Backend: ibm_fez
dt = 4.000 ns per tick
Using 2q gate 'cz' with duration ~ 68.0 ns
One 2q gate ≈ 17 dt ticks
Ora costruiamo i nostri circuiti e li transpiliamo per il backend scelto.
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

equiv_gates_list = [
    j * gates_per_step for j in range(num_steps)
]  # e.g., 0, 100, 200, ...
delay_dt_list = [int(round(delay_unit_dt * m)) for m in equiv_gates_list]
delay_us_list = [(dt * d) * 1e6 for d in delay_dt_list]  # for printing/plotting

circuits = []
for delay_dt in delay_dt_list:
    qc = make_multiqubit_ramsey_circuit(n_qubits, delay_dt)
    qc_isa = pm.run(qc)  # ISA-level scheduling/placement; DD is handled at runtime
    circuits.append(qc_isa)

print("Delay sweep (approx microseconds):", [f"{t:.2f}" for t in delay_us_list])
Delay sweep (approx microseconds): ['0.00', '1.36', '2.72', '4.08', '5.44', '6.80']
Dovremmo visualizzare almeno un circuito per assicurarci di aver codificato il nostro circuito con gli stati e i ritardi desiderati. Potrebbe essere più facile visualizzare il circuito pre-transpilato qc, oppure potresti controllare quello transpilato qc_isa.
qc.draw("mpl")
Esecuzione
Siamo finalmente pronti a eseguire su hardware. Usiamo Sampler per ottenere molte misurazioni di ciascun qubit, e lo useremo due volte: una volta con il DD esplicitamente disattivato, e una volta con il DD attivato e usando la sequenza di gate XX.
# --------- Run: NO DD ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = False

job = sampler.run(circuits)
res_nodd = job.result()
job_id = job.job_id()  # job id for dd off/false
print("job number for no dd is ", job_id)

# --------- Run: WITH DD (XX) ----------
sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = (
    dd_sequence  # "XX" first; you can try "XY4" too
)
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_dd = job.result()
job_id = job.job_id()  # job id for dd on/XX
print("job number for dd using XX is ", job_id)
Possiamo estrarre i conteggi dai vari circuiti.
# --------- Extract counts per circuit ----------

from typing import Iterable, Any

def extract_counts_list(res: Iterable[Any]) -> list[dict[str, int]]:
    counts_list: list[dict[str, int]] = []

    for r in res:  # each r corresponds to one circuit
        counts: dict[str, int] = r.data.c.get_counts()
        counts_list.append(counts)

    return counts_list

counts_list_nodd = extract_counts_list(res_nodd)
counts_list_dd = extract_counts_list(res_dd)
Post-elaborazione
Ora abbiamo i conteggi dalla misurazione, ma vogliamo trasformarli nel valore di aspettazione di X e poi mediare questi valori di aspettazione su tutti i qubit usati, per apprendere qualcosa sulla preservazione dell'informazione di fase. Per questo usiamo la nostra funzione counts_to_x_expectations definita in precedenza.
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.

xexp_nodd = []
xexp_dd = []
contrast_nodd = []
contrast_dd = []

for counts in counts_list_nodd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_nodd.append(x_vec)
    contrast_nodd.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

for counts in counts_list_dd:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_dd.append(x_vec)
    contrast_dd.append(float(np.mean(np.abs(x_vec))))

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1 in zip(equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD  :", np.round(np.abs(xexp_dd[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.954,  DD(XX)= 0.961
Delay ~   20 * cz  (~   1.36 µs):  NoDD= 0.827,  DD(XX)= 0.927
Delay ~   40 * cz  (~   2.72 µs):  NoDD= 0.793,  DD(XX)= 0.900
Delay ~   60 * cz  (~   4.08 µs):  NoDD= 0.729,  DD(XX)= 0.876
Delay ~   80 * cz  (~   5.44 µs):  NoDD= 0.661,  DD(XX)= 0.854
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.586,  DD(XX)= 0.826

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.05  0.744 0.712 0.867 0.844 0.234 0.473 0.755 0.59  0.587]
DD  : [0.583 0.89  0.921 0.88  0.908 0.832 0.893 0.773 0.807 0.773]
Infine, tracciamo i nostri risultati.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With DD", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
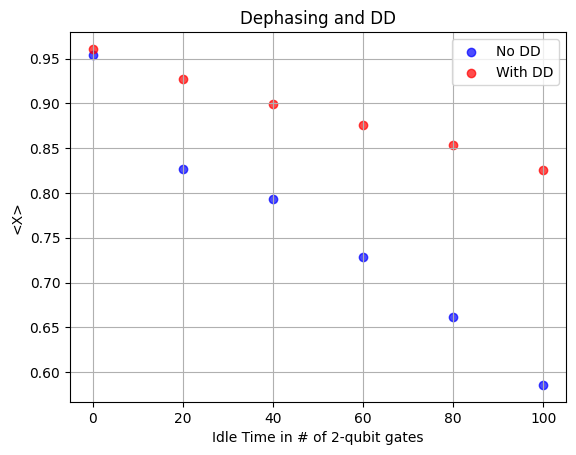
Come puoi vedere, senza ritardo esplicito i valori di aspettazione sono effettivamente vicini a 1, come ci aspetteremmo se tutta l'informazione di fase fosse preservata. Se tutta l'informazione di fase fosse persa, non ci sarebbe alcuna preferenza per la rotazione finale a produrre piuttosto che , e il valore di aspettazione medio si avvicinerebbe a zero. Nei dati, vediamo che all'aumentare dei tempi di ritardo, il valore di aspettazione medio di X diminuisce, iniziando ad avvicinarsi a zero. Nota che il DD è stato molto efficace qui; i valori di aspettazione con DD sono tipicamente più del 20% migliori (più vicini a 1) rispetto ai valori senza DD. Ma nota anche che il primo punto dati ritardato corrisponde a un ritardo approssimativamente equivalente a 100 operazioni di gate a due qubit. Questo rafforza il punto secondo cui il DD è più utile quando i qubit rimangono inattivi per periodi relativamente lunghi.
Verifica la tua comprensione
Se applichiamo il DD usando XY4 allo stesso circuito di prima, ti aspetti che produca risultati molto migliori, molto peggiori, o più o meno uguali, rispetto al DD usando XX? Spiega.
Risposta
Più o meno uguali, forse leggermente peggiori. Il circuito che abbiamo usato aveva stati ruotati nel piano XY. Questo stato immagazzina informazioni principalmente nella sua fase, rendendolo particolarmente sensibile agli errori di defasamento piuttosto che al rilassamento T1. XY4 potrebbe aiutare con una gamma più ampia di errori, ma XX è già ottimizzato per aiutare il circuito che stiamo usando. XY4 potrebbe essere altrettanto valido, ma non aggiungerebbe nulla di sostanziale, oppure il fatto che XY4 contiene più gate potrebbe permettere ulteriori errori di gate che rendono i risultati leggermente peggiori.
L'ultimo risultato ha usato la sequenza di gate DD più semplice, XX. Vediamo come implementare una sequenza più complessa, XY4. Definiamo un Sampler nella sezione successiva.
# --------- Run: WITH DD (XY4) ----------
dd_sequence = "XY4"

sampler = Sampler(mode=backend)
sampler.options.default_shots = shots
sampler.options.dynamical_decoupling.enable = True
sampler.options.dynamical_decoupling.sequence_type = dd_sequence
sampler.options.dynamical_decoupling.scheduling_method = "alap"
sampler.options.dynamical_decoupling.extra_slack_distribution = "middle"

job = sampler.run(circuits)
res_xy4 = job.result()
job_id = job.job_id()  # job id for dd on/XY4
print("job number for dd using Xy4 is ", job_id)
job number for dd using Xy4 is d6k6ti860irc7395d3hg
# --------- Extract counts per circuit ----------

counts_list_xy4 = extract_counts_list(res_xy4)
# --------- Compute X-expectations and a scalar contrast ----------
# For each circuit (each delay), compute per-qubit <X> and average absolute contrast.
xexp_xy4 = []
contrast_xy4 = []

for counts in counts_list_xy4:
    x_vec = counts_to_x_expectations(counts, n_qubits)
    xexp_xy4.append(x_vec)
    contrast_xy4.append(float(np.mean(np.abs(x_vec))))  # average |<X>| across qubits

# --------- Print a small summary ----------
print("\n=== Summary (average |<X>| per delay) ===")
for m, d_us, c0, c1, c2 in zip(
    equiv_gates_list, delay_us_list, contrast_nodd, contrast_dd, contrast_xy4
):
    print(
        f"Delay ~ {m:4d} * {twoq_name}  (~{d_us:7.2f} µs):  NoDD={c0: .3f},  DD({dd_sequence})={c1: .3f}"
    )

# Optionally, inspect per-qubit values for the last delay point
print("\nPer-qubit <X> (abs) at the longest delay:")
print("NoDD:", np.round(np.abs(xexp_nodd[-1]), 3))
print("DD XX :", np.round(np.abs(xexp_dd[-1]), 3))
print("DD XY4 :", np.round(np.abs(xexp_xy4[-1]), 3))
=== Summary (average |<X>| per delay) ===
Delay ~    0 * cz  (~   0.00 µs):  NoDD= 0.968,  DD(XY4)= 0.968
Delay ~  100 * cz  (~   6.80 µs):  NoDD= 0.612,  DD(XY4)= 0.839
Delay ~  200 * cz  (~  13.60 µs):  NoDD= 0.462,  DD(XY4)= 0.705
Delay ~  300 * cz  (~  20.40 µs):  NoDD= 0.339,  DD(XY4)= 0.580
Delay ~  400 * cz  (~  27.20 µs):  NoDD= 0.225,  DD(XY4)= 0.481
Delay ~  500 * cz  (~  34.00 µs):  NoDD= 0.204,  DD(XY4)= 0.393

Per-qubit <X> (abs) at the longest delay:
NoDD: [0.002 0.208 0.447 0.034 0.286 0.306 0.322 0.044 0.163 0.232]
DD XX : [0.433 0.669 0.526 0.516 0.572 0.284 0.303 0.055 0.365 0.208]
DD XY4 : [0.38  0.662 0.521 0.538 0.621 0.252 0.353 0.038 0.239 0.073]
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values with no DD
ax.scatter(
    equiv_gates_list, contrast_nodd, c="blue", linestyle="-", label="No DD", alpha=0.7
)

## Add values with DD using XX sequence
ax.scatter(
    equiv_gates_list, contrast_dd, c="red", linestyle="-", label="With XX", alpha=0.7
)

## Add values with DD using XY4 sequence
ax.scatter(
    equiv_gates_list,
    contrast_xy4,
    c="black",
    linestyle="-",
    label="With XY4",
    alpha=0.7,
)

# Add labels and plot
ax.set_xlabel("Idle Time in # of 2-qubit gates")
ax.set_ylabel("<X>_av")
ax.legend()
ax.set_title("Dephasing and DD")
ax.grid(True)

plt.show()
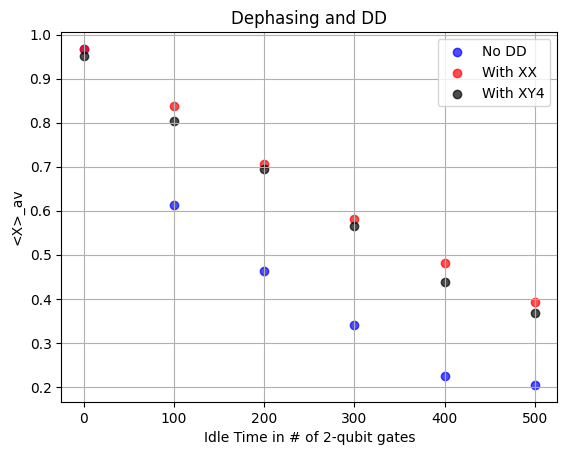
Qui vediamo che XY4 non è apprezzabilmente diverso da XX. Potrebbe essere leggermente peggiore a causa delle gate aggiuntive nella sequenza XY4, ma soprattutto, abbiamo già spiegato perché XX avrebbe l'effetto desiderato nel preservare la fase specificamente per uno stato come . Non c'è motivo di pensare che, per un tale stato iniziale, una sequenza diversa migliorerebbe i risultati.
Verifica la tua comprensione
Verifica che la sequenza XY4 lasci lo stato invariato a meno di una fase globale.
Risposta
Pauli twirling
Dovremmo iniziare notando che il Pauli twirling è spesso usato non come tecnica di soppressione degli errori, ma come tecnica di modellazione degli errori: fa sì che il rumore/gli errori si comportino diversamente, a volte in modo più prevedibile, per consentire altri metodi. Sebbene il Pauli twirling non prevenga gli errori, potrebbe prevenirne l'accumulo coerente.
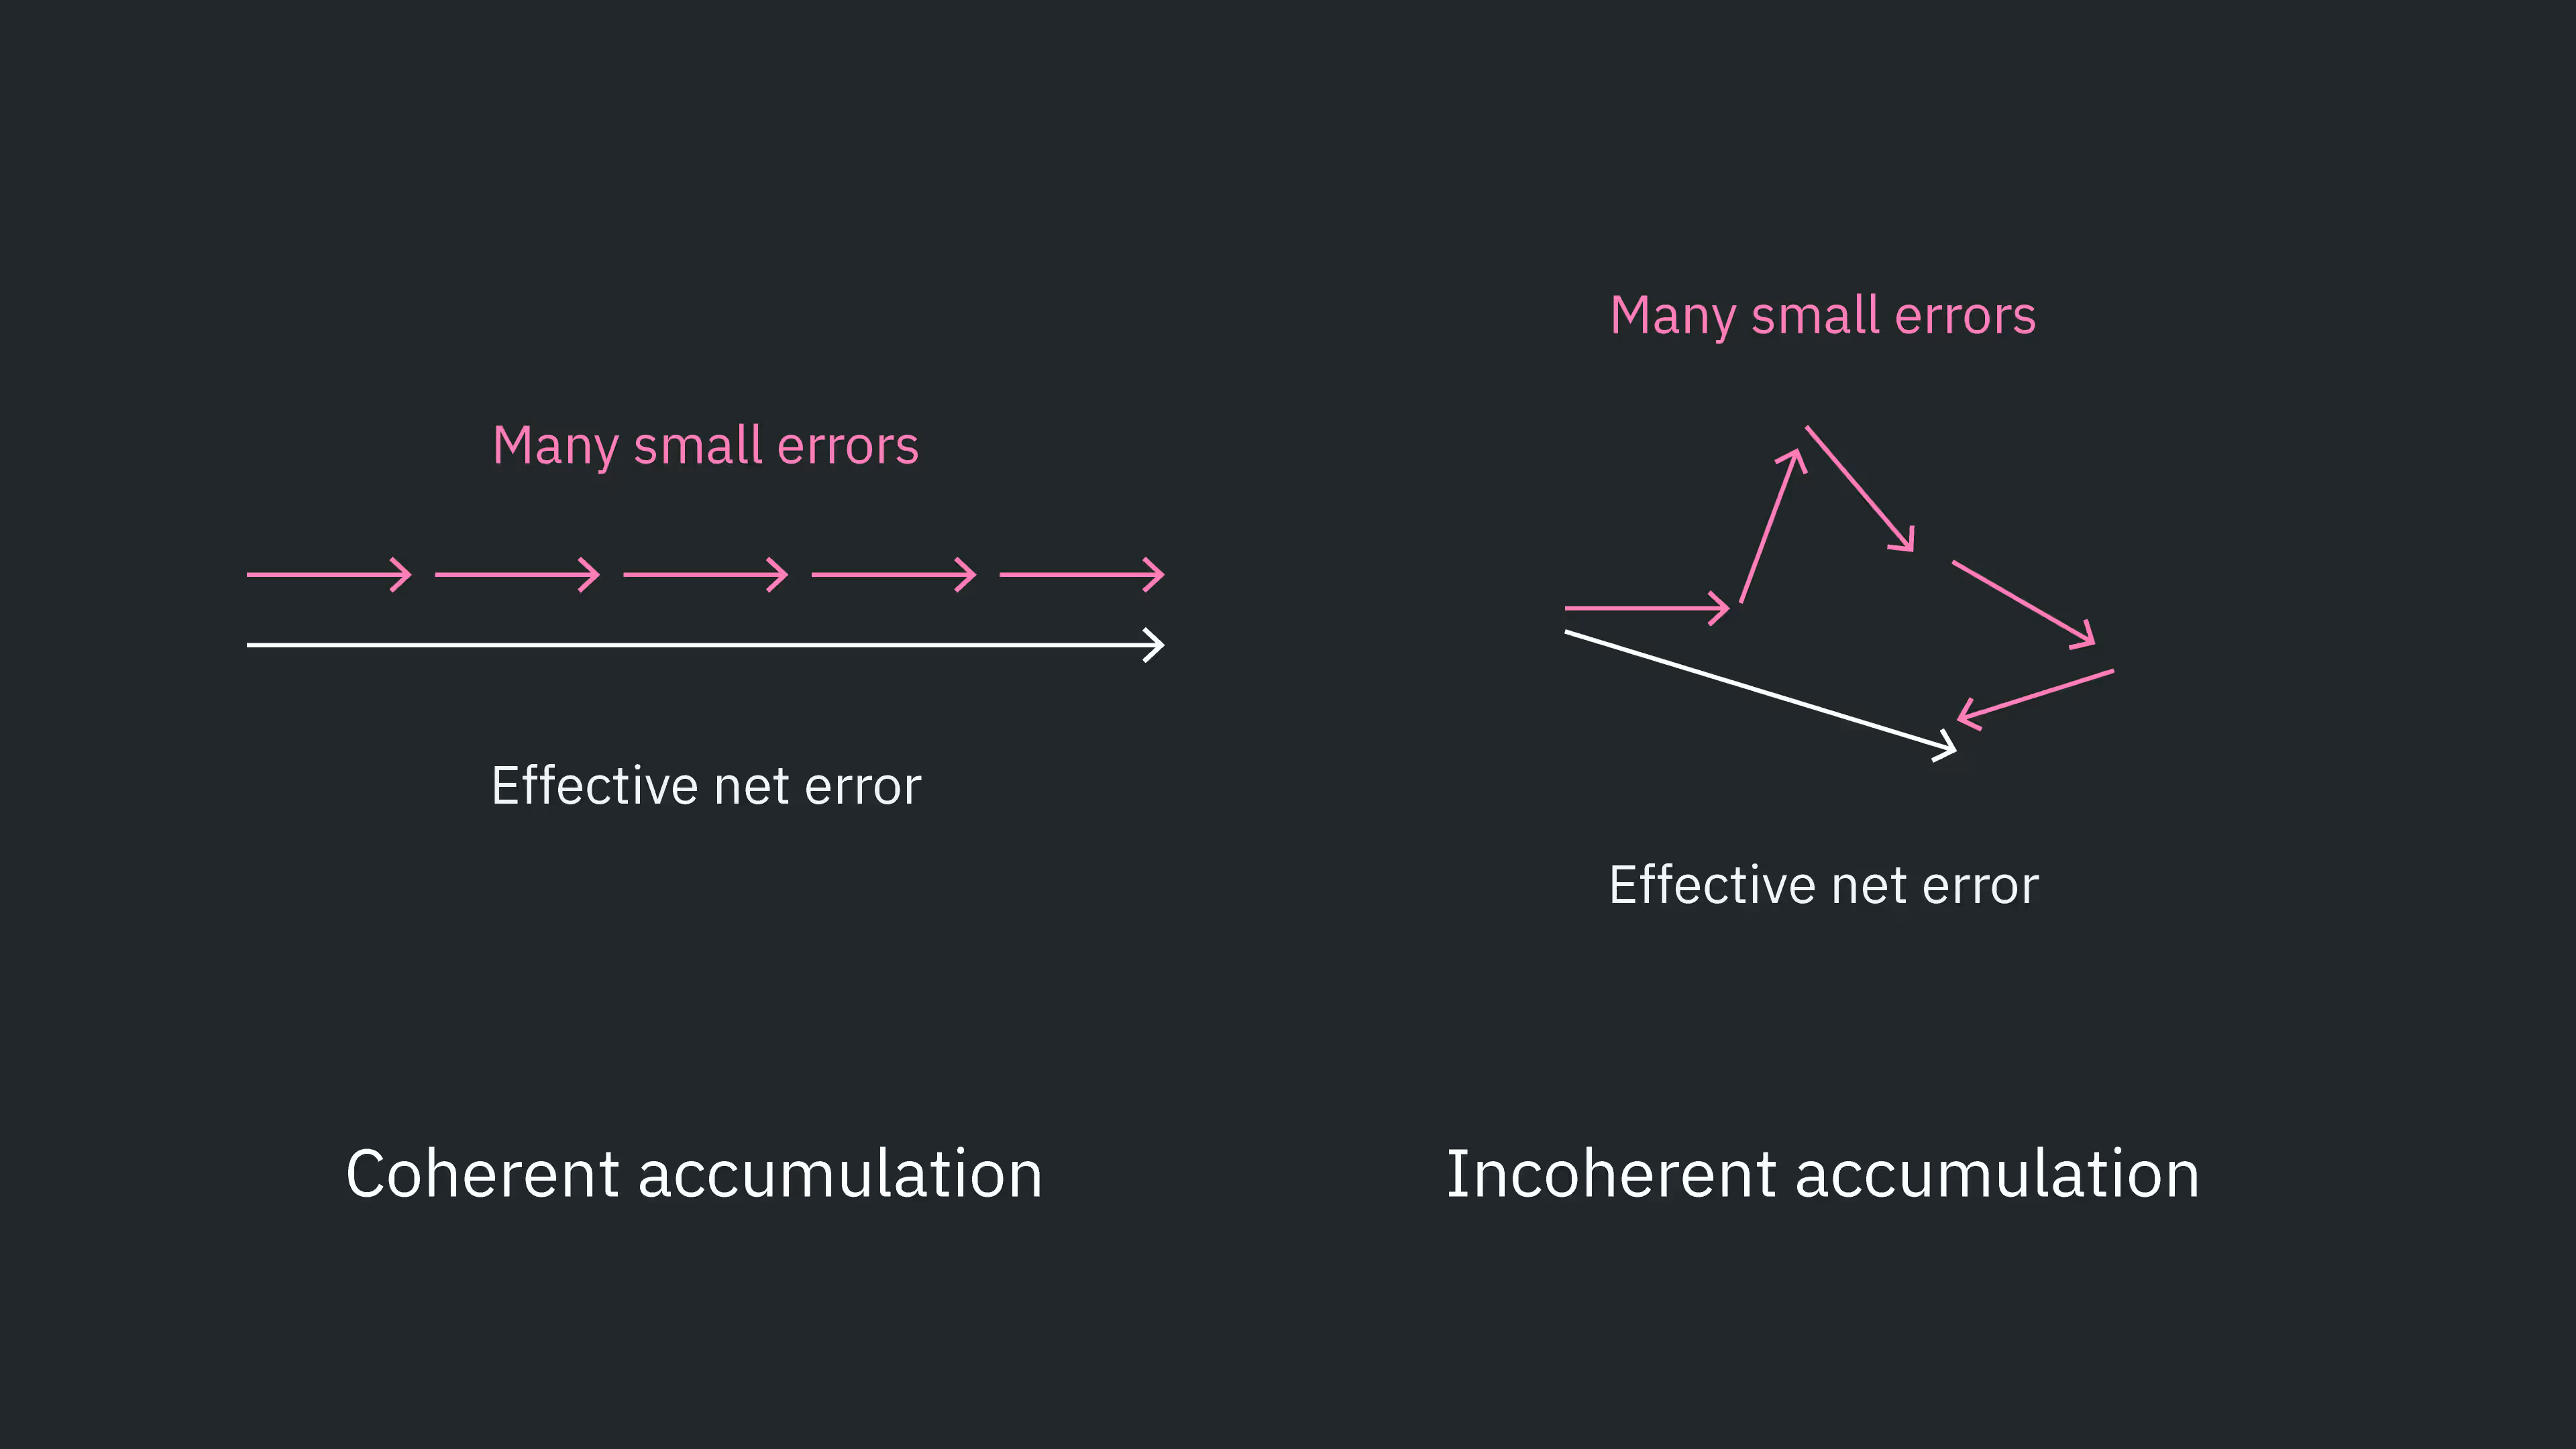
In un circuito quantistico, più fonti diverse di errore si sommano. Gli errori possono sommarsi in modi diversi, in particolare coerentemente e incoerentemente. L'accumulo coerente di errori significa che il rumore o le implementazioni imperfette tendono tutte a guidare gli errori nella stessa direzione attraverso più livelli e gate. Un esempio sarebbe la sovrarotazione coerente quando si applica una gate di rotazione.
Consideriamo una gate di rotazione ideale, come , che ruota attorno all'asse X esattamente di . Naturalmente, l'implementazione della gate non è perfetta, e la rotazione effettiva potrebbe essere per un'implementazione, e potrebbe persino verificarsi che abbia sempre lo stesso segno, e possibilmente magnitudine simile su molte applicazioni di . Pertanto, l'applicazione ripetuta di gate di rotazione può risultare in un accumulo coerente di queste molte sovrarotazioni (o sottorotazioni), .
L'accumulo incoerente di errori è esattamente l'opposto: errori in direzioni casuali con segni casuali, tali che gli errori in livelli diversi non interferiscano sempre in modo additivo, ma a volte si annullano o si sommano in quadratura. Chiaramente gli errori incoerenti si accumulano più lentamente in termini di effetto complessivo sullo stato del qubit. Un diagramma semplificato di questo è mostrato nella figura sotto. Questa è una semplificazione. Gli errori quantistici reali non sono limitati a uno spazio cartesiano bidimensionale; non tutti i contributi di errore avranno la stessa magnitudine, e ci sono più complessità. Ma l'intuizione di un'immagine come questa è utile: gli errori coerenti tendono ad accumularsi più velocemente di quelli incoerenti.
Spesso si possono ottenere risultati a fedeltà più alta trasformando l'accumulo coerente di errori in accumulo incoerente di errori. Un modo principale per ottenere questo è chiamato Pauli twirling.
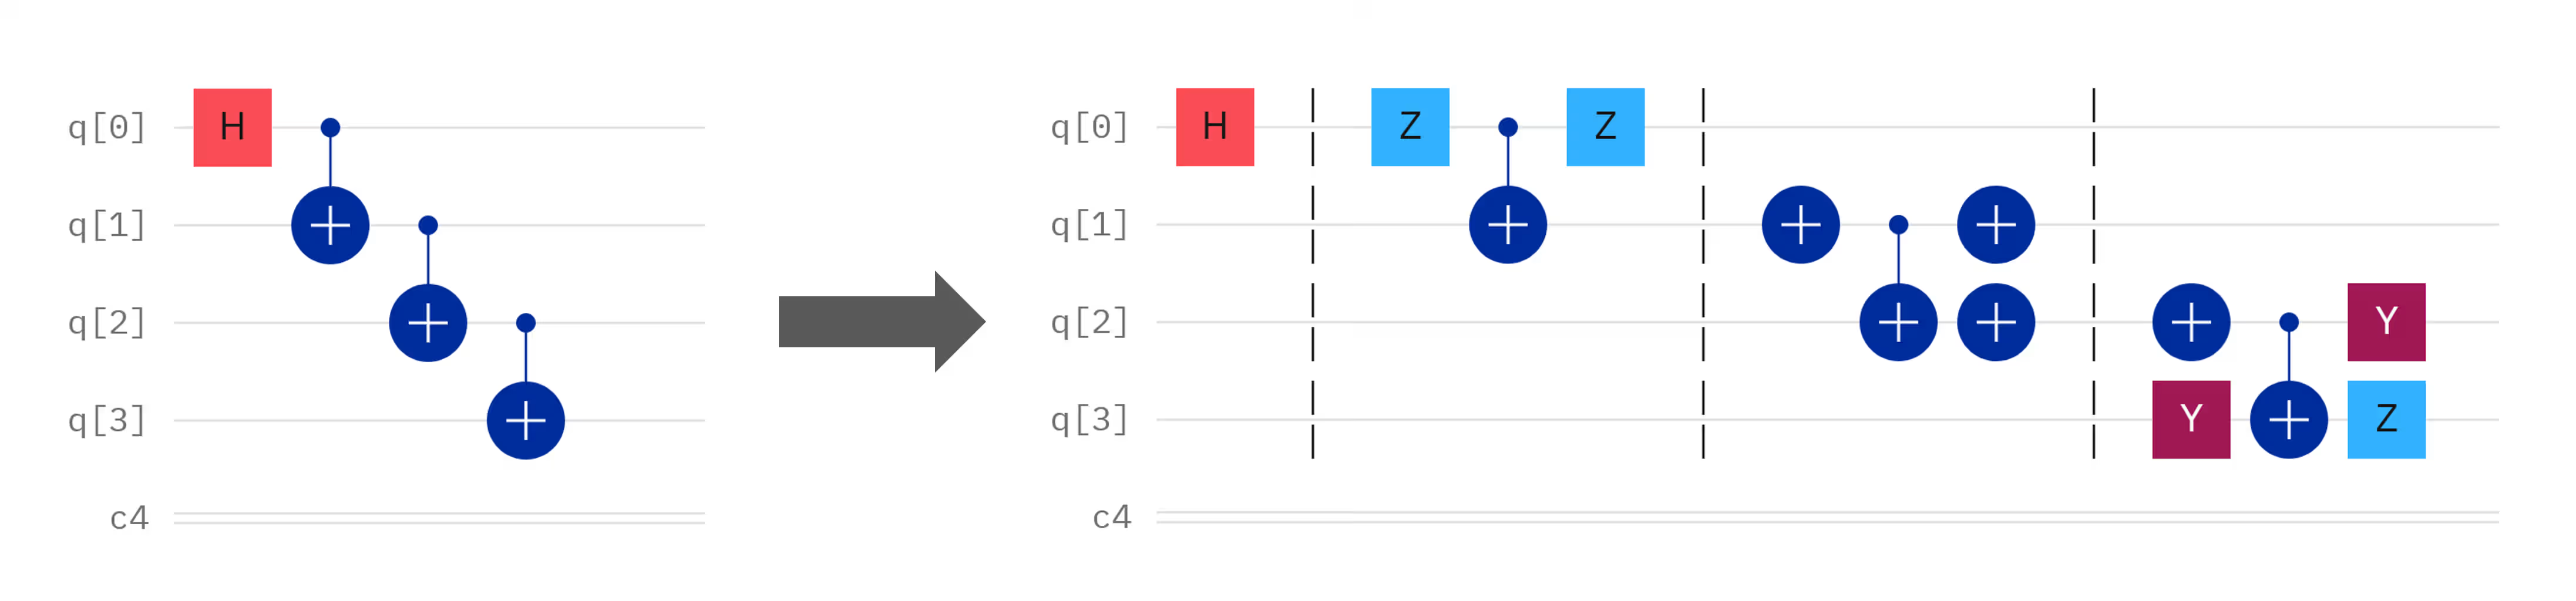
Il Pauli twirling si riferisce all'aggiunta di combinazioni di gate di Pauli prima e dopo un'operazione di gate desiderata in modo tale che . Qui, e non sono singole Pauli, ma collezioni di operatori di Pauli che spesso agiscono su più qubit. A volte potresti vedere affermato che l'azione delle gate di Pauli aggiuntive è "equivalente all'identità". Ma questo è impreciso e potenzialmente confuso. Le gate di Pauli sono separate da e l'obiettivo è lasciare l'azione logica di tutte le gate uguale a . A volte viene chiamato il "payload" per distinguere questa operazione prevista dalle gate aggiunte per la soppressione. Alcuni esempi di Pauli twirling attorno a una gate CNOT sono mostrati sotto.

Esaminiamo un solo esempio per verificare che il twirling lasci invariato l'effetto logico del payload. Senza perdita di generalità, siano gli stati a due qubit che coinvolgono e :
Come sempre, usiamo la convenzione di ordinamento dei qubit . Applicando una gate CX con come target si ottiene
Ora consideriamo il terzo circuito mostrato, usando gate X per il Pauli twirling. Potremmo semplicemente moltiplicare le matrici insieme e verificare che producano una matrice CNOT. In alternativa, possiamo tracciare l'operazione su uno stato quantistico arbitrario attraverso il circuito, come facciamo sotto. Gli stati in diversi punti del circuito sono stati etichettati a-d.

Questo è esattamente che abbiamo ottenuto prima senza twirling. Infatti, questa sequenza di gate twirled lascia invariata l'azione logica del payload. Tuttavia, se sequenze di twirling valide diverse vengono selezionate casualmente da un livello all'altro, l'accumulo coerente di errori può essere convertito in un accumulo di errori effettivamente stocastico (incoerente). Per essere chiari, non si sceglie un singolo schema di twirling e lo si usa in tutto il circuito. Invece, sequenze di twirling valide diverse vengono selezionate per livelli diversi. Un esempio con molti livelli di entanglement potrebbe apparire così.
Verifica la tua comprensione
Verifica che il Pauli twirling nel quarto pannello della figura sopra lasci anch'esso invariato l'effetto logico del CNOT.
Risposta
Seguiamo l'esempio sopra e mostriamo che l'azione su qualsiasi stato arbitrario a due qubit è equivalente a un'operazione CNOT. Faremo riferimento ai punti etichettati in questo diagramma.

Questo è equivalente all'azione di un CNOT con il qubit 0 come controllo e il qubit 1 come target.
Riesci a inventare una sequenza di Pauli twirling per la gate CNOT che non è mostrata sopra?
Risposta
Sì, ce ne sono molte altre. Un esempio è prima del CNOT, e uno e dopo il CNOT.
Quando usare il Pauli twirling
Come presentato qui, il Pauli twirling viene applicato solo a gate multi-qubit. Applicare un protocollo simile a gate a singolo qubit richiederebbe una logica diversa e generalmente non è utile in pratica. Il Pauli twirling stesso usa diverse gate a singolo qubit (le gate di Pauli). Le gate di Pauli aggiuntive introdurrebbero probabilmente più errore di quanto si guadagnerebbe randomizzando qualsiasi accumulo coerente di errori. I tassi di errore associati alle gate a due qubit sono molto più grandi di quelli associati alle gate a singolo qubit. Inoltre, alcune gate a singolo qubit sono non-Clifford, che non possono essere completamente twirlate. Questo è il motivo per cui Qiskit include opzioni di Pauli twirling che twirlano automaticamente attorno alle gate a due qubit, e non attorno alle gate a singolo qubit.
Questo era implicito nella figura sopra: il Pauli twirling è stato implementato attorno alle gate CX, ma non attorno alla gate di Hadamard.
Vediamo due esempi di Pauli twirling in azione.
Pauli twirling per sopprimere l'accumulo coerente
Per osservare come il Pauli twirling possa trasformare l'accumulo coerente di errori in un accumulo incoerente più lento, vogliamo un circuito e un osservabile che funzionino come uno stress test per gli errori coerenti. L'unico scopo è rendere visibili gli errori a due qubit che si accumulano coerentemente, e poi mostrare come il Pauli twirling converte questo accumulo coerente in un decadimento stocastico.
Le gate CNOT (o CZ) sono una fonte comune di errori coerenti. L'esperimento più semplice che possiamo fare in questo caso è inizializzare uno stato (diciamo ), applicare livelli di coppie di gate CNOT (usando il fatto che due CNOT producono un'identità), e verificare come gli errori si accumulano all'aumentare del numero di livelli, sia con che senza Pauli twirling.
L'osservabile di interesse è su un singolo qubit, che tracciamo in funzione del numero di ripetizioni di coppie CNOT.
# --- Imports ---

import numpy as np
from qiskit import QuantumCircuit
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

from qiskit_ibm_runtime import QiskitRuntimeService
from qiskit_ibm_runtime import SamplerV2 as Sampler
# Build the circuit with CX/CX identity per layer

def identity_cx_pairs(layers: int) -> QuantumCircuit:
    q = QuantumRegister(2, "q")
    c = ClassicalRegister(1, "c")  # we only measure q0
    qc = QuantumCircuit(q, c, name=f"N={layers}")

    # |+> on q0
    qc.h(q[0])

    for _ in range(layers):
        qc.barrier()
        qc.cx(q[0], q[1])
        qc.cx(q[0], q[1])

    # Measure in X basis: H then measure q0

    qc.h(q[0])
    qc.measure(q[0], c[0])

    return qc
Poiché abbiamo ruotato la nostra base prima delle misurazioni, una misurazione di corrisponde allo stato che era in appena prima della gate di Hadamard finale, e similmente per e . Pertanto, il nostro valore di aspettazione può essere calcolato semplicemente dai conteggi di meno i conteggi di .
# Compute <X> from SamplerV2 counts

def x_expect_from_counts(counts: dict[str, int]) -> float:
    shots = sum(counts.values())
    p0 = counts.get("0", 0) / shots
    p1 = counts.get("1", 0) / shots
    return p0 - p1  # <X> = P(0) - P(1) after H,measure
Selezioniamo un numero ragionevole di livelli CNOT su cui lasciare accumulare l'errore, costruiamo i nostri circuiti, poi li transpiliamo.
# Choose the number of layers for the experiment
N_layers_list = [0, 1, 2, 3, 4, 5]

circuits = [identity_cx_pairs(n) for n in N_layers_list]

# Transpile to backend ISA so that primitives run native instructions
pm = generate_preset_pass_manager(backend=backend, optimization_level=0)
isa_circuits = [pm.run(c) for c in circuits]
Tieni presente che ogni livello è costituito da più di una gate a due qubit. Monitora la profondità transpilata a due qubit usando la funzione sotto.
# We can check the 2-qubit depths of any of our circuits like this:
print(
    "two-qubit depth",
    isa_circuits[5].decompose().depth(lambda instr: len(instr.qubits) > 1),
)
two-qubit depth 15
# Configure two Samplers: (A) no twirling, (B) gate twirling
#    - No DD, no measurement twirling in both (to isolate gate twirling)
# ------------------------------
shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Ora eseguiamo i job.
# Run both jobs; extract counts; compute <X>

# Helper to run a sampler and compute <X> per circuit
def run_and_x_expect(sampler: Sampler, circ_list: list[QuantumCircuit]) -> list[float]:
    job = sampler.run(
        circ_list
    )  # shots taken from options.default_shots unless overridden
    result = job.result()
    # For SamplerV2, use join_data().get_counts() to combine registers if needed
    exp_vals = []
    for pub in result:
        counts = pub.join_data().get_counts()
        exp_vals.append(x_expect_from_counts(counts))
    return exp_vals

x_no_twirl = run_and_x_expect(sampler_no_twirl, isa_circuits)
x_twirl = run_and_x_expect(sampler_twirl, isa_circuits)

# ------------------------------
# 6) Print a small table
# ------------------------------
print("\nN_layers   <X> (no twirl)   <X> (gate twirl)")
for n, a, b in zip(N_layers_list, x_no_twirl, x_twirl):
    print(f"{n:7d}   {a:14.6f}   {b:14.6f}")
N_layers   <X> (no twirl)   <X> (gate twirl)
      0         0.984375         0.987549
      1         0.934326         0.936523
      2         0.844238         0.892822
      3         0.712158         0.879395
      4         0.592529         0.844971
      5         0.449463         0.785156
Infine, visualizziamo questi risultati.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using XX
ax.scatter(
    N_layers_list, x_no_twirl, c="blue", linestyle="-", label="No twirl", alpha=0.7
)

## Add values with XY4
ax.scatter(N_layers_list, x_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7)

# Add labels and plot
ax.set_xlabel("CX layers")
ax.set_ylabel("<X>")
ax.legend()
ax.set_title("Pauli twirling")
ax.grid(True)

plt.show()
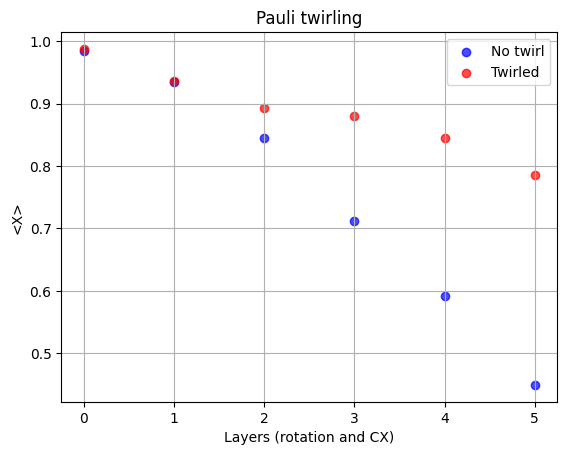
Possiamo vedere chiaramente che il circuito twirled produce un valore di aspettazione più vicino a quello ideale . Questo esempio ha servito al suo scopo, ma passiamo a qualcosa di più utile: il twirling nella produzione di stati altamente entangled.
Pauli twirling nella preparazione di stati GHZ
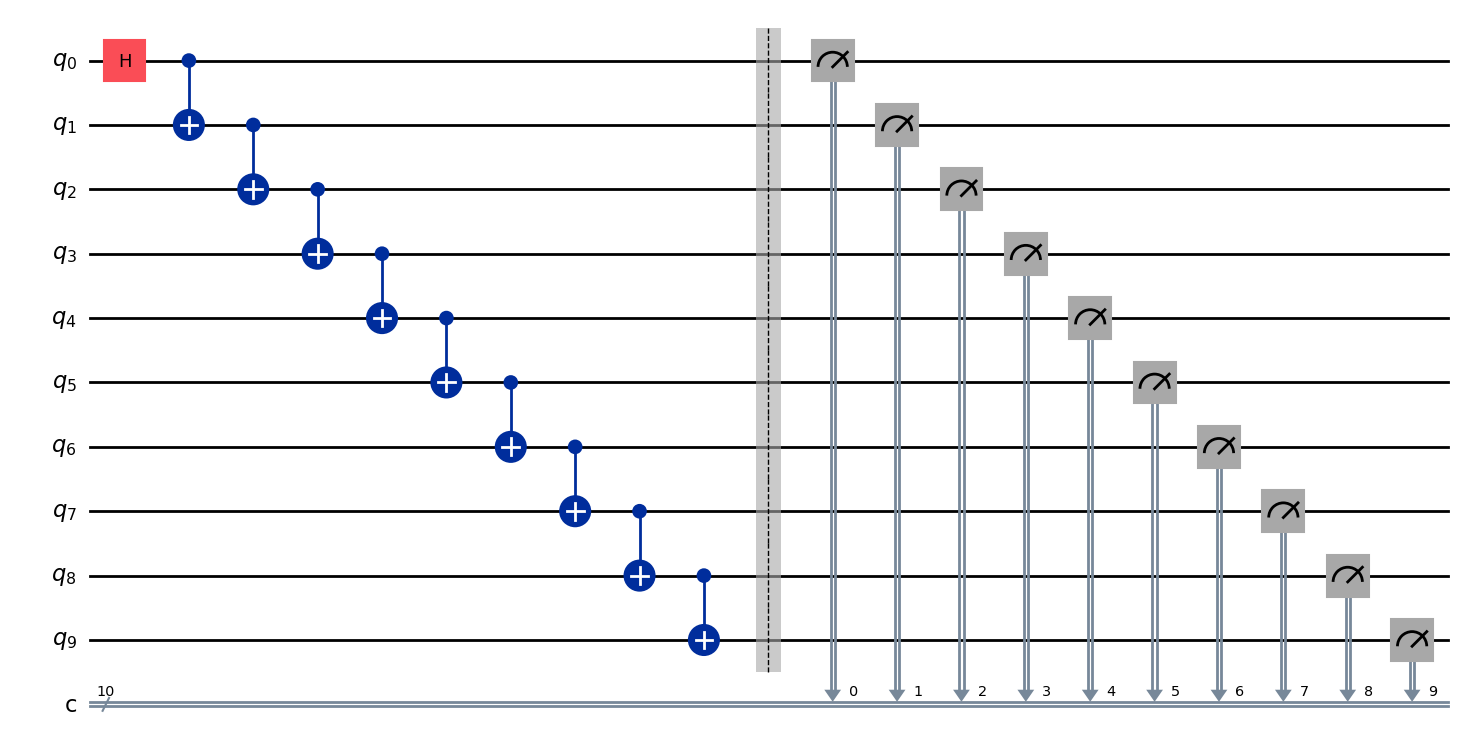
L'esempio precedente ha mostrato un caso convincente per il Pauli twirling nel distruggere l'accumulo coerente di errori associati alle gate CNOT. La produzione di stati GHZ usa molte gate CNOT per produrre stati altamente entangled utili per molte applicazioni di calcolo quantistico. Esploriamo come il Pauli twirling aiuta in questo contesto, con stati GHZ di dimensioni crescenti.
# Imports if not already loaded in previous cells
# from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager
# from qiskit import QuantumRegister, ClassicalRegister, QuantumCircuit

# Define a GHZ circuit building function, so that we can build GHZ states of increasing size.

def ghz_circuit(n: int) -> QuantumCircuit:
    q = QuantumRegister(n, "q")
    c = ClassicalRegister(n, "c")
    qc = QuantumCircuit(q, c)

    qc.h(q[0])
    for i in range(n - 1):
        qc.cx(q[i], q[i + 1])

    qc.barrier()

    qc.measure(q, c)
    return qc

# Build a test state with 10 qubits to remind ourselves of GHZ structure.

num_qubits = 10

qc_ghz = ghz_circuit(num_qubits)
qc_isa = pm.run(qc_ghz)
qc_ghz.draw("mpl")
Ora costruiamo i nostri circuiti e li transpiliamo. In questo caso, non abbiamo gate artificialmente ripetute che si riducono all'identità. Quindi possiamo permettere al pass manager di fare un po' più ottimizzazione per noi. Lo impostiamo al livello tre.
# Set up a pass manager

opt_level = 3
# --------- Build circuits for a sweep of delays ----------
pm = generate_preset_pass_manager(optimization_level=opt_level, backend=backend)

# Build GHZ circuits of increasing size.

nmin = 5
nmax = 15
circuits = []
for n in range(nmin, nmax):
    qc = ghz_circuit(n)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
Possiamo vedere che l'ottimizzatore ha mappato il nostro circuito astratto sui qubit 123, 124, 136, 142 e 143.
circuits[0].draw("mpl")
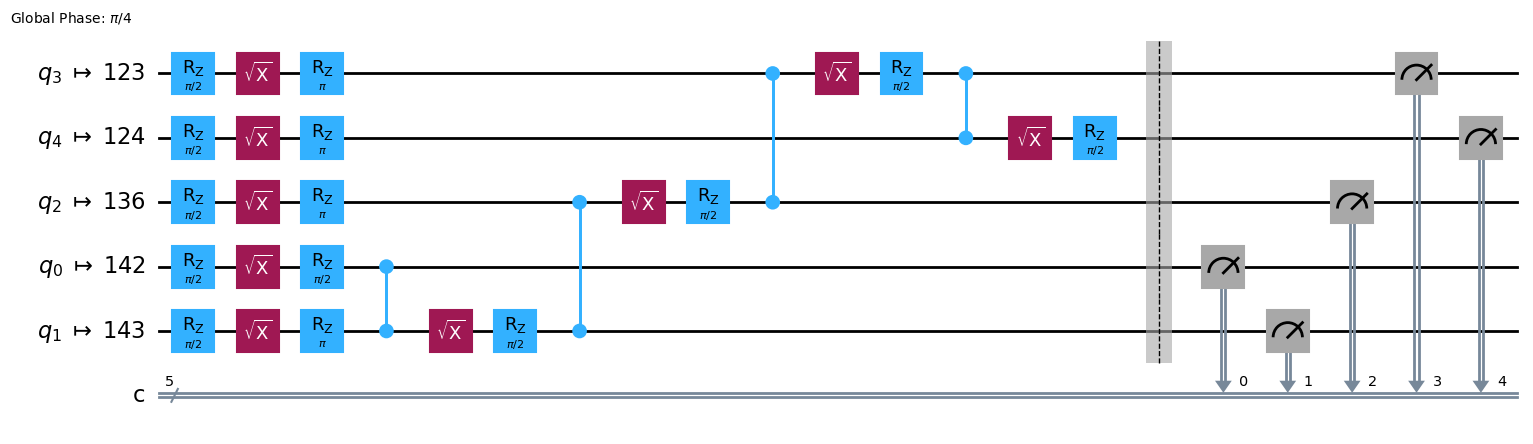
Per capire perché, diamo un'occhiata a una mappa del layout del nostro backend (in questa immagine, ibm_fez, ma puoi fare analisi equivalenti su qualsiasi backend).
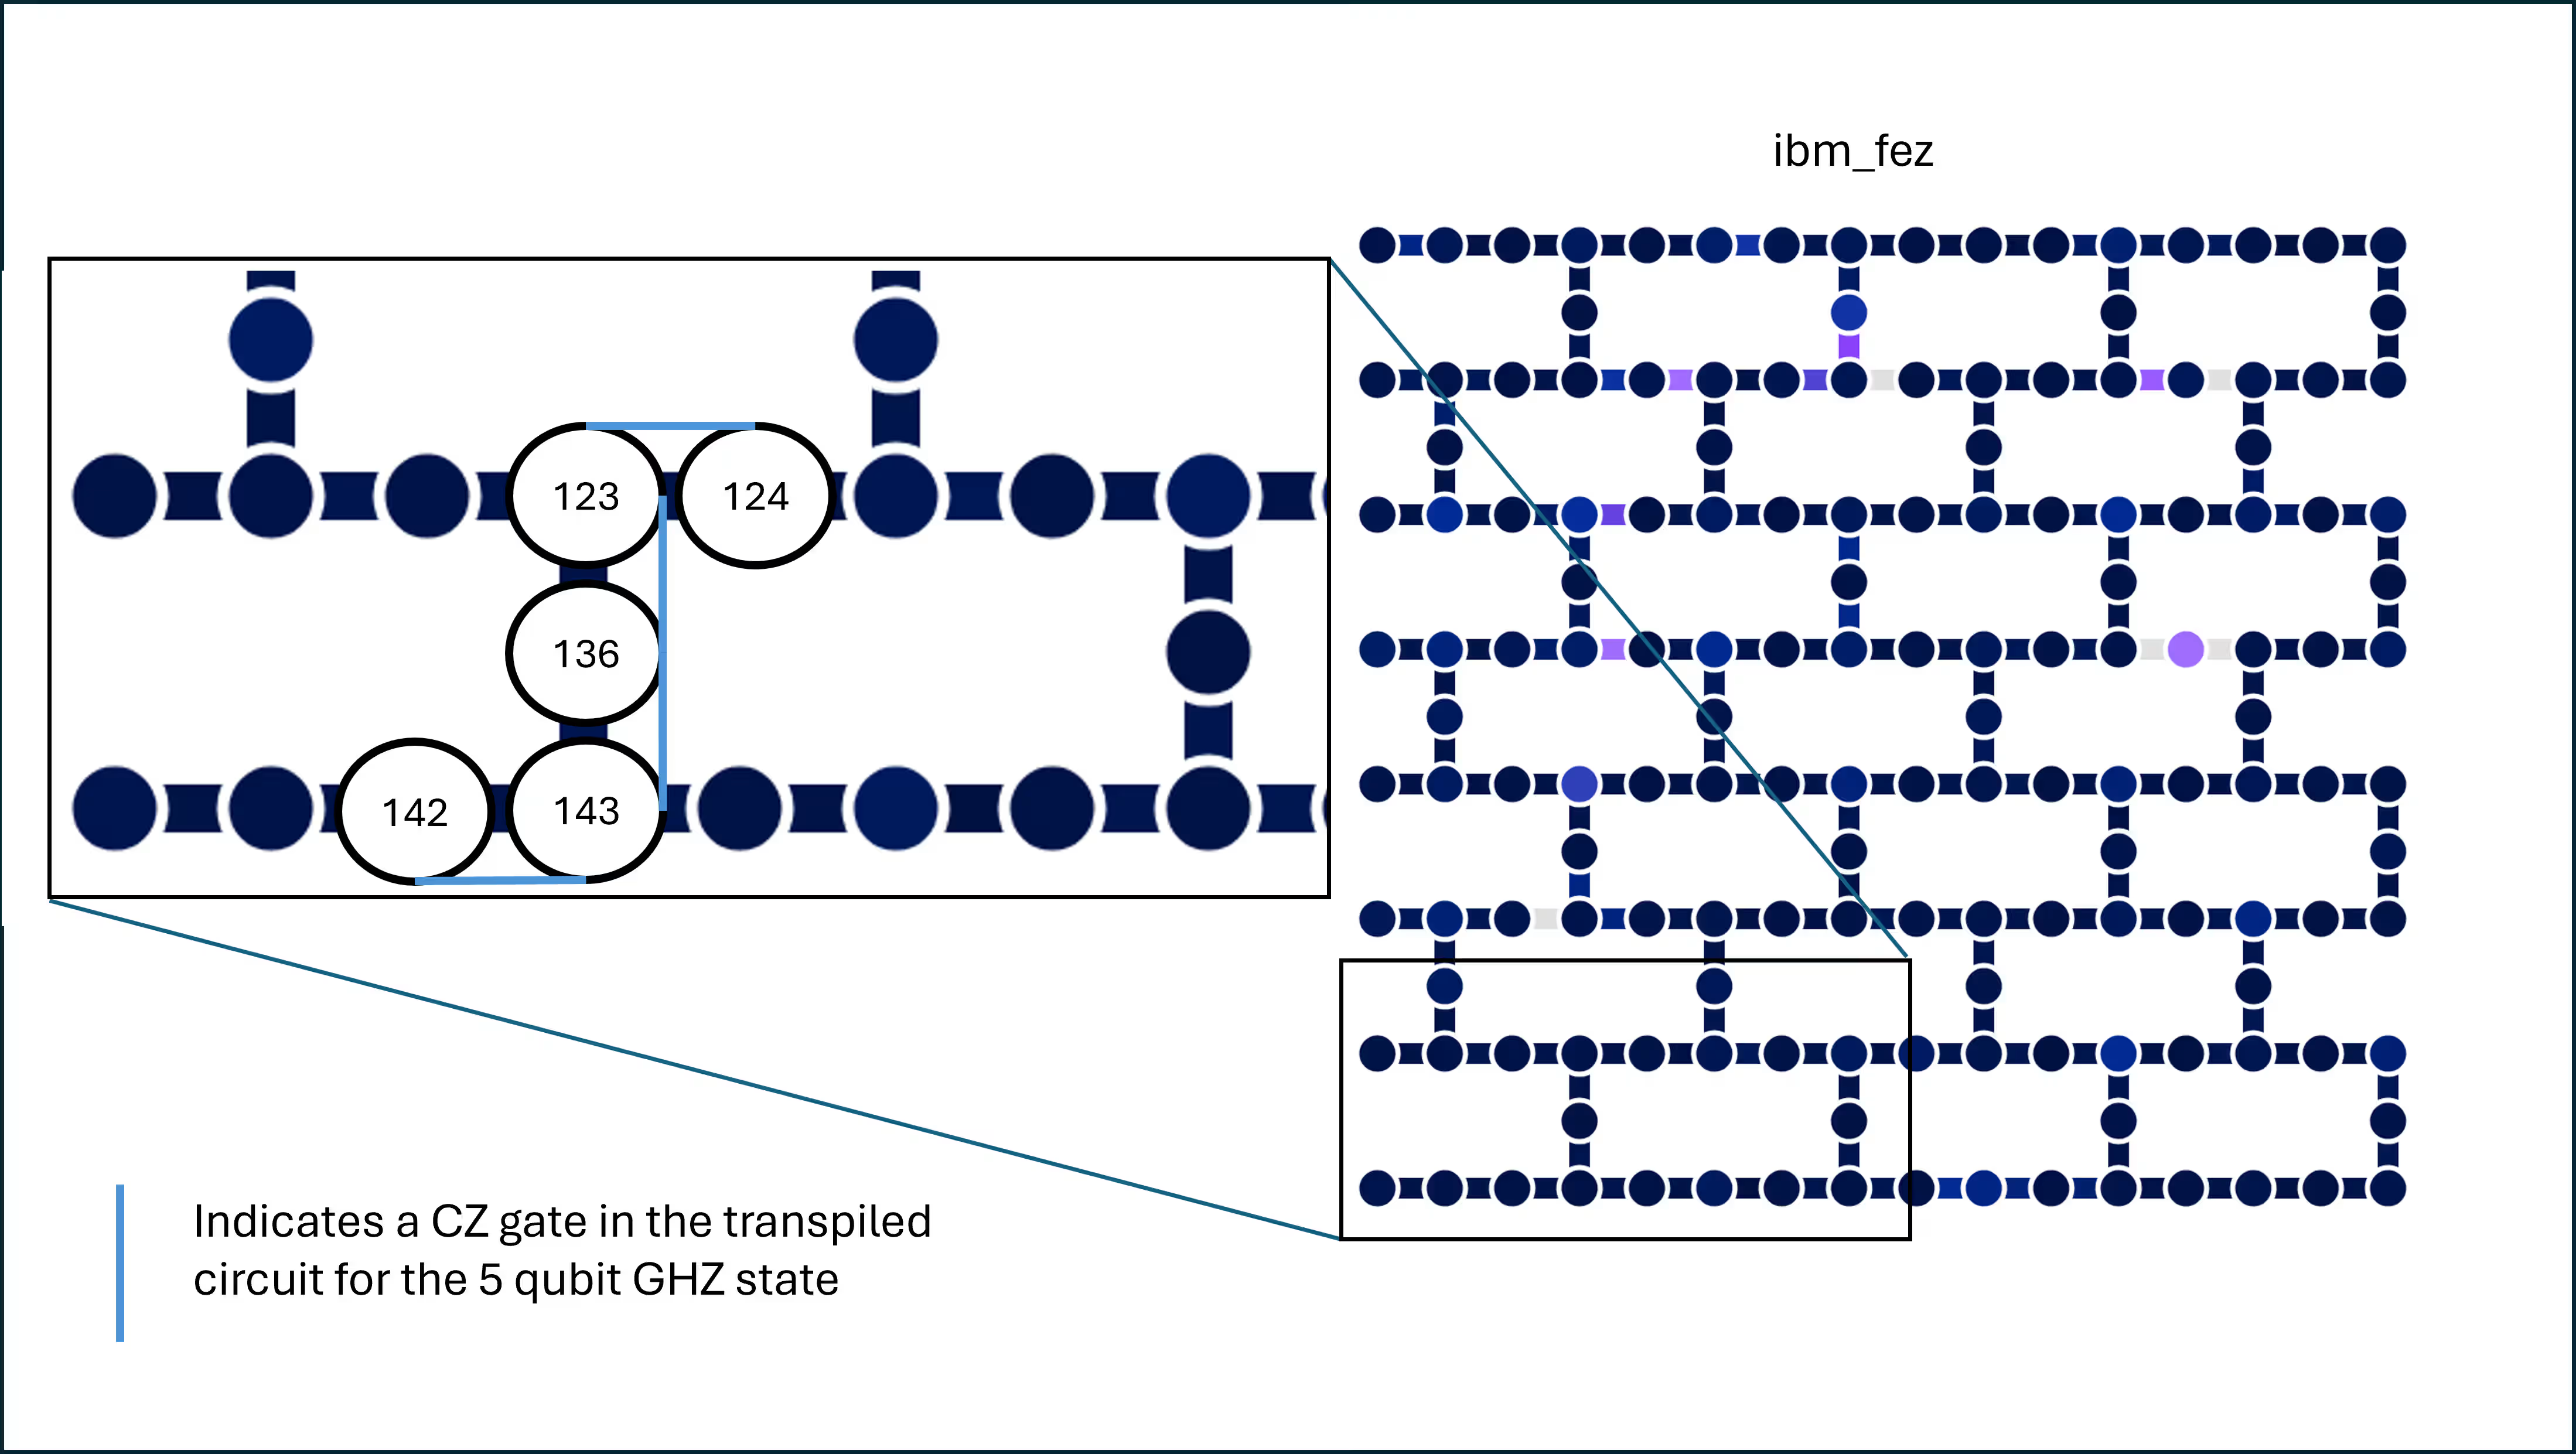
Vediamo che i qubit sono stati selezionati in una catena per minimizzare le gate di swap e quindi la profondità del circuito. Inoltre, ogni gate CZ implementata nel circuito è tra qubit adiacenti. Infine, tutti e cinque i qubit hanno tassi di errore relativamente bassi, inclusi i tassi di errore di assegnazione della lettura. Puoi controllare questi tassi di errore su qualsiasi backend nella pagina Risorse di calcolo. Trovare un tale layout non è difficile per una semplice catena lineare, ma man mano che i problemi diventano più complessi, l'ottimizzazione del layout del circuito diventa più difficile e più preziosa.
Ora configuriamo la nostra primitiva Sampler. Disattiviamo altri strumenti di soppressione/mitigazione per concentrarci sul Pauli twirling.
# Configure two Samplers: (A) no twirling, (B) gate twirling
# No DD, no measurement twirling in both (to isolate gate twirling)

shots = 8192

# (A) No twirling
sampler_no_twirl = Sampler(mode=backend)
# Ensure no extra suppression/mitigation:
sampler_no_twirl.options.dynamical_decoupling.enable = False
# Be explicit about twirling:
sampler_no_twirl.options.twirling.enable_gates = False
sampler_no_twirl.options.twirling.enable_measure = (
    False  # TREX-style measurement twirling off
)
sampler_no_twirl.options.default_shots = shots  # default shots for this primitive

# (B) Gate twirling ON
sampler_twirl = Sampler(mode=backend)
sampler_twirl.options.dynamical_decoupling.enable = False
sampler_twirl.options.twirling.enable_gates = True  # <-- enable Pauli gate twirling
sampler_twirl.options.twirling.enable_measure = False
sampler_twirl.options.default_shots = shots

# (Optional) Inspect options dicts if you’re curious
# print(asdict(sampler_no_twirl.options))
# print(asdict(sampler_twirl.options))
Infine, eseguiamo i nostri job. Puoi facoltativamente stampare i numeri di ID dei job per un recupero successivo.
job = sampler_twirl.run(circuits)
res_ghz_twirl = job.result()
job_id = job.job_id()  # job id for twirling on/true
print("job number for twirling the ghz prep is ", job_id)

job = sampler_no_twirl.run(circuits)
res_ghz_no_twirl = job.result()
job_id = job.job_id()  # job id for twirling off/false
print("job number for NO twirling the ghz prep is ", job_id)
job number for twirling the ghz prep is  d7h967bjne2c7393s0b0
job number for NO twirling the ghz prep is  d7h96f7b91ec73aufing
Estraiamo i conteggi di ogni stato di base computazionale misurato per tutti i circuiti, sia con che senza twirling.
# --------- Extract counts per circuit ----------
def extract_counts_list(res):
    counts_list = []
    for r in res:  # each r corresponds to one circuit
        # r.data.<classical_register_name>.get_counts()
        counts = r.data.c.get_counts()
        counts_list.append(counts)
    return counts_list

counts_list_ghz_twirl = extract_counts_list(res_ghz_twirl)
counts_list_ghz_no_twirl = extract_counts_list(res_ghz_no_twirl)
print(counts_list_ghz_twirl[0])
print(counts_list_ghz_twirl[4])
{'11111': 3440, '11101': 87, '00000': 3434, '10111': 87, '00001': 168, '10011': 4, '11000': 102, '00011': 39, '01111': 93, '00111': 111, '01000': 90, '11110': 235, '00110': 6, '00010': 75, '11011': 30, '11100': 42, '10000': 82, '00101': 7, '10001': 2, '11001': 6, '11010': 5, '01010': 3, '01110': 7, '00100': 14, '10101': 1, '10110': 8, '01001': 6, '10100': 1, '01101': 4, '01011': 1, '10010': 2}
{'111111111': 2683, '000000000': 2976, '111000000': 53, '110000000': 74, '111111100': 47, '111011111': 76, '111111110': 195, '111111000': 67, '000000010': 66, '011111110': 10, '011110001': 1, '101110111': 7, '101011111': 9, '111110111': 87, '111100000': 96, '111011000': 2, '010000000': 60, '111111010': 3, '100000000': 110, '111111011': 32, '000000111': 51, '000100000': 84, '000011111': 82, '000000001': 176, '100000010': 6, '111100001': 3, '000000011': 36, '101111111': 98, '100000011': 2, '001111111': 75, '000001000': 60, '000011101': 4, '110111111': 38, '111111101': 72, '111100100': 3, '000100010': 1, '001011101': 1, '000000110': 8, '110000011': 1, '000111111': 48, '000000100': 23, '000001111': 65, '010000101': 2, '000100001': 8, '111110000': 51, '010001111': 1, '111000111': 2, '111000001': 2, '000111100': 1, '011111111': 116, '111110001': 1, '000011110': 10, '000010000': 23, '000101111': 3, '000101110': 1, '011110111': 4, '010000111': 7, '111101111': 36, '001000000': 40, '010100000': 3, '101111110': 8, '110111000': 5, '000000101': 8, '010000010': 4, '000110001': 2, '110111110': 4, '111100010': 2, '111010111': 2, '000001110': 5, '111110101': 3, '001110000': 4, '101100000': 5, '001111110': 8, '100000001': 5, '111011110': 3, '111110100': 5, '110001011': 1, '001110111': 4, '000010110': 2, '111001111': 2, '000011000': 5, '010111110': 1, '000101000': 4, '101000000': 4, '100111111': 4, '111110011': 2, '000101100': 1, '101111100': 2, '111011100': 1, '001111011': 3, '011111011': 3, '110100000': 5, '000001011': 3, '111110110': 5, '111111001': 5, '000001001': 8, '010000001': 5, '011111101': 2, '001010111': 1, '011101110': 1, '110110110': 1, '001111100': 3, '100001000': 3, '001000011': 1, '001011111': 6, '110000010': 2, '110010000': 1, '010011111': 2, '111101101': 3, '101110000': 1, '111100111': 6, '010111111': 5, '110110000': 2, '011011111': 2, '110011111': 1, '110000111': 6, '001000001': 2, '001100000': 3, '101101111': 1, '000111110': 5, '111011101': 2, '100100000': 2, '101111101': 3, '001001111': 1, '001010000': 2, '111001000': 1, '011110000': 2, '011101111': 3, '000001100': 1, '110101000': 1, '011000000': 4, '111101000': 3, '110000001': 4, '000010111': 4, '011111100': 1, '111000010': 1, '101011000': 1, '101111000': 2, '001101111': 1, '010001100': 1, '000100011': 1, '111110010': 1, '111101110': 1, '100001111': 1, '100011011': 1, '010110111': 1, '001110110': 2, '100000100': 1, '001000110': 1, '100011111': 2, '010010001': 1, '111010110': 1, '011110110': 1, '000111000': 2, '000100111': 1, '011010000': 1, '001111000': 2, '100010000': 1, '011111000': 2, '110111100': 2, '110110111': 1, '110001000': 1, '000110111': 1, '000101011': 1, '000110000': 1, '011100000': 3, '001000010': 1, '001001000': 1, '001000111': 1, '001111101': 3, '111101011': 1, '111010000': 1, '100000101': 1, '000010010': 1, '001011110': 1, '000011011': 1, '111101100': 1}
Sappiamo che la distribuzione ideale di uno stato GHZ è quella in cui metà degli shot restituiscono e l'altra metà restituiscono . Costruiamo questo per il confronto.
ideal_dist = []
for n in range(nmin, nmax):
    ideal_dist.append({"0" * n: int(shots / 2), "1" * n: int(shots / 2)})
Ora usiamo la fedeltà di Hellinger come misura della qualità del nostro stato finale.
from qiskit.quantum_info import hellinger_fidelity

num_qubits = []
fidelities_twirl = []
fidelities_no_twirl = []
for n in range(len(ideal_dist)):
    num_qubits.append(nmin + n)
    fidelities_twirl.append(hellinger_fidelity(counts_list_ghz_twirl[n], ideal_dist[n]))
    fidelities_no_twirl.append(
        hellinger_fidelity(counts_list_ghz_no_twirl[n], ideal_dist[n])
    )
Infine tracciamo i nostri risultati.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

# Add values using no twirling
ax.scatter(
    num_qubits,
    fidelities_no_twirl,
    c="blue",
    linestyle="-",
    label="No twirl",
    alpha=0.7,
)

## Add values with twirling
ax.scatter(
    num_qubits, fidelities_twirl, c="red", linestyle="-", label="Twirled", alpha=0.7
)

# Add labels and plot
ax.set_xlabel("Qubits in GHZ state")
ax.set_ylabel("Hellinger fidelity")
ax.legend()
ax.set_title("Pauli twirling in GHZ states")
ax.grid(True)

plt.show()
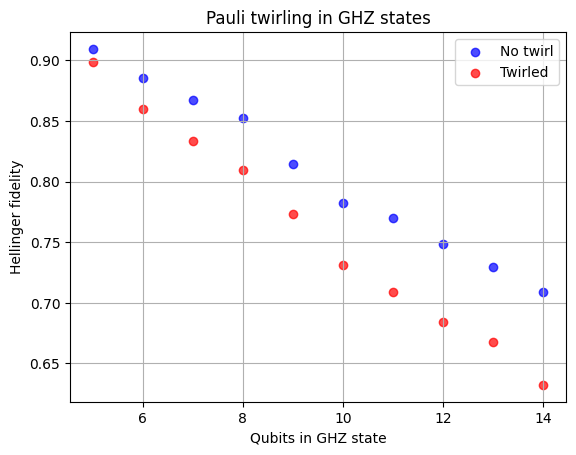
I risultati usando il Pauli twirling non sono migliori (e persino leggermente peggiori) rispetto a senza twirling. Cosa è successo?
Sono successe due cose. Primo, il Pauli twirling non riduce la quantità totale di rumore — piuttosto, trasforma errori coerenti e sistematici in errori stocastici di tipo Pauli, in modo che la crescita dell'errore diventi prevedibile e modellabile. Non c'è mai stata alcuna promessa di riduzione degli errori, tranne che in casi speciali.
Secondo, nei circuiti GHZ, alcuni errori coerenti possono parzialmente annullarsi o comportarsi come innocui spostamenti di fase a causa della simmetria della costruzione GHZ; il twirling rimuove questa protezione accidentale e la sostituisce con rumore di Pauli stocastico non correlato, quindi la fedeltà GHZ diventa leggermente peggiore con il twirling.
Questa seconda affermazione richiede qualche spiegazione. L'affermazione non è che i circuiti GHZ siano protetti da tutti i tipi di accumulo coerente di errori, solo da alcuni tipi — e che in quei casi la protezione viene distrutta dal twirling. Nello specifico, consideriamo la sovrarotazione coerente associata alle gate CX. Chiamiamo la gate CX reale con sovrarotazione :
dove è un qualsiasi prodotto di operatori di Pauli, come , , , , ecc. Per stati generali, ognuna di queste sovra-rotazioni potrebbe influenzare le statistiche di misura (e quindi le misure di fedeltà dello stato). Un sottoinsieme di questi, tuttavia, lascia invariati molti osservabili GHZ standard, inclusi operatori come e . Nel contesto della preparazione di uno stato GHZ, gli errori di sovra-rotazione rilevanti di questo tipo sarebbero:
La preparazione dell'intero stato GHZ a qubit assomiglierebbe a:
Dopo aver preparato lo stato GHZ, lo stato è idealmente:
Questo stato è un autostato simultaneo di un ampio insieme di operatori di Pauli, tra cui i seguenti:
con autovalore . Di conseguenza, un operatore della forma agisce sullo stato GHZ come moltiplicazione per il fattore di fase , che non influisce sugli osservabili GHZ standard come la parità, collettivo, o le popolazioni nella base computazionale. Così, sebbene gli errori di sovra-rotazione siano coerenti e sistematici, essi sono effettivamente invisibili alle misure usate per valutare la fedeltà GHZ. In questo senso, il circuito GHZ gode di una protezione di coerenza accidentale: alcuni errori CX coerenti commutano con la struttura dello stato in preparazione e quindi non degradano le prestazioni misurate.
Il twirling di Pauli cambia radicalmente questa situazione. Il twirling non preserva l'errore di sovra-rotazione coerente come un processo deterministico . Invece, converte il canale di errore coerente in un canale di Pauli stocastico effettivo. Di conseguenza, il canale di errore ora include termini come , , e , che non commutano con gli stabilizzatori GHZ.
Quando si verificano questi errori di Pauli stocastici, essi creano veri difetti di bit-flip e phase-flip su singoli qubit o coppie di qubit. Questi errori portano lo stato fuori dal sottospazio stabilizzatore GHZ, riducono l'interferenza tra e , e abbassano direttamente la fedeltà GHZ e i segnali di parità multi-qubit. In altre parole, il twirling di Pauli rimuove la struttura coerente dell'errore ma rimuove anche la cancellazione basata sulla simmetria che in precedenza rendeva questi errori innocui. Il risultato è uno stato GHZ leggermente peggiore — non perché il twirling aggiunga rumore, ma perché converte un errore coerente per lo più innocuo in errori stocastici genuinamente dannosi.
Questo esempio evidenzia una lezione importante: il twirling di Pauli non è una strategia di miglioramento universale. È più vantaggioso quando gli errori coerenti si accumulano lungo un circuito in modo distruttivo per la fedeltà richiesta. In circuiti altamente simmetrici come la preparazione dello stato GHZ, alcuni errori coerenti sono naturalmente allineati con gli stabilizzatori dello stato, e randomizzarli deliberatamente può eliminare questa protezione accidentale.
Combina i metodi
In linea di principio si può combinare il twirling di Pauli con il dynamical decoupling. Non abbiamo usato il DD in questo caso per due motivi: primo, non dovrebbero esserci periodi di inattività estremamente lunghi in questo circuito. Secondo, gli stati GHZ non memorizzano la maggior parte della loro informazione nella coerenza di fase a singolo qubit, in particolare se osserviamo la fedeltà solo in termini di conteggi di stringhe di bit, e non in termini della fase tra le stringhe di bit desiderate e .
Se dovessimo estendere la preparazione GHZ a 100+ qubit, i ritardi nella misura dei qubit iniziali/precoci potrebbero effettivamente essere abbastanza lunghi da rendere utile il DD. Ciò è particolarmente vero se si tiene conto della profondità transpilata del circuito.
Twirling di Pauli nella struttura echo RTZ
Il nostro esempio finale di twirling di Pauli nel contesto della riduzione dell'accumulo di errori coerenti utilizza un circuito con strati di combinazioni X-CZ-X-CZ. Questa è una sequenza di gate ben nota, spesso usata per cancellare i termini di errore ZZ coerenti nei gate a due qubit, anche senza twirling. Ma con il twirling, possiamo ridurre o randomizzare altre forme di accumulo di errori coerenti.
Inizieremo definendo una funzione per costruire i circuiti simili a RTZ con un numero variabile di strati.
from qiskit import QuantumCircuit

def rtz_echo_circuit(n_qubits: int, depth: int) -> QuantumCircuit:
    """
    Construct an RTZ echo-style circuit.

    Args:
        n_qubits: Number of qubits in the circuit.
        depth: Number of repeated echo layers.

    Returns:
        A QuantumCircuit implementing the echo sequence with measurements.
    """
    q = QuantumRegister(n_qubits, "q")
    c = ClassicalRegister(n_qubits, "c")
    qc = QuantumCircuit(q, c)

    for _ in range(depth):
        qc.h(q)

        for i in range(0, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.x(q)

        for i in range(1, n_qubits - 1, 2):
            qc.cz(q[i], q[i + 1])

        qc.h(q)

    qc.measure(q, c)
    return qc
Ora costruiamo circuiti con un numero crescente di strati, fino a una profondità totale transpilata a due qubit ragionevole.
from qiskit.transpiler.preset_passmanagers import generate_preset_pass_manager

circuits = []
qcs = []
depths = list(range(3, 27, 4))
n_qubits = 10

opt_level = 0
pm = generate_preset_pass_manager(
    optimization_level=opt_level,
    backend=backend,
    initial_layout=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9],
)

for d in depths:
    qc = rtz_echo_circuit(n_qubits, d)
    qcs.append(qc)
    qc_isa = pm.run(qc)
    circuits.append(qc_isa)
# We can check the 2-qubit depths of any of our circuits like this:
two_qubit_depths = []
for n in range(len(circuits)):
    two_qubit_depths.append(
        circuits[n].decompose().depth(lambda instr: len(instr.qubits) > 1)
    )
print(two_qubit_depths)
[6, 14, 22, 30, 38, 46]
qcs[0].draw("mpl")
# circuits[0].draw("mpl")
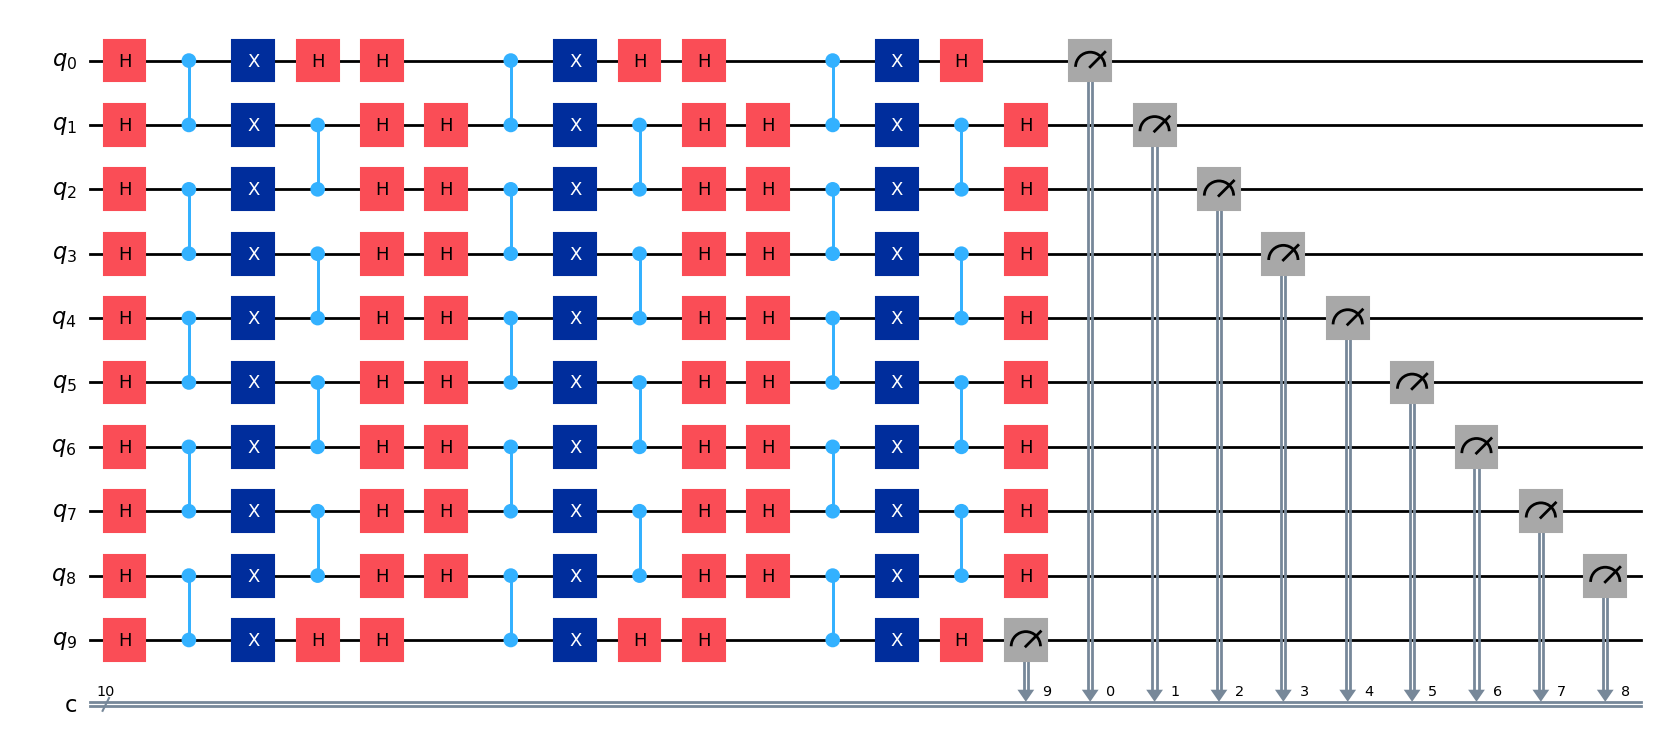
All'estremità superiore, alcuni di questi sono piuttosto profondi. Usiamo l'AerSimulator senza modello di rumore per ottenere gli stati ideali alla fine di ciascuno di questi circuiti. Possiamo quindi confrontare i nostri risultati provenienti da computer quantistici reali usando la fedeltà di Hellinger.
from qiskit_aer import AerSimulator

sim = AerSimulator()
ideal_results = sim.run(circuits, shots=8192).result()
ideal_counts = ideal_results.get_counts()
Ora definiamo un SamplerV2 con twirling e uno senza twirling.
from qiskit_ibm_runtime import SamplerV2 as Sampler

shots = 8192

# --- No Twirling ---
sampler_no = Sampler(mode=backend)
sampler_no.options.twirling.enable_gates = False
sampler_no.options.twirling.enable_measure = False
sampler_no.options.default_shots = shots

# --- With Twirling ---
sampler_tw = Sampler(mode=backend)
sampler_tw.options.twirling.enable_gates = True
sampler_tw.options.twirling.enable_measure = False
# sampler_tw.options.twirling.num_randomizations = "auto"
sampler_tw.options.twirling.num_randomizations = 32
sampler_tw.options.twirling.strategy = "active-circuit"
sampler_tw.options.default_shots = shots
Ora eseguiamo i nostri job.
# Each job took 17 sec (34 sec total) on ibm_fez. Your times might vary.

job_no = sampler_no.run(circuits)
job_tw = sampler_tw.run(circuits)

res_no = job_no.result()
res_tw = job_tw.result()
Otteniamo i conteggi da ciascuna delle esecuzioni su un computer quantistico reale.
counts_no = [r.data.c.get_counts() for r in res_no]
counts_tw = [r.data.c.get_counts() for r in res_tw]
Ora troviamo la fedeltà di Hellinger confrontando ciascuna di queste esecuzioni con i risultati dell'AerSimulator privi di rumore.
from qiskit.quantum_info import hellinger_fidelity

f_no = [hellinger_fidelity(counts_no[i], ideal_counts[i]) for i in range(len(circuits))]

f_tw = [hellinger_fidelity(counts_tw[i], ideal_counts[i]) for i in range(len(circuits))]
Ora visualizziamo i nostri risultati.
import matplotlib.pyplot as plt

plt.figure(figsize=(8, 5))
plt.plot(two_qubit_depths, f_no, "o-", label="No Twirling")
plt.plot(two_qubit_depths, f_tw, "o-", label="With Twirling")
plt.xlabel("Two-qubit transpiled depth")
plt.ylabel("Hellinger Fidelity")
plt.title("RTZ Echo Circuit: Twirling vs No Twirling")
plt.legend()
plt.grid(True)
plt.show()
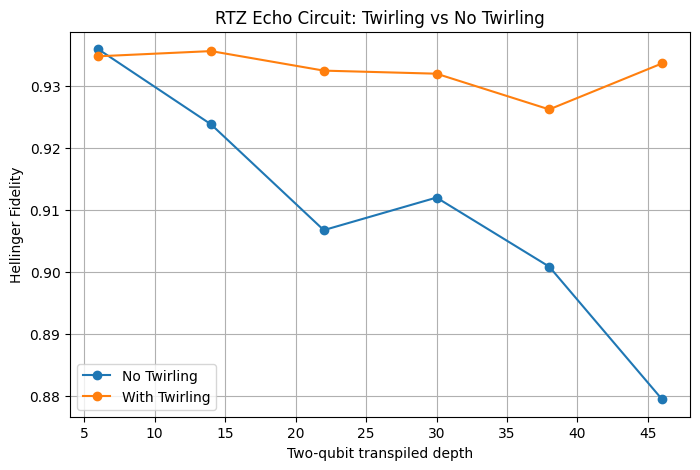
Nel corso di questa lezione, abbiamo esaminato casi in cui il twirling di Pauli è usato per limitare l'accumulo di errori coerenti, un contesto in cui potrebbe essere descritto come soppressione dell'errore. Tuttavia, il twirling di Pauli è spesso più utile come strumento per rimodellare il comportamento dell'errore, convertendo gli errori coerenti in una forma più prevedibile e più facile da modellare. L'utilità di ciò diventerà più evidente nel contesto delle tecniche di mitigazione degli errori come l'estrapolazione a rumore zero (ZNE), che si basano su una scalabilità del rumore ragionevolmente prevedibile. Questo viene discusso nella prossima lezione.