Limitare la dimensione del sottospazio
In questa guida passo passo mostreremo l'effetto della dimensione del sottospazio nella tecnica di recupero auto-consistente delle configurazioni.
A priori non sappiamo quale sia la dimensione corretta del sottospazio per ottenere un determinato livello di accuratezza. Sappiamo però che aumentare la dimensione del sottospazio aumenta l'accuratezza del metodo. Pertanto possiamo studiare l'accuratezza delle previsioni in funzione della dimensione del sottospazio. Specifica la molecola e le sue proprietà.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "pyscf": "pyscf", "qiskit_addon_sqd": "qiskit-addon-sqd"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import warnings

import pyscf
import pyscf.cc
import pyscf.mcscf

warnings.filterwarnings("ignore")

# Specify molecule properties
open_shell = False
spin_sq = 0

# Build N2 molecule
mol = pyscf.gto.Mole()
mol.build(
    atom=[["N", (0, 0, 0)], ["N", (1.0, 0, 0)]],
    basis="6-31g",
    symmetry="Dooh",
)

# Define active space
n_frozen = 2
active_space = range(n_frozen, mol.nao_nr())

# Get molecular integrals
scf = pyscf.scf.RHF(mol).run()
num_orbitals = len(active_space)
n_electrons = int(sum(scf.mo_occ[active_space]))
num_elec_a = (n_electrons + mol.spin) // 2
num_elec_b = (n_electrons - mol.spin) // 2
cas = pyscf.mcscf.CASCI(scf, num_orbitals, (num_elec_a, num_elec_b))
mo = cas.sort_mo(active_space, base=0)
hcore, nuclear_repulsion_energy = cas.get_h1cas(mo)
eri = pyscf.ao2mo.restore(1, cas.get_h2cas(mo), num_orbitals)

# Compute exact energy
exact_energy = cas.run().e_tot
converged SCF energy = -108.835236570775
CASCI E = -109.046671778080  E(CI) = -32.8155692383188  S^2 = 0.0000000
Genera alcune bitstring casuali come proxy dei campioni di una QPU.
import numpy as np
from qiskit_addon_sqd.counts import generate_bit_array_uniform

# Create a seed to control randomness throughout this workflow
rng = np.random.default_rng(24)

# Generate random samples
bit_array = generate_bit_array_uniform(
    10_000, num_orbitals * 2, rand_seed=rng
)
Chiama SQD con dimensioni di batch crescenti.
from qiskit_addon_sqd.fermion import diagonalize_fermionic_hamiltonian

list_samples_per_batch = [50, 200, 400, 600]

# SQD options
max_iterations = 5

# Eigenstate solver options
num_batches = 10
max_davidson_cycles = 200

energies = []
subspace_dimensions = []

for samples_per_batch in list_samples_per_batch:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        seed=rng,
    )
    energies.append(result.energy)
    subspace_dimensions.append(np.prod(result.sci_state.amplitudes.shape))
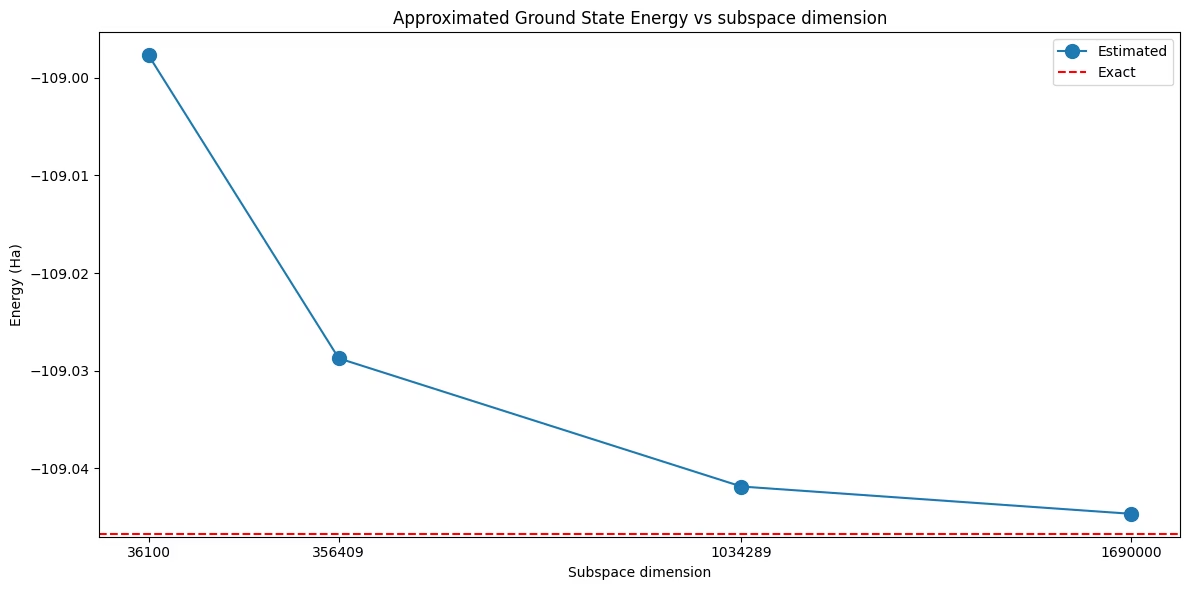
Questo grafico mostra che aumentare la dimensione del sottospazio porta a risultati più accurati.
import matplotlib.pyplot as plt

# Data for energies plot
x1 = subspace_dimensions
y1 = np.array(energies) + nuclear_repulsion_energy

fig, axs = plt.subplots(1, 1, figsize=(12, 6))

# Plot energies
axs.plot(x1, y1, marker=".", markersize=20, label="Estimated")
axs.set_xticks(x1)
axs.set_xticklabels(x1)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()
Impostare un limite esplicito con max_dim
Nella scansione precedente, la dimensione del sottospazio era controllata solo indirettamente. samples_per_batch stabilisce quante bitstring vengono estratte in ciascun batch, ma la dimensione del sottospazio risultante è determinata da quante stringhe distinte di spin alpha e spin beta contengono quelle bitstring, e il pool di configurazioni disponibili per il sottocampionamento cresce da un'iterazione di recupero delle configurazioni alla successiva. Per questo motivo le dimensioni del sottospazio sull'asse orizzontale qui sopra sono numeri irregolari che non abbiamo scelto noi.
L'argomento max_dim di diagonalize_fermionic_hamiltonian limita direttamente la dimensione. Limita il numero di stringhe CI mantenute in ciascun settore di spin e, poiché il sottospazio è generato dal prodotto cartesiano dei due settori, la sua dimensione è il prodotto delle dimensioni dei due settori:
-
max_dim=dlimita entrambi i settori adstringhe, quindi la dimensione del sottospazio è al massimod ** 2. -
max_dim=(d_a, d_b)limita separatamente i settori di spin alpha e spin beta, quindi la dimensione del sottospazio è al massimod_a * d_b. Quandosymmetrize_spin=True, i due limiti devono essere uguali. -
max_dim=None, il valore predefinito, non impone alcun limite.
Quando un batch contiene più stringhe di quante il limite ne consenta, quelle meno importanti vengono scartate: le stringhe passate tramite include_configurations vengono mantenute per prime, seguite dalle stringhe riportate dall'iterazione precedente (vedi carryover_threshold), e gli slot rimanenti vengono riempiti con le stringhe campionate in ordine decrescente di frequenza di campionamento.
Poiché max_dim limita la dimensione della più grande diagonalizzazione che verrà richiesta al risolutore di autostati, è un modo comodo per mantenere il risolutore entro un budget di tempo di esecuzione e di memoria: scegli samples_per_batch in modo generoso e lascia che sia max_dim a decidere fino a che punto il sottospazio può crescere.
Di seguito ripetiamo lo studio, questa volta mantenendo fisso samples_per_batch e aumentando max_dim.
list_max_dim = [100, 200, 400, 800]

# Use a generous number of samples per batch, so that max_dim is what limits
# the dimension of the subspace
samples_per_batch = 600

energies_max_dim = []
subspace_dimensions_max_dim = []

for max_dim in list_max_dim:
    result = diagonalize_fermionic_hamiltonian(
        hcore,
        eri,
        bit_array,
        samples_per_batch=samples_per_batch,
        norb=num_orbitals,
        nelec=(num_elec_a, num_elec_b),
        num_batches=num_batches,
        max_iterations=max_iterations,
        symmetrize_spin=True,
        max_dim=max_dim,
        seed=rng,
    )
    energies_max_dim.append(result.energy)
    subspace_dimensions_max_dim.append(
        int(np.prod(result.sci_state.amplitudes.shape))
    )

print(f"max_dim:            {list_max_dim}")
print(f"subspace dimension: {subspace_dimensions_max_dim}")
max_dim:            [100, 200, 400, 800]
subspace dimension: [10000, 40000, 160000, 640000]
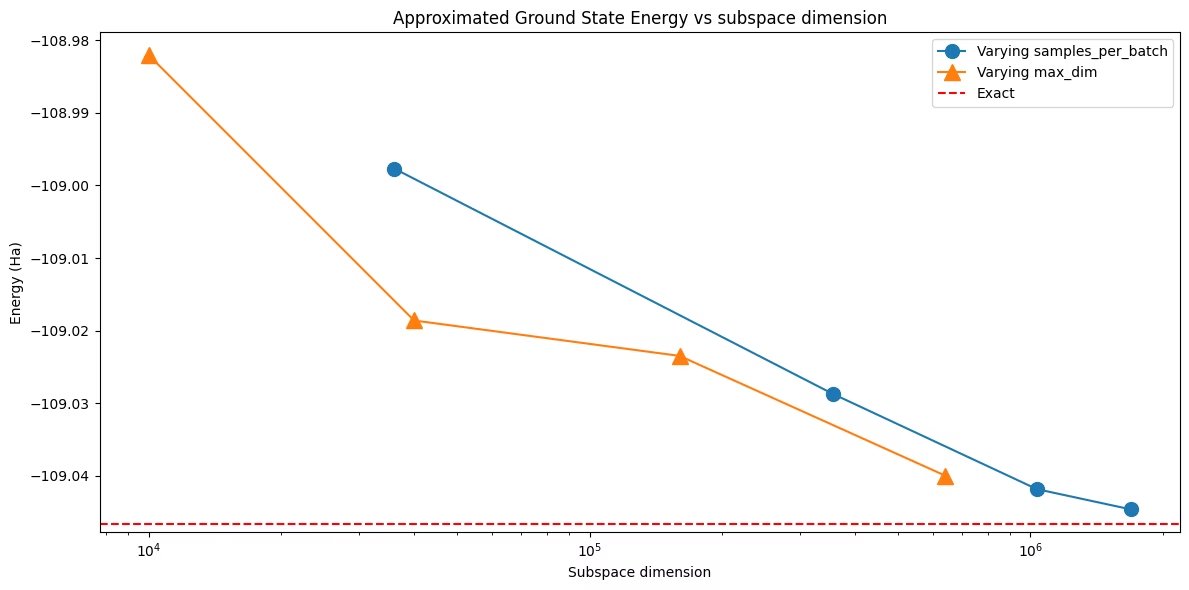
La dimensione del sottospazio è ora esattamente max_dim ** 2 in ogni esecuzione: è stata scelta anziché scoperta. Tracciare insieme entrambe le scansioni mostra che l'accuratezza è governata dalla dimensione del sottospazio stessa, qualunque sia l'argomento usato per ottenerla. Le due curve, tuttavia, non devono necessariamente coincidere esattamente. Le esecuzioni con max_dim estraggono 600 bitstring per batch e poi mantengono le stringhe campionate più frequentemente, quindi, a parità di dimensione, possono conservare un insieme di configurazioni migliore rispetto a un'esecuzione che ha raggiunto quella dimensione campionando fin dall'inizio meno bitstring.
fig, axs = plt.subplots(1, 1, figsize=(12, 6))

axs.plot(
    subspace_dimensions,
    np.array(energies) + nuclear_repulsion_energy,
    marker=".",
    markersize=20,
    label="Varying samples_per_batch",
)
axs.plot(
    subspace_dimensions_max_dim,
    np.array(energies_max_dim) + nuclear_repulsion_energy,
    marker="^",
    markersize=12,
    label="Varying max_dim",
)
axs.axhline(y=exact_energy, color="red", linestyle="--", label="Exact")
axs.set_xscale("log")
axs.ticklabel_format(axis="y", useOffset=False)
axs.set_title("Approximated Ground State Energy vs subspace dimension")
axs.set_xlabel("Subspace dimension")
axs.set_ylabel("Energy (Ha)")
axs.legend()

plt.tight_layout()
plt.show()