Aggiornare le proprietà del backend con benchmarking in tempo reale
Stima di utilizzo: 3 minuti su ibm_kingston (NOTA: questa è solo una stima. Il tuo runtime potrebbe variare.)
Risultati di apprendimento
-
Perché le proprietà riportate da una QPU possono essere in ritardo rispetto al comportamento attuale del dispositivo, e quando vale la pena rimisurarle tu stesso
-
Cosa misura ciascuno dei cinque esperimenti di caratterizzazione standard (lettura, benchmarking randomizzato a singolo qubit, benchmarking randomizzato a due qubit stratificato, e )
-
Come eseguire l'intera suite di caratterizzazione in una singola chiamata o passo dopo passo, e ottenere un oggetto backend con proprietà aggiornate
-
Come confrontare le proprietà misurate con quelle riportate, e perché alcune differenze riflettono la metodologia di misura piuttosto che la deriva del dispositivo
Prerequisiti
-
Il flusso di lavoro Qiskit patterns
-
Modalità di esecuzione di Qiskit Runtime, in particolare batch mode
-
Come esplorare le informazioni sulla QPU, come le proprietà del backend e i dati di calibrazione
Contesto
Ogni QPU IBM Quantum® riporta un insieme di proprietà che descrivono quanto bene funziona attualmente ciascuno dei suoi qubit: tempi di rilassamento (), tempi di coerenza (), errori di lettura ed errori dei gate a uno e due qubit. Questi numeri contano nella pratica. Il transpiler li usa per decidere su quali qubit fisici dovrebbe essere eseguito il tuo circuito, le tecniche di mitigazione degli errori si basano su di essi, e potresti usarli per giudicare se un dispositivo funziona abbastanza bene per un esperimento.
Le proprietà riportate provengono da procedure di calibrazione che tipicamente vengono eseguite circa una volta al giorno. I qubit superconduttori, tuttavia, possono derivare su scale temporali più brevi, e difetti transitori (i cosiddetti sistemi a due livelli) possono temporaneamente degradare un qubit che sembrava eccellente al momento della calibrazione. Inoltre, un job viene spesso transpilato molto prima che venga effettivamente eseguito, quindi le decisioni basate sulle proprietà riportate possono basarsi su informazioni obsolete. Il tutorial Benchmarking in tempo reale per la selezione dei qubit mostra quanto queste proprietà possano fluttuare di giorno in giorno, e costruisce a mano un flusso di lavoro di caratterizzazione completo a partire da singoli Qiskit Experiments.
Questo tutorial mostra la versione semplificata di quel flusso di lavoro, usando l'utility BackendCharacterization di Qiskit Device Benchmarking, che raggruppa la costruzione degli esperimenti, l'invio dei job e l'adattamento delle curve in poche chiamate. Impieghi circa 70 secondi di tempo di QPU e ottieni in cambio un oggetto backend le cui proprietà riflettono il dispositivo proprio ora, pronto per essere confrontato con i valori riportati o passato a strumenti a valle.
Gli esperimenti di caratterizzazione
La suite misura cinque proprietà, ciascuna con un esperimento standard:
-
Errore di lettura (
readout): Ogni qubit viene preparato in o e misurato immediatamente. La probabilità di leggere lo stato sbagliato fornisce l'errore di preparazione e misurazione dello stato (SPAM). -
Errore di gate a singolo qubit (
rb_1q): Il randomized benchmarking (RB) esegue sequenze di gate Clifford a singolo qubit casuali che idealmente compongono l'identità. Il modo in cui la probabilità di sopravvivenza decade con la lunghezza della sequenza fornisce l'errore medio per gate, indipendentemente dagli errori SPAM. -
Errore di gate a due qubit (
rb_2q): La stessa idea del RB applicata a intere layer di gate a due qubit non sovrapposti eseguiti simultaneamente, come in un esperimento di layer fidelity. Poiché molti gate vengono eseguiti contemporaneamente, i tassi di errore risultanti includono effetti di crosstalk e sono più vicini a ciò che un circuito profondo sperimenta realmente. -
(
t1): Ogni qubit viene eccitato e misurato dopo ritardi crescenti. Il decadimento della popolazione dello stato eccitato fornisce il tempo di rilassamento. -
(
t2): Un esperimento di eco di Hahn pone ogni qubit in una sovrapposizione, applica un impulso di eco a metà di un ritardo e misura quanto rapidamente si perde la coerenza di fase. Per impostazione predefinita viene usato un singolo eco; una variante multi-eco (in stile CPMG) viene dimostrata alla fine di questo tutorial.
Cosa fa e cosa non fa l'aggiornamento
Tieni presenti tre punti quando usi questo workflow:
-
Le proprietà aggiornate esistono solo nell'oggetto backend restituito a te. Nulla cambia sul dispositivo stesso o nei dati di calibrazione che IBM Quantum riporta ad altri utenti.
-
I valori misurati sono un'istantanea presa con una metodologia particolare. Alcuni di essi, in particolare gli errori a due qubit stratificati e i valori paralleli a singolo eco, sono misurati diversamente rispetto ai dati di calibrazione riportati, quindi parte di qualsiasi divario osservato è di natura metodologica piuttosto che dovuta a drift. Questo tutorial segnala dove ciò accade.
-
La caratterizzazione stessa costa tempo di QPU (circa 70 secondi per l'intera suite su un processore Heron r2), che è il prezzo da pagare per informazioni aggiornate.
Il workflow segue i quattro passaggi di un Qiskit pattern:
-
Passo 1: Mappare gli input classici in un problema quantistico. Scegli il dispositivo e l'insieme di proprietà da misurare.
-
Passo 2: Ottimizzare il problema per l'esecuzione su hardware quantistico. L'utility costruisce i circuiti dell'esperimento direttamente nei gate nativi del dispositivo e li parallelizza attraverso il chip.
-
Passo 3: Eseguire usando le primitive Qiskit. Gli esperimenti vengono eseguiti come job Sampler all'interno di un batch.
-
Passo 4: Post-elaborare e restituire il risultato nel formato classico desiderato. Adatta i dati di misurazione in mappe di errore per qubit, aggiorna il backend e confronta le proprietà misurate con quelle riportate.
Requisiti
Prima di iniziare questo tutorial, assicurati di avere installato quanto segue:
-
Qiskit SDK v2.0 o successivo, con supporto visualization
-
Qiskit Runtime v0.40 o successivo (
pip install qiskit-ibm-runtime) -
Qiskit Device Benchmarking, che installa anche Qiskit Experiments (
pip install git+https://github.com/qiskit-community/qiskit-device-benchmarking.git)
Configurazione
Importa le librerie richieste.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit_device_benchmarking": "git+https://github.com/qiskit-community/qiskit-device-benchmarking.git", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import logging
import sys

import numpy as np
from qiskit_ibm_runtime import Batch, QiskitRuntimeService

from qiskit_device_benchmarking.utilities.characterization_utils import (
    BackendCharacterization,
    plot_characterization_comparison,
)
La suite di caratterizzazione costruisce diversi esperimenti, invia più job e adatta i risultati, il che può richiedere un paio di minuti in totale. Abilita il logging a livello INFO in modo che ogni fase stampi il suo progresso man mano che avviene.
logger = logging.getLogger("qiskit_device_benchmarking")
logger.setLevel(logging.INFO)
logger.addHandler(logging.StreamHandler(stream=sys.stdout))
Esempio su simulatore a piccola scala
Questo tutorial non include un esempio su simulatore. Il workflow misura le imperfezioni fisiche di un dispositivo specifico: quanto velocemente i suoi qubit si rilassano e perdono coerenza di fase, e quanto spesso i suoi gate e la lettura falliscono. Un simulatore ideale non ha nessuna di queste imperfezioni, quindi non c'è nulla da caratterizzare. Potresti collegare un modello di rumore sintetico a un backend fittizio, ma gli esperimenti recupererebbero allora solo i numeri che hai inserito tu stesso. Per questo motivo, procediamo direttamente con l'hardware, suddiviso nei quattro passaggi di un Qiskit pattern.
Esempio su hardware a grande scala
Passo 1: Mappare gli input classici in un problema quantistico
In questo workflow il "problema" è il dispositivo stesso: gli input classici sono la QPU che vuoi caratterizzare e l'elenco di proprietà da misurare, e gli esperimenti quantistici sono i circuiti di caratterizzazione generati da essi.
Innanzitutto, seleziona un backend. Questo tutorial utilizza ibm_kingston, un processore Heron r2 a 156 qubit; puoi sostituirlo con qualsiasi dispositivo IBM Quantum a cui hai accesso (oppure sceglierne uno con service.least_busy()).
service = QiskitRuntimeService()
device = "ibm_kingston"
backend = service.backend(device)
Successivamente, scegli quali proprietà misurare. Puoi passare qualsiasi sottoinsieme dei seguenti esperimenti:
-
readout: esperimento SPAM (preparazione e misurazione dello stato) -
rb_1q: randomized benchmarking a singolo qubit isolato -
rb_2q: randomized benchmarking simultaneo a due qubit da un esperimento di layer fidelity -
t2: esperimento di eco di Hahn (un singolo eco per impostazione predefinita) -
t1: esperimento di rilassamento
Esegui l'intera suite per ottenere un quadro completo del dispositivo; rimuovi le voci dall'elenco se ti interessano solo alcune proprietà e vuoi risparmiare tempo di QPU.
experiments = ["readout", "rb_1q", "rb_2q", "t1", "t2"]
Passo 2: Ottimizzare il problema per l'esecuzione su hardware quantistico
Nella maggior parte dei tutorial è qui che effettueresti la transpilazione dei tuoi circuiti. Qui, BackendCharacterization se ne occupa internamente. Costruisce i circuiti dell'esperimento direttamente nei gate nativi del dispositivo, esegue gli esperimenti a singolo qubit su tutti i qubit in parallelo e pianifica il benchmarking a due qubit su layer disgiunti della coupling map in modo che l'intero dispositivo sia coperto con una manciata di job. Grazie a questa parallelizzazione, l'intera suite consuma solo circa 70 secondi di tempo di QPU.
Inizializza la classe che gestisce il workflow:
# Initialize the class used to run the experiments
characterizer = BackendCharacterization(backend)
Passo 3: Eseguire usando le primitive Qiskit
Il metodo run_experiments costruisce i circuiti e li invia come job Sampler. Eseguilo all'interno di un contesto Batch in modo che i job vengano pianificati insieme sulla QPU, e il metodo restituisce il controllo una volta che tutti i job sono stati inviati. (Puoi anche eseguirlo al di fuori di un batch, oppure all'interno di una Session.)
Potresti vedere un avviso relativo al passaggio di un Backend mentre un context manager di Session è aperto. Questo è previsto e può essere tranquillamente ignorato.
# Run the characterization experiments inside a Batch
with Batch(backend=backend):
    jobs = characterizer.run_experiments(experiments=experiments)
base_primitive.get_mode_service_backend:WARNING:2026-07-14 14:23:02,051: A backend was passed in as the mode but a session context manager is open so this job will run inside this session/batch instead of in job mode.
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7tfu6hjac73ffba2g', 'd9b7tjug26ic73dfju3g', 'd9b7u3u6hjac73ffban0', 'd9b7u7rv6alc73csmicg']
Readout job submitted: d9b7u8bv6alc73csmidg
T1 experiment submitted: ['d9b7u8ug26ic73dfjuqg']
T2 (Hahn) experiment submitted: ['d9b7u9fu62qs738othg0']
Single-qubit RB submitted: ['d9b7v8m6hjac73ffbc40', 'd9b7veeg26ic73dfk040']
Il metodo restituisce i job inviati come un dizionario indicizzato per esperimento, il che è utile per tracciarli sulla dashboard di IBM Quantum Platform o per il debug.
# Print all the job IDs for debugging purposes
jobs
{'rb_2q': [<RuntimeJobV2('d9b7tfu6hjac73ffba2g', 'sampler')>,
  <RuntimeJobV2('d9b7tjug26ic73dfju3g', 'sampler')>,
  <RuntimeJobV2('d9b7u3u6hjac73ffban0', 'sampler')>,
  <RuntimeJobV2('d9b7u7rv6alc73csmicg', 'sampler')>],
 'readout': [<RuntimeJobV2('d9b7u8bv6alc73csmidg', 'sampler')>],
 't1': [<RuntimeJobV2('d9b7u8ug26ic73dfjuqg', 'sampler')>],
 't2': [<RuntimeJobV2('d9b7u9fu62qs738othg0', 'sampler')>],
 'rb_1q': [<RuntimeJobV2('d9b7v8m6hjac73ffbc40', 'sampler')>,
  <RuntimeJobV2('d9b7veeg26ic73dfk040', 'sampler')>]}
Passo 4: Post-elaborare e restituire il risultato nel formato classico desiderato
Analizza i risultati
Il metodo analyze_results attende il completamento dei job e adatta i dati di misurazione: decadimenti esponenziali per e , decadimenti della probabilità di sopravvivenza per gli esperimenti RB e matrici di assegnazione per la lettura. Restituisce un dizionario di mappe di errore, una voce per ogni proprietà misurata, ciascuna che associa un qubit (o una coppia di qubit) al suo valore misurato.
error_maps = characterizer.analyze_results()
print(f"The following error maps are available: {list(error_maps.keys())}")
readout_q0 = error_maps["readout_error"][0]
print(f"For example, readout error for qubit 0 is {readout_q0}")
The following error maps are available: ['readout_error', 'oneq_error_x', 'oneq_error_sx', 'lf_error_map', 't1_map', 't2_map']
For example, readout error for qubit 0 is 0.007600000000000051
Le mappe coprono l'errore di lettura, gli errori dei gate a singolo qubit x e sx, gli errori a due qubit stratificati (lf_error_map, dall'esperimento di layer fidelity), e i tempi e in secondi.
Aggiorna le proprietà del backend
Il metodo update_backend scrive i valori misurati nelle proprietà di una copia del backend e la restituisce. L'oggetto backend originale conserva i dati di calibrazione riportati, in modo da poter confrontare i due, come mostrato di seguito. Ricorda che questo aggiornamento è puramente locale alla tua sessione Python; non cambia nulla sul dispositivo o per altri utenti.
backend_updated = characterizer.update_backend()
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
Confronta le proprietà misurate con quelle riportate
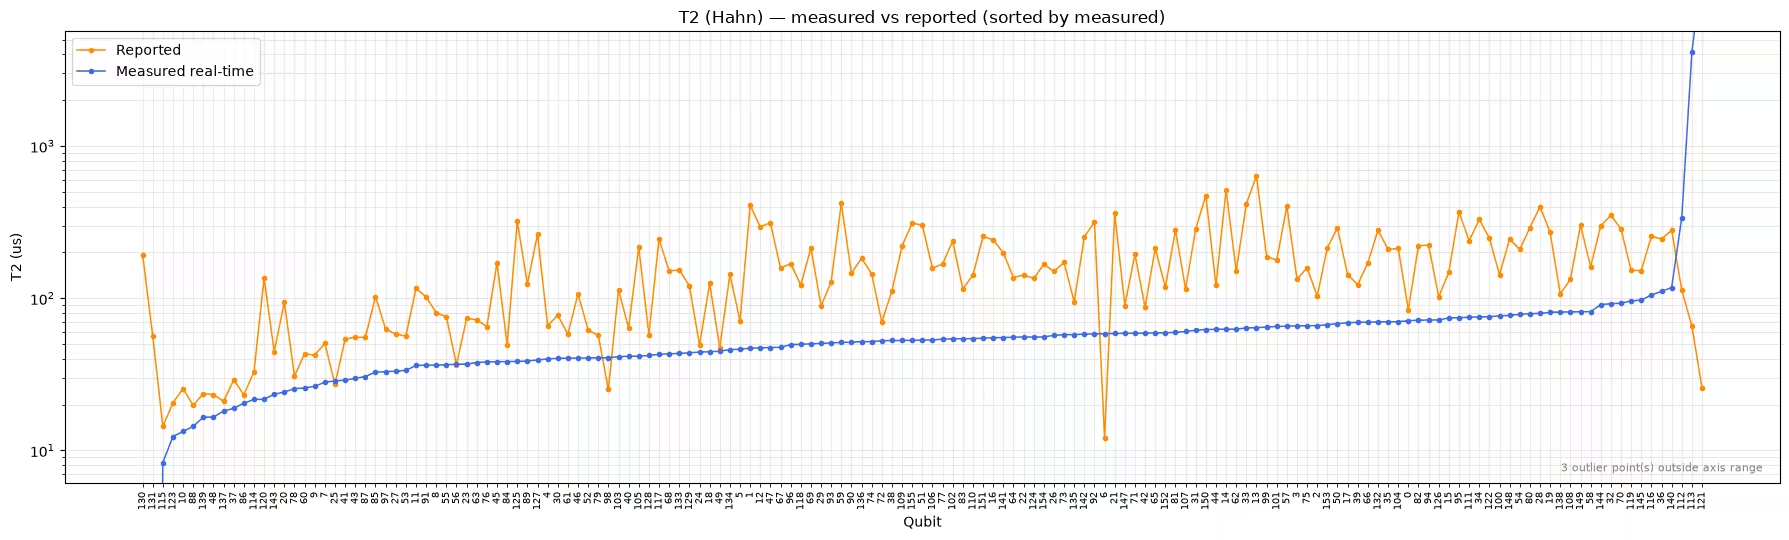
Infine, traccia le proprietà misurate in tempo reale rispetto ai valori riportati dal backend. In ciascun pannello i qubit (o le coppie di qubit) sono ordinati per valore misurato, quindi la curva misurata è liscia per costruzione e la dispersione dei valori riportati attorno ad essa mostra dove i due sono in disaccordo. Viene mostrato un unico grafico per il RB a singolo qubit perché lo stesso errore misurato per gate viene assegnato sia al gate x che al gate sx. I limiti degli assi sono scelti in base alla maggior parte dei dati in modo che pochi valori estremi anomali non comprimano i grafici; eventuali punti al di fuori dell'intervallo sono conteggiati in un'annotazione sul grafico (oppure passa ylim per sovrascrivere i limiti).
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated.properties().to_dict(),
    plots=["readout", "rb_1q", "rb_2q", "t1", "t2"],
)
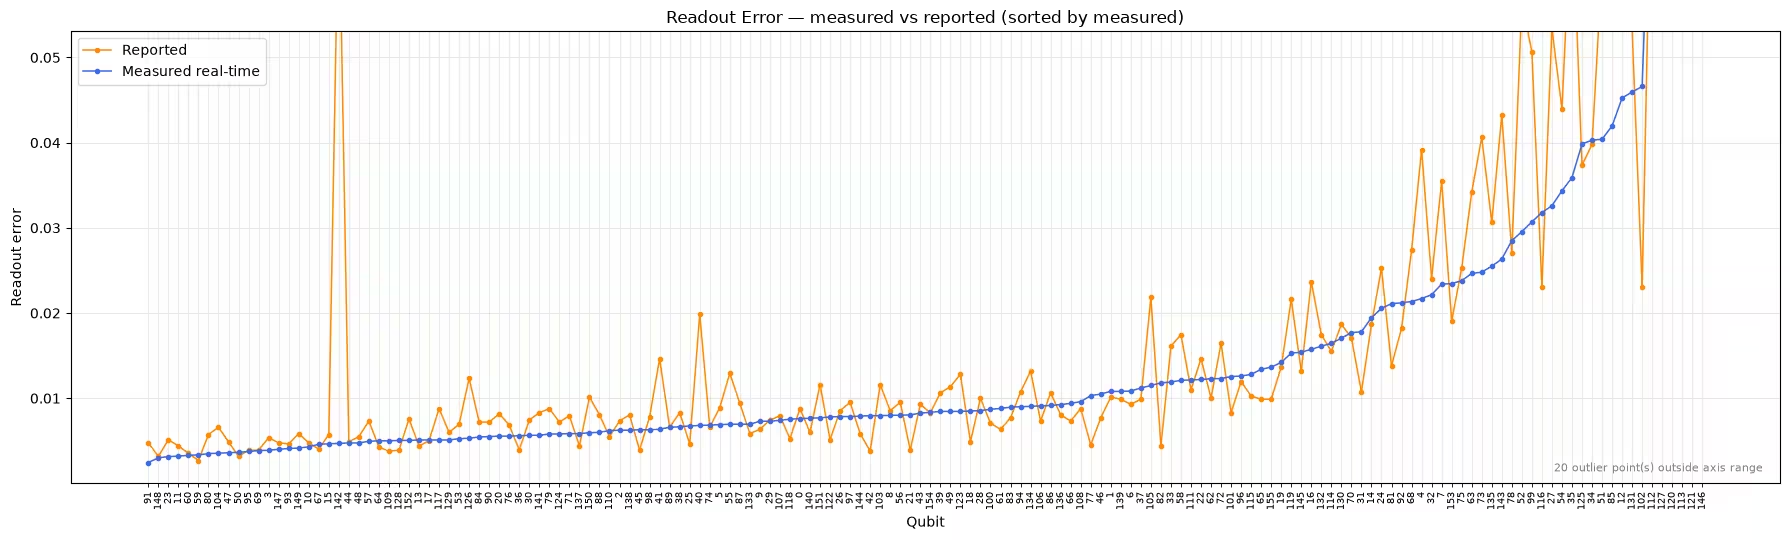
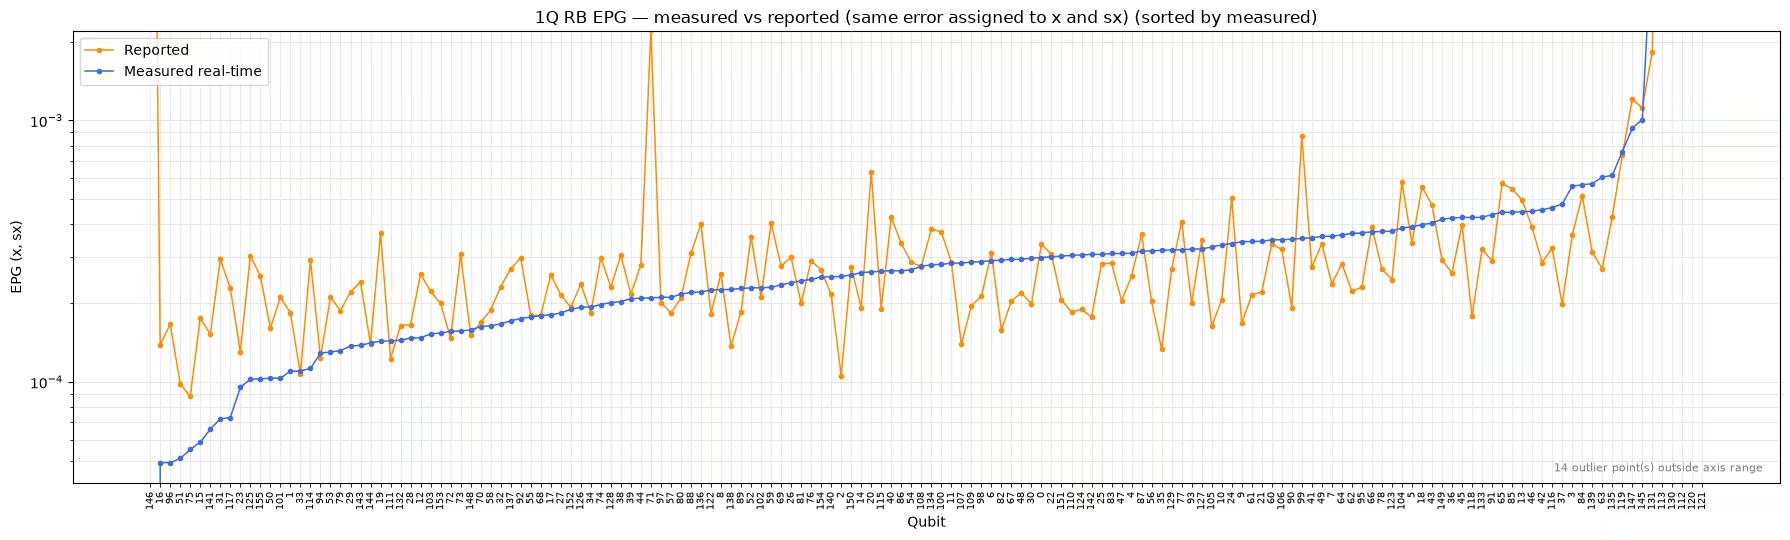
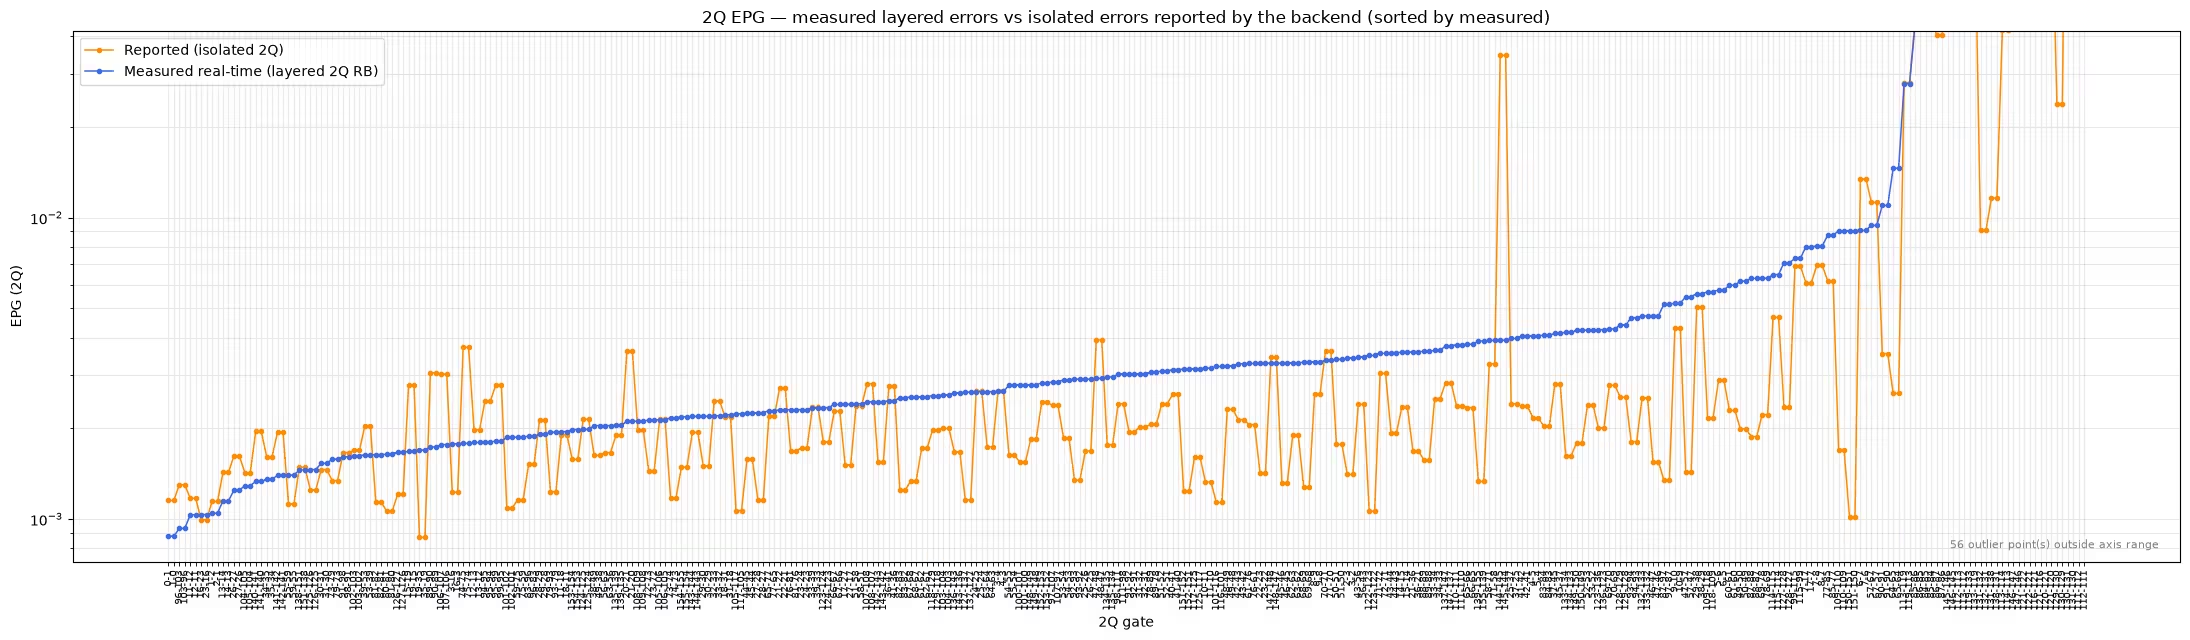
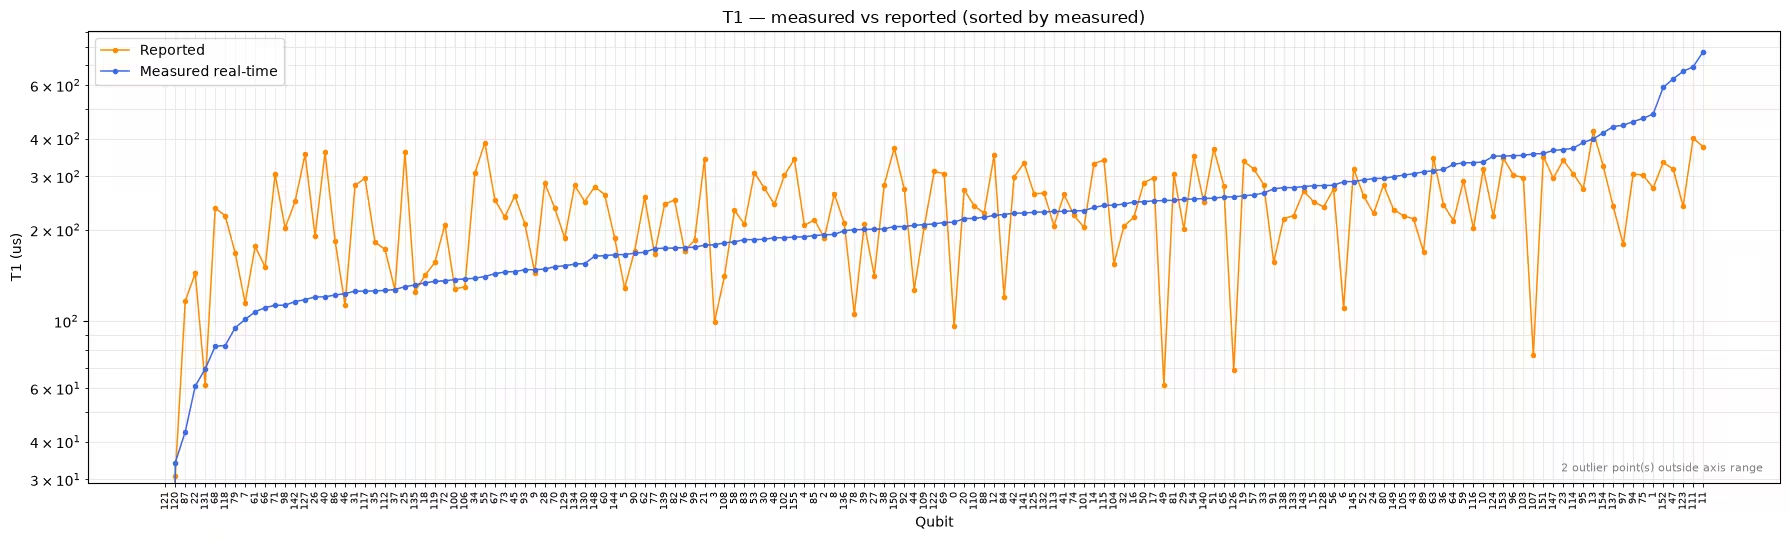
Questi grafici richiedono una lettura attenta, perché non ogni divario tra le due curve significa che il dispositivo ha subito un drift:
-
Errori di lettura e a singolo qubit: I valori misurati seguono quelli riportati per la maggior parte dei qubit, mentre il valore riportato per una manciata di qubit è molto distante dalla curva misurata. Quei disaccordi localizzati sono il drift che questo workflow è progettato per rilevare.
-
: I due insiemi di dati si disperdono l'uno intorno all'altro senza uno scostamento sistematico, il che è coerente con che fluttua naturalmente nel tempo.
-
Errori a due qubit: I valori misurati si collocano sistematicamente al di sopra di quelli riportati. Questo è previsto perché i valori riportati sono misurati su gate isolati, mentre l'esperimento di layer fidelity esegue molti gate simultaneamente e quindi include il crosstalk. I numeri stratificati sono più rilevanti per i circuiti profondi, ma non sono direttamente confrontabili con i dati di calibrazione riportati.
-
: I valori misurati si collocano ben al di sotto di quelli riportati per la maggior parte dei qubit. Anche in questo caso, la metodologia gioca un ruolo importante, come esaminato nella prossima sezione.
Ispeziona i risultati dei singoli esperimenti
Puoi anche ispezionare i risultati grezzi dei singoli esperimenti di caratterizzazione tramite la proprietà experiment_data, che restituisce gli oggetti ExperimentData sottostanti di Qiskit Experiments. Ad esempio, quanto segue visualizza la curva di decadimento misurata di un singolo qubit, il che è utile per verificare la qualità di un fit prima di fidarsi del numero che ha prodotto.
t1_data = characterizer.experiment_data["t1"]

# Each qubit has its own fit figure
n_figs = len(t1_data.figure_names)
print(f"{n_figs} figures available, e.g. {t1_data.figure_names[0]}")

# Show the T1 decay curve of the first qubit
t1_data.figure(0)
156 figures available, e.g. T1_Q0_c78ef792.svg

Misura T2 con un treno di dynamical decoupling
Per impostazione predefinita l'esperimento applica un singolo eco di Hahn e misura tutti i qubit in parallelo, il che, come mostrato dal grafico di confronto sopra, può produrre valori di notevolmente più bassi rispetto a quelli riportati dal backend. Un'ipotesi riguarda il numero di echi: i valori riportati potrebbero essere calibrati con il dynamical decoupling, che sopprime il rumore a bassa frequenza. Per verificarlo, esegui una caratterizzazione solo con t2_num_echoes impostato su un valore più grande, il che applica un treno di impulsi di eco in stile CPMG. I ritardi rappresentano il tempo totale di evoluzione libera in entrambi i casi, quindi i valori adattati sono direttamente confrontabili con i risultati a singolo eco.
# Run a T2-only characterization using a CPMG-style train of 8 echoes
characterizer_dd = BackendCharacterization(backend)
backend_updated_dd = characterizer_dd.run_and_update(
    experiments=["t2"], t2_num_echoes=8
)
Building T2 experiments
T2 (Hahn) experiment submitted: ['d9b96s6g26ic73dflcn0']
Updating T2
# Compare the multi-echo T2 against the backend-reported values
plot_characterization_comparison(
    old_props=backend.properties().to_dict(),
    new_props=backend_updated_dd.properties().to_dict(),
    plots=["t2"],
    title_prefix="8-echo CPMG",
)

# Compare medians across the reported values, the single-echo run,
# and the 8-echo run
reported_t2s = [
    prop["value"]
    for qubit in backend.properties().to_dict()["qubits"]
    for prop in qubit
    if prop["name"] == "T2"
]
t2_reported = np.median(reported_t2s)
t2_single = np.median(list(error_maps["t2_map"].values())) * 1e6
t2_dd = (
    np.median(list(characterizer_dd.analyze_results()["t2_map"].values()))
    * 1e6
)
print(
    f"Median T2 — reported: {t2_reported:.0f} us | "
    f"single echo: {t2_single:.0f} us | 8-echo CPMG: {t2_dd:.0f} us"
)
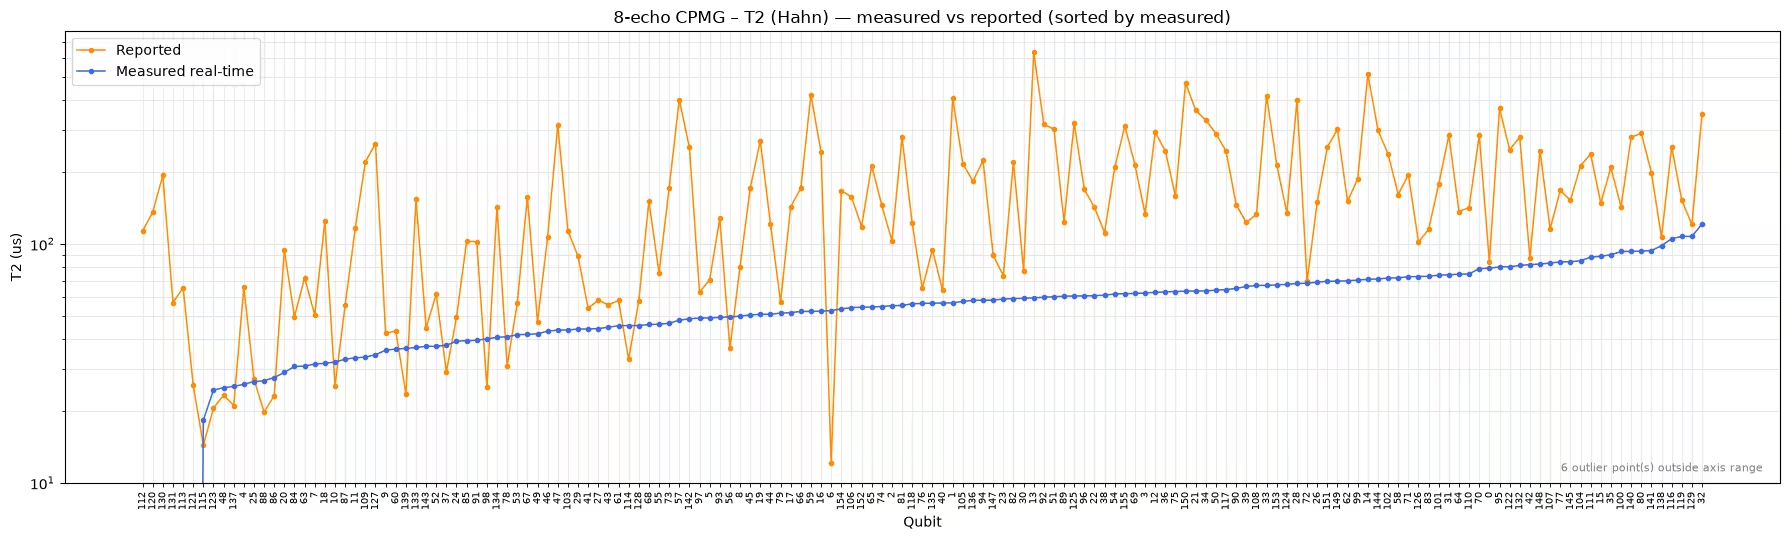
Median T2 — reported: 142 us | single echo: 53 us | 8-echo CPMG: 56 us
In questa esecuzione gli echi aggiuntivi hanno modificato di poco il risultato: la mediana a 8 echi (56 µs) è vicina a quella a singolo eco (53 µs), ed entrambe rimangono ben al di sotto della mediana riportata (142 µs). Il numero di echi da solo non spiega questo divario; sono coinvolte altre differenze metodologiche, come i dettagli della procedura di calibrazione, la misurazione di tutti i qubit in parallelo anziché in isolamento, e così via.
La lezione pratica è trattare i confronti di (e degli errori a due qubit stratificati) tra metodologie con cautela. I valori aggiornati sono un'istantanea autoconsistente presa in condizioni vicine a un carico di lavoro reale, il che li rende adatti per confrontare i qubit tra loro o tracciare un dispositivo nel tempo. Un divario rispetto ai dati di calibrazione riportati, tuttavia, non è automaticamente prova di drift.
Passi 1–4 compressi in un'unica chiamata
Per l'uso quotidiano raramente hai bisogno dei risultati intermedi. Il metodo run_and_update concatena tutto ciò che hai fatto sopra (costruzione, invio, fit e aggiornamento) in un'unica chiamata che restituisce il backend aggiornato. Accetta lo stesso elenco experiments (e inoltra opzioni come t2_num_echoes), e può allo stesso modo essere racchiuso in un contesto Batch o Session.
L'esecuzione della cella seguente termina solo quando tutti i job e il post-processing sono completati.
# Initialize a fresh characterizer
characterizer = BackendCharacterization(backend)

# Run all of the experiments and update the backend in a single call
backend_updated = characterizer.run_and_update(experiments=experiments)
Building readout experiments
Building 1Q RB experiments
Building 2Q RB experiments
Building T1 experiments
Building T2 experiments
Layered two-qubit RB submitted: ['d9b7oqnu62qs738otat0', 'd9b7p76g26ic73dfjolg', 'd9b7pnm6hjac73ffb57g', 'd9b7q4fu62qs738otce0']
Readout job submitted: d9b7q4mg26ic73dfjprg
T1 experiment submitted: ['d9b7q57u62qs738otcfg']
T2 (Hahn) experiment submitted: ['d9b7q5m6hjac73ffb5pg']
Single-qubit RB submitted: ['d9b7r4e6hjac73ffb71g', 'd9b7reu6hjac73ffb7d0']
Updating readout error
Updating single-qubit X error
Updating single-qubit SX error
Updating two-qubit error
Updating T1
Updating T2
L'oggetto backend_updated aggiornato è ora pronto per essere usato ovunque le proprietà del backend alimentino il tuo workflow. Prova questo processo insieme al tutorial Real-time benchmarking for qubit selection per scegliere i qubit con le migliori prestazioni durante la transpilazione di un circuito. Poiché il dispositivo continua a subire drift, aggiorna le proprietà vicino al momento in cui esegui effettivamente il tuo carico di lavoro.
Prossimi passi
Se hai trovato interessante questo lavoro, potrebbero interessarti i seguenti materiali:
- Usa le proprietà aggiornate per scegliere qubit migliori nel tutorial Real-time benchmarking for qubit selection
- Scopri come i dati di calibrazione riportati vengono esposti nella guida QPU information
- Esplora i singoli esperimenti di caratterizzazione nella documentazione di Qiskit Experiments
- Sfoglia ulteriori benchmark a livello di dispositivo nel repository Qiskit Device Benchmarking