Impara stati quantistici rumorosi con le classical shadow
Stima di utilizzo: 34 minuti su un processore Heron r2 (NOTA: si tratta solo di una stima. Il tuo tempo di esecuzione potrebbe variare.)
Obiettivi di apprendimento
-
Raccogliere misure randomizzate su un processore quantistico IBM® da Julia e salvarle per un'analisi successiva
-
Controllare i dati di misura alla ricerca di qubit e gate difettosi prima dell'apprendimento
-
Adattare alle classical shadow un modello a matrix product operator (MPO) di uno stato rumoroso
-
Validare il modello su misure escluse dall'addestramento e confrontarlo con il circuito ideale
Prerequisiti
-
Le classical shadow, come introdotte nel tutorial Shadow tomography dello stato di Greenberger-Horne-Zeilinger (GHZ)
-
Matrici densità e stati misti, trattati in Basics of quantum information
-
Esecuzione di circuiti da Julia con
Qiskit.jleQiskitIBMRuntime.jl, introdotta nel tutorial Simulare l'evoluzione temporale del modello di Ising a campo trasverso
Contesto
Su un processore quantistico reale, il rumore trasforma lo stato puro che un circuito è progettato per preparare in uno stato misto . La tomografia completa dello stato quantistico può ricostruire , ma il numero di misure necessarie cresce esponenzialmente con il numero di qubit. Votto et al. [1] hanno invece appreso da misure randomizzate un modello compatto di fino a 96 qubit. Questo tutorial segue il loro workflow.
In una misura randomizzata [2], ogni qubit viene ruotato da un'unitaria casuale indipendente e poi misurato nella base computazionale. Un'estrazione delle rotazioni è chiamata impostazione di misura, e ogni impostazione viene ripetuta per shot. Uno shot con bit di esito fornisce la classical shadow [3]
la cui media su impostazioni e shot è . Il tutorial prerequisito estrae ogni dalle tre basi di Pauli; questo tutorial, come l'articolo, le estrae uniformemente da tutte le unitarie a singolo qubit (Haar random), e vale la stessa formula.
Le shadow stimano le proprietà di pochi qubit alla volta. L'articolo le combina in un matrix product operator (MPO), che scrive la matrice densità come una catena di piccoli tensori, uno per qubit; gli stati rumorosi con correlazioni a corto raggio richiedono solo piccoli legami tra tensori vicini. Come l'algoritmo del gruppo di rinormalizzazione della matrice densità (DMRG), il learner percorre la catena e aggiorna un tensore alla volta, in modo che il modello corrisponda alle shadow sulla finestra di qubit centrata su quel tensore (Equazione 4 dell'articolo). La dimensione del legame rimane fissa durante questi aggiornamenti, quindi il learner non tronca mai il modello. Poiché i dati entrano solo tramite queste finestre, il numero di impostazioni necessarie non cresce con la lunghezza della catena.
Le impostazioni sono suddivise in un insieme di addestramento e un insieme di test. Sull'insieme di test, l'articolo stima la fedeltà massima tra e il modello ,
Misurare direttamente richiederebbe un numero esponenziale di misure. L'articolo assume invece la condizione di fattorizzazione approssimata (AFC): le correlazioni in decadono entro pochi qubit, quindi sovrapposizioni e purezze globali si fattorizzano in termini su blocchi di qubit vicini. La purezza fornisce anche l'entropia di Rényi-2 , che misura quanto lo stato sia misto.
L'articolo prepara lo stato kicked-Ising di profondità
su 96 qubit di ibm_brisbane, un processore Eagle, con 2.048 impostazioni da 1.024 shot per . La Figura 1(c,d) dell'articolo riporta due risultati per :
-
Il modello appreso raggiunge con lo stato sperimentale a , molto al di sopra della sovrapposizione dello stato ideale con l'esperimento.
-
L'entropia cresce linearmente, , e l'entropia del modello concorda con una stima indipendente dall'insieme di test.
Questo tutorial verifica entrambi i risultati, prima in una simulazione a otto qubit in cui le risposte esatte sono note, e poi in una nuova esecuzione a 96 qubit su ibm_fez, un processore Heron r2. Il learner è un'implementazione Julia indipendente delle equazioni dell'articolo e del suo supplemento.
Requisiti
Questo tutorial richiede macOS o Linux, perché Qiskit.jl non supporta ancora Windows (Qiskit.jl issue #15). Ti serve anche quanto segue:
-
Julia 1.11, dalla pagina di download di Julia o con
juliaup add 1.11, e il pacchettoIJulia:julia -e 'using Pkg; Pkg.add("IJulia")' -
Per l'esempio su hardware, un account IBM Quantum® Platform con accesso a una QPU con almeno 96 qubit e credenziali salvate. Senza un account, puoi eseguire l'esempio su hardware dalle misure salvate dell'esecuzione su
ibm_fezche ha prodotto i risultati di questo tutorial. Le altre sezioni funzionano senza un account.
Il notebook usa Qiskit.jl e QiskitIBMRuntime.jl per costruire ed eseguire circuiti, RandomMeas.jl [4] per le misure randomizzate (fornisce anche ITensors.jl e ITensorMPS.jl), e NPZ.jl, JSON.jl e Plots.jl. Questo tutorial è testato con Qiskit.jl 0.6.1, QiskitIBMRuntime.jl 0.3.2 e RandomMeas.jl 0.3.1.
Ci sono due modi per configurare l'ambiente:
-
Opzione 1: Installa le ultime versioni compatibili dei pacchetti in un ambiente temporaneo. Esegui la cella seguente senza modifiche.
-
Opzione 2: Riproduci esattamente l'ambiente testato. Imposta
download_toml_files = truenella cella seguente. La cella scaricaProject.tomleManifest.tomldal repository della documentazione in una cartellaenv_tutorial/classical-shadows/accanto a questo notebook, quindi installa l'esatta versione di ogni pacchetto registrata nel manifest, comprese le dipendenze indirette. Per i dettagli, consulta la documentazione di Julia su questi file.
using Pkg
using Downloads

download_toml_files = false

if !download_toml_files
    # Option 1: Install the latest compatible versions into a temporary environment
    Pkg.activate(mktempdir(); io=devnull)
    Pkg.add([
        PackageSpec(name="Qiskit", version="0.6"),
        PackageSpec(name="QiskitIBMRuntime", version="0.3"),
        PackageSpec(name="RandomMeas", version="0.3"),
        PackageSpec(name="NPZ"),
        PackageSpec(name="JSON"),
        PackageSpec(name="Plots"),
    ]; io=devnull)
else
    # Option 2: Install the exact tested versions recorded in Project.toml and Manifest.toml
    base_url = "https://raw.githubusercontent.com/Qiskit/documentation/main/docs/tutorials/assets/classical-shadows/julia"
    env_dir = joinpath(@__DIR__, "env_tutorial", "classical-shadows")
    mkpath(env_dir)
    for file in ("Project.toml", "Manifest.toml")
        Downloads.download("$base_url/$file", joinpath(env_dir, file))
    end
    Pkg.activate(env_dir; io=devnull)
    Pkg.instantiate(; io=devnull)
end
Configurazione
using RandomMeas  # also loads ITensors and ITensorMPS
using Qiskit, QiskitIBMRuntime
using Random, LinearAlgebra, Statistics
using Downloads, SHA, NPZ, JSON, Plots

# Download the helper module that implements the learner, unless a copy exists
docs_url = "https://raw.githubusercontent.com/Qiskit/documentation/main"
helper_file = joinpath(@__DIR__, "env_tutorial", "classical-shadows", "mpo_learning.jl")
if !isfile(helper_file)
    mkpath(dirname(helper_file))
    helper_url = "$docs_url/docs/tutorials/assets/classical-shadows/julia/mpo_learning.jl"
    Downloads.download(helper_url, helper_file)
end
include(helper_file)
using .ShadowMPOLearning
BLAS.set_num_threads(1)  # the learner multiplies many small matrices
Il modulo di supporto mpo_learning.jl, che la cella di configurazione scarica, implementa il learner. Il tutorial ne richiama le seguenti funzioni:
| Funzione | Scopo |
|---|---|
kicked_ising_reference(N, D; depolarization) | MPO esatto dello stato kicked-Ising ideale, o dello stato dopo rumore depolarizzante locale |
split_settings(group; seed, train_fraction) | Assegna casualmente le impostazioni di misura agli insiemi di addestramento e di test (metà ciascuno per impostazione predefinita) |
training_marginals(train; ell, prior) | Stime shadow di ogni finestra di apprendimento, solo dalle impostazioni di addestramento |
fitted_prior(ideal, train) | Prior per le misure randomizzate comuni (CRM), adattato alla purezza misurata di ogni finestra, come nell'articolo |
learn_mpo(marginals, N; ell, maxbond, sweeps) | Percorre la catena con l'aggiornamento a un sito dell'articolo, partendo dallo stato massimamente misto |
max_fidelity(a, b), mpo_overlap(a, b) | esatta e tra due MPO |
afc_estimate, afc_statistics, afc_prefix_curve | Stime AFC di e dalle impostazioni di test, con barre di errore jackknife |
Il learner memorizza l'MPO nella base di Pauli. Questo mantiene il modello hermitiano con traccia unitaria, ma non lo costringe a essere semidefinito positivo, quindi il notebook riporta quanto diventano negativi i suoi autovalori.
Esempio su simulatore in piccola scala
Parti da un sistema abbastanza piccolo da calcolare tutto esattamente: lo stato kicked-Ising di profondità uno su otto qubit, con rumore depolarizzante locale del 12% per modellare l'hardware. Poiché lo stato rumoroso è noto, puoi confrontare direttamente il modello appreso con esso.
Passo 1: Mappare gli input classici su un problema quantistico
La funzione kicked_ising_reference restituisce lo stato esatto come MPO. Con depolarization=0.12, il vettore di Bloch di ogni qubit si riduce del 12% dopo il circuito.
N = 8
ideal = kicked_ising_reference(N, 1)
rho = kicked_ising_reference(N, 1; depolarization=0.12)
println("Purity of the noisy state: ", round(mpo_overlap(rho, rho), digits=3))
println("F_max between the noisy and ideal states: ", round(max_fidelity(rho, ideal), digits=3))
Purity of the noisy state: 0.327
F_max between the noisy and ideal states: 0.56
Passo 2: Ottimizzare il problema per l'esecuzione su hardware quantistico
Questo esempio campiona classicamente gli esiti di misura, quindi non c'è alcun circuito da transpilare. L'esempio su hardware tratta questo passo.
Passo 3: Eseguire usando le primitive Qiskit
Usa RandomMeas.jl per estrarre 2.048 impostazioni di misura Haar-random e campionare 256 shot da ciascuna, poi dividi le impostazioni in parti uguali tra insiemi di addestramento e di test. Dividi per impostazione anziché per shot: gli shot della stessa impostazione condividono le sue rotazioni, quindi non sono indipendenti.
Random.seed!(20260921)
sites = siteinds("Qubit", N)
settings = [LocalUnitaryMeasurementSetting(N; site_indices=sites, ensemble=Haar) for _ in 1:2048]
measurements = MeasurementGroup(to_itensor_mpo(rho, sites), settings, 256)
split = split_settings(measurements; seed=20260921)
println(length(split.train_ids), " training settings, ", length(split.test_ids), " testing settings")
1024 training settings,
1024 testing settings
Passo 4: Post-elaborare e restituire il risultato nel formato classico desiderato
Apprendi il modello con i parametri di profondità uno dell'articolo: finestre che si estendono di qubit su ciascun lato del tensore aggiornato, una dimensione di legame pari a 4 e 20 sweep a partire dallo stato massimamente misto. Il primo sweep aggiorna coppie di tensori vicini, il che permette alla dimensione di legame di crescere da 1 a 4; ogni sweep successivo aggiorna un tensore alla volta con quella dimensione di legame fissa.
Per ridurre il rumore statistico delle shadow, l'articolo usa le misure randomizzate comuni (CRM) [5]. Per ogni impostazione, sottrae la shadow media che una stima a priori dello stato produrrebbe nella stessa impostazione, e poi aggiunge di nuovo il valore esatto del prior. La correzione ha media zero, quindi il prior cambia la dimensione dell'errore statistico ma non ciò che viene stimato. Qui il prior è lo stato ideale con il 10% di depolarizzazione locale, vicino al vero 12%. Su hardware il livello di rumore è sconosciuto, quindi l'esempio su hardware adatta invece il prior alle purezze misurate, come fa l'articolo.
prior = kicked_ising_reference(N, 1; depolarization=0.10)
marginals = training_marginals(split.train; ell=2, prior)
fit = learn_mpo(marginals, N; ell=2, maxbond=4, sweeps=20)
sigma = fit.model
plot([h.sweep for h in fit.history], [h.local_loss for h in fit.history];
    xlabel="sweep", ylabel="mean squared residual", label="training windows",
    size=(680, 320), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
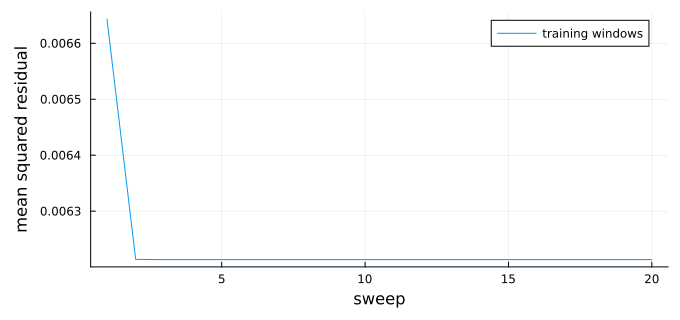
Il residuo misura quanto le finestre del modello siano lontane dalle shadow di addestramento. Diminuisce quando iniziano gli aggiornamenti a un sito, nel secondo sweep, e poi resta approssimativamente costante anziché raggiungere zero, perché le shadow contengono rumore statistico che un modello con una piccola dimensione di legame non può riprodurre.
Poiché questo stato è noto, puoi confrontare esattamente il modello appreso con esso, e confrontare con esso anche le due ipotesi più semplici: il prior CRM e lo stato ideale.
eigenvalues = eigvals(Hermitian(dense_operator(sigma)))
println("F_max with the noisy state")
println("  learned model: ", round(max_fidelity(rho, sigma), digits=3))
println("  CRM prior:     ", round(max_fidelity(rho, prior), digits=3))
println("  ideal state:   ", round(max_fidelity(rho, ideal), digits=3))
println("Most negative eigenvalue of the model: ", round(minimum(eigenvalues), digits=4))
println("Total negative eigenvalue weight:      ", round(-sum(min.(eigenvalues, 0)), digits=4))
F_max with the noisy state
learned model: 0.993
  CRM prior:     0.911
  ideal state:   0.56
Most negative eigenvalue of the model: -0.0076
Total negative eigenvalue weight:      0.0348
Il modello appreso è più vicino allo stato rumoroso sia del prior sia dello stato ideale, quindi ha appreso il rumore dai dati. I suoi piccoli autovalori negativi derivano dal numero finito di misure.
Su hardware lo stato è sconosciuto, quindi stimi invece dalle impostazioni di test. L'AFC divide la catena in blocchi di qubit e approssima la purezza con
e con lo stesso rapporto di sovrapposizioni locali. Con , i due blocchi coprono tutti gli otto qubit e la formula è esatta; con , si basa sull'assunzione di fattorizzazione. Le barre di errore jackknife, che escludono un'impostazione di test alla volta, coprono solo l'errore statistico dei dati di test, non la casualità dell'addestramento né l'approssimazione AFC.
for k in (2, 4)
    estimate = afc_estimate(sigma, split.test; k, statistics=afc_statistics(split.test, k; prior))
    println("k = $k: held-out F_max = ", round(estimate.fidelity, digits=3), " ± ",
        round(estimate.fidelity_sem, digits=3))
end
println("Exact F_max:              ", round(max_fidelity(rho, sigma), digits=3))
k = 2: held-out F_max = 0.966
± 0.036
k = 4: held-out F_max =
0.958 ± 0.049
Exact F_max:              0.993
Entrambe le stime sui dati esclusi concordano con il valore esatto entro le loro barre di errore.
Esempio su hardware in larga scala
Ora esegui l'esperimento su una catena di 96 qubit di ibm_fez, un processore Heron r2. Come ibm_brisbane, ha una mappa di accoppiamento heavy-hex e un livello di rumore simile.
La raccolta dei dati richiede 1.024 job Sampler e circa 34 minuti di tempo QPU. Se non hai accesso a una QPU con almeno 96 qubit, o la coda è lunga, esegui l'esempio su hardware dalle misure registrate su ibm_fez il 27 settembre 2026, che hanno prodotto i risultati mostrati in questo tutorial. Con use_saved_data = true, il notebook scarica queste misure (15 MB) da Zenodo [6] nel Passo 1 e salta l'invio dei job nel Passo 3. Per raccogliere i tuoi dati, impostalo su false.
use_saved_data = true; # set to false to collect new measurements on hardware
Passo 1: Mappare gli input classici su un problema quantistico
Ogni impostazione richiede un circuito: il circuito di Ising con kick, un gate su ogni qubit per e una misura di ogni qubit. Campionando , con , e uniformi in , risulta Haar casuale. La funzione u3_matrix restituisce la matrice di , che il Passaggio 4 utilizza.
Il budget è di 1.024 impostazioni da 1.024 shot, la metà del numero di impostazioni dell'articolo, suddivise in parti uguali tra addestramento e test. Con i dati salvati, la cella carica gli angoli registrati. Altrimenti, estrae nuovi angoli e li salva prima che tu invii qualsiasi cosa, perché senza di essi non puoi analizzare i risultati. Se il file esiste già, la cella lo carica, in modo che gli angoli corrispondano ancora ai risultati salvati dopo il riavvio della sessione.
"Matrix of the U(θ, ϕ, λ) gate, as used by `qc.u` in Qiskit."
u3_matrix(θ, ϕ, λ) = [cos(θ/2)              -exp(im*λ)*sin(θ/2);
                      exp(im*ϕ)*sin(θ/2)    exp(im*(ϕ + λ))*cos(θ/2)]

"Angles (θ, ϕ, λ) for which `u3_matrix(θ, ϕ, λ)` is a Haar-random unitary."
random_u3_angles() = (2asin(sqrt(rand())), 2π*rand(), 2π*rand())

N_hw, NU_hw, NM_hw = 96, 1024, 1024
data_directory = joinpath(@__DIR__, "classical-shadows-data")
saved_file = joinpath(data_directory, "ibm-fez-run.npz")
run_directory = joinpath(data_directory, "new-run")
settings_file = joinpath(run_directory, "settings.npz")
if use_saved_data
    saved_url = "https://zenodo.org/records/24116174/files/ibm-fez-run.npz?download=1"
    saved_sha256 = "c42f4d8d42e5083e9e152b4fec0846884ebe3be003e5ab528deebf4f00c9fe50"
    if !isfile(saved_file)
        mkpath(data_directory)
        println("Downloading the saved ibm_fez run (15 MB)...")
        Downloads.download(saved_url, saved_file * ".part")
        mv(saved_file * ".part", saved_file)
    end
    bytes2hex(open(sha256, saved_file)) == saved_sha256 ||
        error("$saved_file is incomplete or corrupted; delete it and run this cell again")
    saved_run = npzread(saved_file)
    angles = saved_run["angles"]
elseif isfile(settings_file)
    angles = npzread(settings_file)["angles"]
else
    mkpath(joinpath(run_directory, "outcomes"))
    Random.seed!(20260927)
    angles = Array{Float64}(undef, NU_hw, N_hw, 3)
    for r in 1:NU_hw, i in 1:N_hw
        angles[r, i, :] .= random_u3_angles()
    end
    npzwrite(settings_file, Dict("angles" => angles))
end
println("Measurement settings: ", size(angles, 1), " × ", size(angles, 2), " qubits")
Measurement settings: 1024
× 96 qubits
Passaggio 2: ottimizzare il problema per l'esecuzione su hardware quantistico
Una catena vale quanto il suo qubit peggiore, quindi scegli tu stesso i 96 qubit fisici. La funzione transpile di Qiskit.jl non può ancora accettare un layout iniziale fisso e, in un test su ibm_phoenix, il layout che ha scelto includeva un qubit con il 51% di errore di lettura. La catena seguente è il percorso di 96 qubit nella mappa di accoppiamento di ibm_fez che il layout consapevole degli errori della funzione transpile di Qiskit Python (con optimization_level=3) ha selezionato dai dati di calibrazione del 27 settembre 2026. Il suo errore di lettura medio è dell'1,6%, ma un reticolo heavy-hex ha pochi percorsi di 96 qubit e questo include il qubit 35, che ha un errore di lettura del 15%. Le calibrazioni cambiano, quindi scegli una nuova catena dai dati di calibrazione attuali prima di eseguire in un altro giorno o su un'altra QPU.
Per mantenere questa catena, scrivi i circuiti direttamente in gate nativi invece di transpilarli. Un gate equivale a a meno di una fase globale. Questa decomposizione copre sia le rotazioni casuali sia il kick . Il gate equivale a un gate CZ seguito da su entrambi i qubit, a meno di una fase globale. Poiché questi gate sono diagonali, commutano con i gate CZ, quindi ogni qubit accumula un per legame prima della sua rotazione di misura.
num_device_qubits = 156
# Physical qubits of ibm_fez, in IBM numbering, forming the chain
chain_physical = [
    2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 19, 35, 34, 33, 39, 53, 54, 55, 59, 75, 74,
    73, 79, 93, 94, 95, 99, 115, 114, 113, 119, 133, 132, 131, 130, 129, 128, 127, 137, 147, 146,
    145, 144, 143, 136, 123, 124, 125, 117, 105, 106, 107, 108, 109, 110, 111, 98, 91, 90, 89,
    88, 87, 86, 85, 77, 65, 66, 67, 68, 69, 70, 71, 58, 51, 50, 49, 48, 47, 46, 45, 37, 25, 24,
    23, 22, 21, 36, 41, 42, 43, 56, 63]
chain = chain_physical .+ 1  # Qiskit.jl numbers qubits from 1

"Apply U(θ, ϕ, λ) to qubit q with native gates: rz(λ), sx, rz(θ + π), sx, rz(ϕ + π)."
function native_u!(qc, q, θ, ϕ, λ)
    qc.rz(λ, q)
    qc.sx(q)
    qc.rz(θ + π, q)
    qc.sx(q)
    qc.rz(ϕ + π, q)
end

"Kicked-Ising circuit on `chain`, then the rotations of one setting and a measurement."
function native_setting_circuit(chain, angles, num_device_qubits)
    n = length(chain)
    qc = QuantumCircuit(num_device_qubits, n)
    for q in chain
        native_u!(qc, q, π/4, -π/2, π/2)       # e^{-iπ/8 X}
    end
    for i in 1:n-1
        qc.cz(chain[i], chain[i + 1])          # e^{iπ/4 ZZ}, up to the S† gates below
    end
    for (i, q) in enumerate(chain)
        bonds = (i > 1) + (i < n)
        qc.rz(-π/2 * bonds, q)                 # one S† per bond
        native_u!(qc, q, angles[i, 1], angles[i, 2], angles[i, 3])
        qc.measure(q, i)                       # outcome of chain qubit i goes to bit i
    end
    qc
end

circuits = [native_setting_circuit(chain, angles[r, :, :], num_device_qubits) for r in 1:NU_hw]
println(length(circuits), " circuits, each with ", count(inst -> inst.name == "cz", circuits[1].data), " CZ gates")
1024 circuits, each with
95 CZ gates
Passaggio 3: eseguire con le primitive di Qiskit
QiskitIBMRuntime.jl esegue un circuito per ogni job Sampler, quindi la raccolta dei dati richiede 1.024 job. La cella seguente mantiene fino a 32 job in coda e salva i risultati di ogni impostazione non appena il suo job termina. Ogni shot viene restituito come vettore di bit, in cui l'elemento è il risultato del qubit della catena.
Devi recuperare i risultati nella stessa sessione che ha inviato i job, perché QiskitIBMRuntime.jl non può ancora cercare un job tramite il suo ID (qiskit-ibm-runtime-c issue #28). Se un job fallisce, la cella emette un avviso e continua. Se la sessione si interrompe, esegui di nuovo i Passaggi da 1 a 3. Rieseguendo la cella vengono inviate solo le impostazioni di cui mancano i risultati. Con use_saved_data = true, la cella non invia nulla.
outcome_file(r) = joinpath(run_directory, "outcomes", "setting_$(lpad(r, 4, '0')).npz")

"Save the outcomes of setting `r` as a (shots × N) matrix of 0/1 values."
function save_outcomes(r, job)
    try
        samples = get_sampler_job_results(job, service)
        bits = UInt8.(permutedims(reduce(hcat, samples)))
        npzwrite(outcome_file(r), Dict("bits" => bits))
    catch err
        @warn "Setting $r failed and was not saved; run this cell again to resubmit it" err
    end
end

if use_saved_data
    println("Using the saved ibm_fez measurements; no jobs submitted")
else
    backend_name = "ibm_fez"
    service = Service()  # uses the credentials saved on this computer
    backend = only(b for b in backend_search(service) if b.name == backend_name)
    open(joinpath(run_directory, "metadata.json"), "w") do io
        JSON.print(io, Dict("backend" => backend_name, "N" => N_hw, "depth" => 1, "settings" => NU_hw,
                            "shots" => NM_hw, "chain" => chain_physical), 2)
    end
    in_flight = []
    for r in 1:NU_hw
        isfile(outcome_file(r)) && continue
        push!(in_flight, (r, run_sampler_job(service, backend, circuits[r], NM_hw)))
        length(in_flight) >= 32 && save_outcomes(popfirst!(in_flight)...)
    end
    foreach(job -> save_outcomes(job...), in_flight)
    println("Saved outcomes: ", count(r -> isfile(outcome_file(r)), 1:NU_hw), " of ", NU_hw, " settings")
end
Using the saved ibm_fez measurements; no jobs submitted
Passaggio 4: post-elaborare e restituire il risultato nel formato classico desiderato
Questo passaggio legge solo dati salvati: l'esecuzione scaricata di ibm_fez se use_saved_data è true, oppure i file scritti dal Passaggio 3. Puoi quindi eseguirlo in una nuova sessione senza inviare job (esegui prima la cella Setup, la cella use_saved_data e il Passaggio 1). Il file scaricato memorizza i 96 risultati di ogni shot compressi in 12 byte, con il bit più significativo per primo, quindi il loader li decomprime. RandomMeas.jl etichetta i risultati con 1 e 2, quindi il loader aggiunge anche 1 a ogni bit.
"Build a `MeasurementGroup` from the angles and a function `outcomes(r)` that returns
the (shots × N) 0/1 outcomes of setting `r`."
function measurement_group(angles, outcomes)
    settings_count, n = size(angles, 1), size(angles, 2)
    sites = siteinds("Qubit", n)
    data = map(1:settings_count) do r
        rotations = Array{ComplexF64}(undef, n, 2, 2)
        for i in 1:n
            rotations[i, :, :] = u3_matrix(angles[r, i, :]...)
        end
        MeasurementData(Int.(outcomes(r)) .+ 1;
            measurement_setting=LocalUnitaryMeasurementSetting(rotations; site_indices=sites))
    end
    MeasurementGroup(data)
end

if use_saved_data
    packed = saved_run["outcomes"]  # settings × shots × 12 bytes
    # Bit i of a shot is in byte (i - 1) ÷ 8 + 1, most significant bit first
    unpack(r) = [(packed[r, s, (i - 1) ÷ 8 + 1] >> (7 - (i - 1) % 8)) & 0x01
                 for s in 1:size(packed, 2), i in 1:N_hw]
    group_hw = measurement_group(angles, unpack)
else
    group_hw = measurement_group(angles, r -> npzread(outcome_file(r))["bits"])
end
println(group_hw.NU, " settings × ", group_hw.NM, " shots on ", group_hw.N, " qubits")
1024 settings ×
1024 shots on 96 qubits
Prima di apprendere, controlla i dati. Un qubit difettoso o un gate mal calibrato rende lo stato misurato molto più misto intorno ad esso e può far divergere il learner. La purezza di pochi qubit vicini è un benchmark senza modello di questo rumore: la funzione get_purity di RandomMeas.jl stima per un sottosistema confrontando coppie di shot della stessa impostazione. Calcola l'entropia di Rényi-2 di ogni finestra di sei qubit vicini e confrontala con la stessa finestra dello stato ideale. Il valore ideale non è zero, perché ogni finestra è entangled con il resto della catena; il rumore lo aumenta e un qubit difettoso spinge ogni finestra che lo contiene verso il massimo di sei.
ideal_hw = kicked_ising_reference(N_hw, 1)
width = 6
starts = 1:N_hw - width + 1
window_entropy(rho, w) = -log2(mpo_overlap(segment_mpo(rho, w), segment_mpo(rho, w)))
measured_entropy = [-log2(get_purity(group_hw, collect(j:j + width - 1))) for j in starts]
ideal_entropy = [window_entropy(ideal_hw, j:j + width - 1) for j in starts]
worst = argmax(measured_entropy)
println("S₂ of six-qubit windows: median ", round(median(measured_entropy), digits=2), "; highest ",
    round(measured_entropy[worst], digits=2), " (chain positions ", worst, " to ", worst + width - 1, ")")
println("Ideal state: ", round(minimum(ideal_entropy), digits=2), " to ", round(maximum(ideal_entropy), digits=2))
plot(starts, measured_entropy; marker=:circle, markersize=2, label="measured",
    xlabel="first chain position of the window", ylabel="S₂ of six qubits", ylims=(0, width),
    legend=:topright, size=(800, 280), left_margin=5Plots.mm, bottom_margin=5Plots.mm)
plot!(starts, ideal_entropy; linestyle=:dash, label="ideal state")
S₂ of six-qubit windows: median 0.9
; highest 1.43 (chain positions 30 to 35)
Ideal state: 0.19 to 0.39
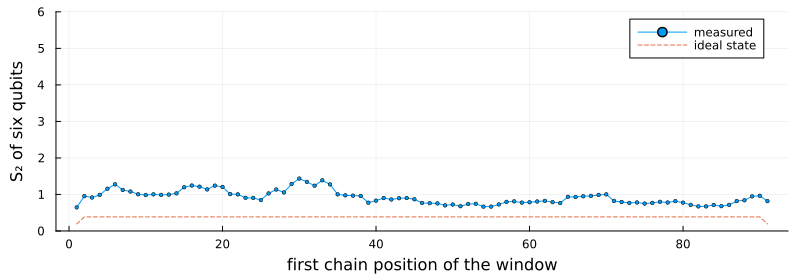
Ogni finestra è più mista dello stato ideale, di circa mezzo bit o un bit, e il tratto più rumoroso si trova intorno alle posizioni 30-35 della catena. Nessuna finestra si avvicina al massimo di sei, quindi nessun qubit è difettoso e l'analisi usa l'intera catena di 96 qubit. Se alcune finestre avessero un'entropia vicina a sei, rimuoveresti il qubit condiviso da quelle finestre e apprenderesti la parte più lunga della catena senza di esso.
Le stesse purezze determinano il prior CRM. Per ogni finestra, fitted_prior prende lo stato ideale e adatta un'intensità di depolarizzazione locale in modo che la sua purezza corrisponda a quella misurata nelle impostazioni di addestramento, come nell'articolo.
La funzione learn_and_validate nella cella seguente esegue il resto dell'analisi. Apprende il modello dalle impostazioni di addestramento, poi stima e sulle impostazioni di test per i primi qubit della catena, a passi di 12. Queste sono le grandezze della Figura 1(c,d) dell'articolo. Lo stato ideale viene valutato sugli stessi dati di test come riferimento.
La cella esegue la funzione con e poi la ripete con e per vedere quanto conta la dimensione delle finestre di apprendimento. La dimensione di legame può essere al massimo , quindi apprende uno stato prodotto: ogni qubit a sé, senza correlazioni tra qubit.
function learn_and_validate(group; ideal, ell=2, k=3, sizes=12:12:group.N, seed=20260921, train_fraction=0.5)
    split = split_settings(group; seed, train_fraction)
    prior = fitted_prior(ideal, split.train)
    marginals = training_marginals(split.train; ell, prior)
    fit = learn_mpo(marginals, group.N; ell, maxbond=min(4, 4^ell), sweeps=20)
    last(fit.history).purity <= 1 ||
        @warn "The model has purity above one, so the fit diverged. Collect more settings or shots."
    statistics = afc_statistics(split.test, k; prior)
    learned = afc_prefix_curve(fit.model, statistics, split.test.NU; k, sizes)
    baseline = afc_prefix_curve(ideal, statistics, split.test.NU; k, sizes)
    model_entropy = [-log2(mpo_overlap(prefix_mpo(fit.model, n), prefix_mpo(fit.model, n))) for n in sizes]
    (; ell, fit, split, learned, baseline, model_entropy)
end

function plot_validation(results, title)
    n = [r.n for r in first(results).learned]
    # Marker, size, and line style per ℓ. The ℓ = 1 squares are small enough to sit inside the
    # ℓ = 2 circles, so both stay visible where the two curves overlap.
    style = Dict(2 => (:circle, 7, :solid), 1 => (:rect, 3.5, :dash), 0 => (:utriangle, 5, :dot))
    fidelity = plot(yscale=:log10, ylims=(1e-6, 1.5), legend=:bottomleft, xlabel="number of qubits N",
        ylabel="held-out F_max", title=title)
    entropy = plot(xlabel="number of qubits N", ylabel="Rényi-2 entropy S₂", legend=:topleft)
    held_out = first(results).learned
    # Draw every error bar before any marker, so the bars stay behind the symbols
    for (color, result) in enumerate(results)
        scatter!(fidelity, n, [r.fidelity for r in result.learned]; yerror=[r.fidelity_sem for r in result.learned],
            markersize=0, markerstrokecolor=color, label="")
    end
    scatter!(entropy, n, [r.entropy for r in held_out]; yerror=[r.entropy_sem for r in held_out],
        markersize=0, markerstrokecolor=:black, label="")
    for (color, result) in enumerate(results)
        marker, markersize, linestyle = style[result.ell]
        label = "learned model, ℓ = $(result.ell)"
        plot!(fidelity, n, [r.fidelity for r in result.learned]; color, marker, markersize, linestyle,
            markerstrokewidth=0, label)
        plot!(entropy, n, result.model_entropy; color, linestyle, linewidth=2, label)
    end
    plot!(fidelity, n, [r.fidelity for r in first(results).baseline]; marker=:diamond, markersize=5,
        linestyle=:dashdot, color=:black, label="ideal state")
    scatter!(entropy, n, [r.entropy for r in held_out]; marker=:circle, markersize=4, color=:black,
        label="held-out AFC estimate")
    plot(fidelity, entropy; layout=(1, 2), size=(1000, 400), left_margin=7Plots.mm, bottom_margin=7Plots.mm)
end

function summarize(result)
    final = last(result.learned)
    println("ℓ = ", result.ell, ", N = ", final.n, ": held-out F_max = ", round(final.fidelity, sigdigits=3), " ± ",
        round(final.fidelity_sem, sigdigits=2), " (ideal state: ", round(last(result.baseline).fidelity, sigdigits=2), ")")
    println("  S₂ = ", round(final.entropy, digits=2), " ± ", round(final.entropy_sem, digits=2),
        " held out; ", round(last(result.model_entropy), digits=2), " from the model")
    lowest = minimum(minimum(eigvals(Hermitian(operator_from_coefficients(local_coefficients(result.fit.model, w)))))
                     for w in unique(learning_windows(final.n, max(result.ell, 1))))
    println("  Most negative eigenvalue in any learning window: ", round(lowest, digits=4))
end

results_hw = [learn_and_validate(group_hw; ideal=ideal_hw, ell) for ell in (2, 1, 0)]
foreach(summarize, results_hw)
plot_validation(results_hw, "ibm_fez, 96-qubit chain")
ℓ = 2
, N = 96: held-out F_max = 0.591 ± 0.1 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.21 from the model
  Most negative eigenvalue in any learning window: -0.0523
ℓ = 1, N = 96: held-out F_max = 0.554 ± 0.094 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 10.26 from the model
  Most negative eigenvalue in any learning window: -0.0215
ℓ = 0, N = 96: held-out F_max = 6.18e-6 ± 1.1e-6 (ideal state: 0.0035)
  S₂ = 10.04 ± 0.28 held out; 32.01 from the model
  Most negative eigenvalue in any learning window: 0.0012
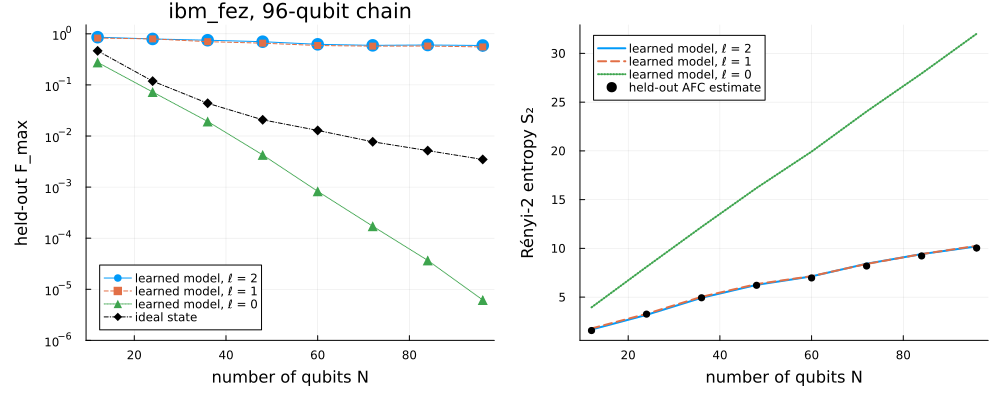
I risultati riproducono entrambe le affermazioni dell'articolo su un processore diverso:
-
Il modello descrive i dati molto meglio dello stato ideale. Con , il fuori campione del modello con è 0,59 ± 0,10, contro 0,0035 dello stato ideale. L'articolo riporta circa 0,75 su
ibm_brisbane. -
L'entropia del modello concorda con i dati di test per ogni . Con , è 10,2 dal modello e 10,0 ± 0,3 dai dati di test, ovvero , contro 0,14-0,15 sul più vecchio
ibm_brisbane.
Il confronto tra le dimensioni delle finestre mostra dove si trova l'informazione. Con , il modello è quasi altrettanto buono (), quindi per questi dati le correlazioni oltre pochi qubit aggiungono poco. Con , lo stato prodotto non coglie l'entanglement tra qubit vicini: la sua entropia cresce fino a 32 invece di 10 e il suo cala ancora più rapidamente di quello dello stato ideale, fino a con .
Tieni presenti le seguenti limitazioni quando leggi questi numeri:
-
Suddivisione di addestramento. Le barre di errore coprono solo l'errore statistico dei dati di test. Altre suddivisioni casuali delle stesse impostazioni danno tra 0,49 e 0,59 con per .
-
Ultimo sweep. Il learner restituisce sempre il modello dell'ultimo sweep, quindi i dati di test non influenzano mai il modello.
-
Positività. Il modello non è vincolato a essere semidefinito positivo; il suo autovalore più negativo in una finestra di apprendimento è circa . Il suo e il suo descrivono quindi un operatore, non proprietà certificate di uno stato fisico.
-
Fattorizzazione. Ogni stima fuori campione si basa sull'assunzione AFC, che le misure stesse non possono certificare.
Prossimi passi
-
Ripeti l'esperimento a profondità due con i parametri dell'articolo per quella profondità ( e una dimensione di legame massima di 8) e determina quante impostazioni di misura servono al learner.
-
Apprendi con l'aggiornamento a due siti (
update=:two_siteintraining_marginalselearn_mpo), che tronca la dimensione di legame dopo ogni passo, e osserva come si comporta con meno impostazioni di addestramento. -
Apprendi senza il prior CRM (
prior=nothing) e confronta la fedeltà fuori campione. -
Applica la stessa analisi alle misure di
ibm_brisbanepubblicate dagli autori. -
Leggi il supplemento dell'articolo per la derivazione dell'aggiornamento e degli stimatori AFC.
-
Esplora altri protocolli di misura randomizzata negli esempi di
RandomMeas.jl.
Riferimenti
-
M. Votto, M. Ljubotina, C. Lancien, J. I. Cirac, P. Zoller, M. Serbyn, L. Piroli, and B. Vermersch, "Learning mixed quantum states in large-scale experiments", Phys. Rev. Lett. 136, 090801 (2026). arXiv:2507.12550
-
A. Elben, S. T. Flammia, H.-Y. Huang, R. Kueng, J. Preskill, B. Vermersch, and P. Zoller, "The randomized measurement toolbox", Nat. Rev. Phys. 5, 9 (2023). arXiv:2203.11374
-
H.-Y. Huang, R. Kueng, and J. Preskill, "Predicting many properties of a quantum system from very few measurements", Nat. Phys. 16, 1050 (2020). arXiv:2002.08953
-
A. Elben and B. Vermersch, "RandomMeas.jl: A Julia package for randomized measurements in quantum devices", Quantum 10, 2086 (2026). arXiv:2509.12749
-
B. Vermersch, A. Rath, B. Sundar, C. Branciard, J. Preskill, and A. Elben, "Enhanced estimation of quantum properties with common randomized measurements", PRX Quantum 5, 010352 (2024). arXiv:2304.12292
-
H. Zou, "Randomized measurements of a 96-qubit kicked-Ising state on ibm_fez", Zenodo (2026). doi:10.5281/zenodo.24116174