Impostare il livello di ottimizzazione del transpiler
Versioni dei pacchetti
Il codice in questa pagina è stato sviluppato utilizzando i seguenti requisiti. Consigliamo di utilizzare queste versioni o versioni più recenti.
qiskit[all]~=2.5.2
qiskit-ibm-runtime~=0.47.0
I dispositivi quantistici reali sono soggetti a rumore ed errori dei Gate, quindi ottimizzare i Circuit per ridurne la profondità e il numero di Gate può migliorare significativamente i risultati ottenuti dall'esecuzione di tali Circuit.
La funzione generate_preset_pass_manager ha un argomento posizionale obbligatorio, optimization_level, che controlla quanto sforzo il Transpiler dedica all'ottimizzazione dei Circuit. Questo argomento può essere un intero che assume uno dei valori 0, 1, 2 o 3.
Livelli di ottimizzazione più alti generano Circuit più ottimizzati a scapito di tempi di compilazione più lunghi.
La tabella seguente spiega le ottimizzazioni eseguite con ciascuna impostazione.
| Livello di ottimizzazione | Descrizione |
|---|---|
| 0 | Nessuna ottimizzazione: tipicamente usato per la caratterizzazione dell'hardware
|
| 1 | Ottimizzazione leggera:
|
| 2 | Ottimizzazione media:
|
| 3 | Ottimizzazione elevata:
|
Il livello di ottimizzazione in azione
Poiché i gate a due qubit sono tipicamente la principale fonte di errori, possiamo quantificare approssimativamente l'"efficienza hardware" della transpilazione contando il numero di gate a due qubit nel circuito risultante. Qui proveremo i diversi livelli di ottimizzazione su un circuito d'ingresso composto da un unitario casuale seguito da un gate SWAP.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.circuit.library import UnitaryGate
from qiskit.quantum_info import Operator, random_unitary

UU = random_unitary(4, seed=12345)
rand_U = UnitaryGate(UU)

qc = QuantumCircuit(2)
qc.append(rand_U, range(2))
qc.swap(0, 1)
qc.draw("mpl", style="iqp")

Il backend mock FakeSherbrooke di qiskit_ibm_runtime viene usato in questi esempi, ma puoi provarlo su qualsiasi backend reale o finto compatibile con Qiskit. I tuoi risultati potrebbero essere diversi.
Prima di tutto, trasponiamo usando il livello di ottimizzazione 0.
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime.fake_provider import FakeSherbrooke

backend = FakeSherbrooke()

pass_manager = generate_preset_pass_manager(
    optimization_level=0, backend=backend, seed_transpiler=12345
)
qc_t1_exact = pass_manager.run(qc)
qc_t1_exact.draw("mpl", idle_wires=False)
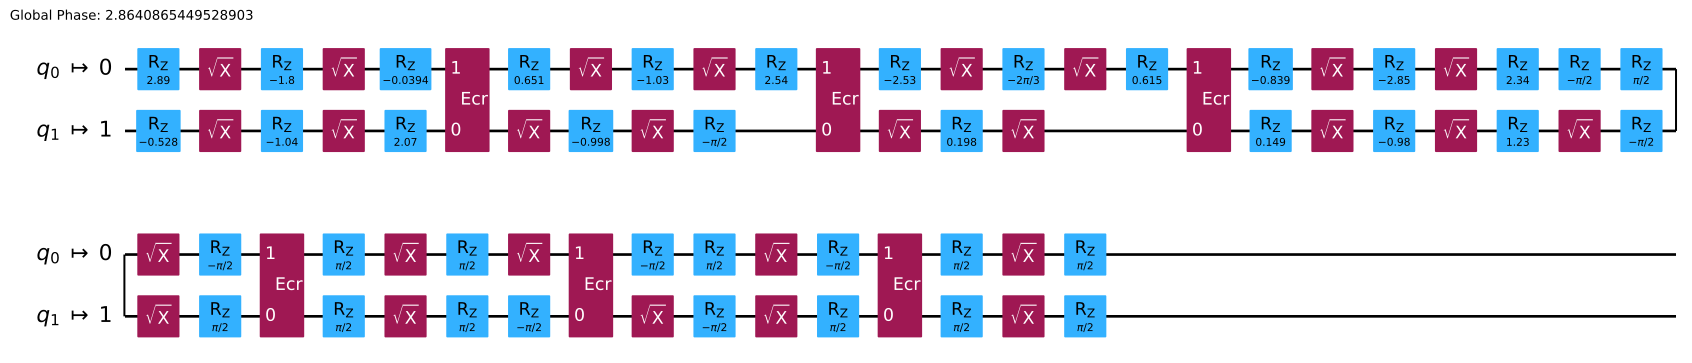
Il circuito transpilato ha sei gate ECR a due qubit.
Ripetiamo per il livello di ottimizzazione 1:
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime.fake_provider import FakeSherbrooke

backend = FakeSherbrooke()

pass_manager = generate_preset_pass_manager(
    optimization_level=1, backend=backend, seed_transpiler=12345
)
qc_t1_exact = pass_manager.run(qc)
qc_t1_exact.draw("mpl", idle_wires=False)
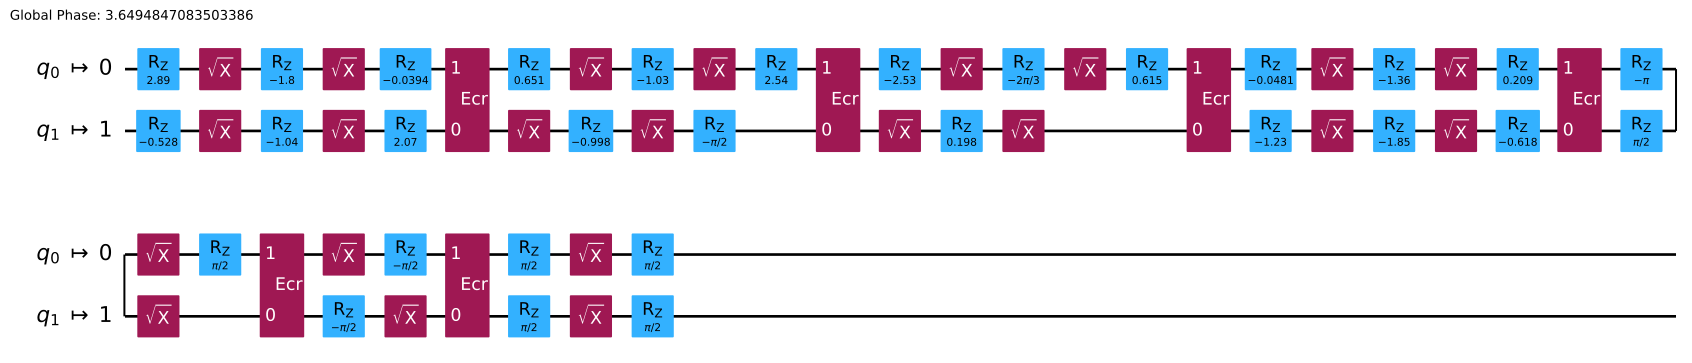
Il circuito transpilato ha ancora sei gate ECR, ma il numero di gate a qubit singolo si è ridotto.
Ripetiamo per il livello di ottimizzazione 2:
pass_manager = generate_preset_pass_manager(
    optimization_level=2, backend=backend, seed_transpiler=12345
)
qc_t2_exact = pass_manager.run(qc)
qc_t2_exact.draw("mpl", idle_wires=False)
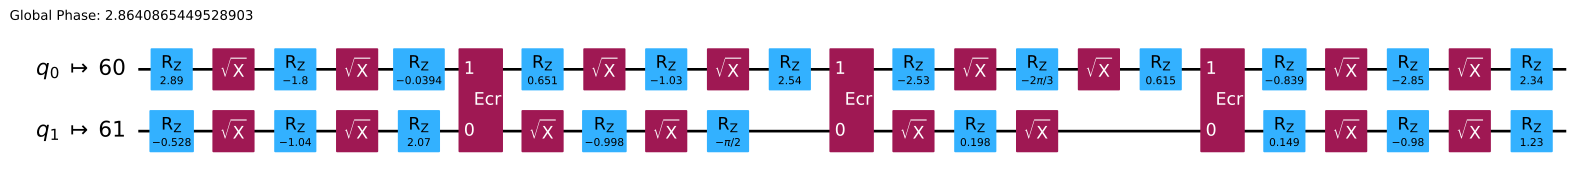
Questo produce gli stessi risultati del livello di ottimizzazione 1. Nota che aumentare il livello di ottimizzazione non sempre fa la differenza.
Ripetiamo ancora, con il livello di ottimizzazione 3:
pass_manager = generate_preset_pass_manager(
    optimization_level=3, backend=backend, seed_transpiler=12345
)
qc_t3_exact = pass_manager.run(qc)
qc_t3_exact.draw("mpl", idle_wires=False)
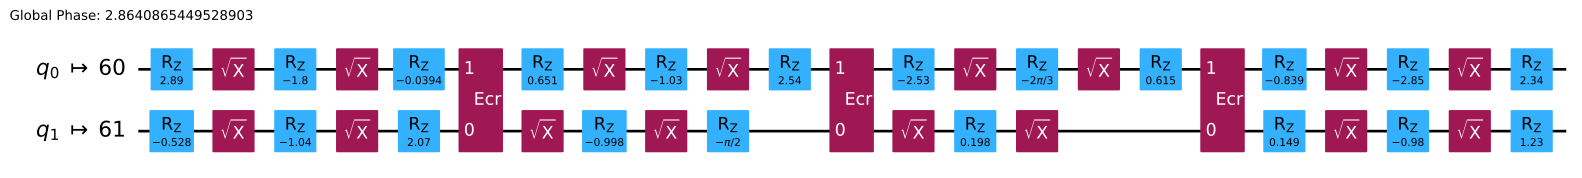
Ora ci sono solo tre gate ECR. Otteniamo questo risultato perché al livello di ottimizzazione 3, Qiskit tenta di ri-sintetizzare blocchi di gate a due qubit, e qualsiasi gate a due qubit può essere implementato usando al massimo tre gate ECR. Possiamo ottenere ancora meno gate ECR se impostiamo approximation_degree a un valore inferiore a 1, consentendo al transpiler di fare approssimazioni che potrebbero introdurre qualche errore nella decomposizione del gate (vedi Parametri comunemente usati per la trasposizione):
pass_manager = generate_preset_pass_manager(
    optimization_level=3,
    approximation_degree=0.99,
    backend=backend,
    seed_transpiler=12345,
)
qc_t3_approx = pass_manager.run(qc)
qc_t3_approx.draw("mpl", idle_wires=False)
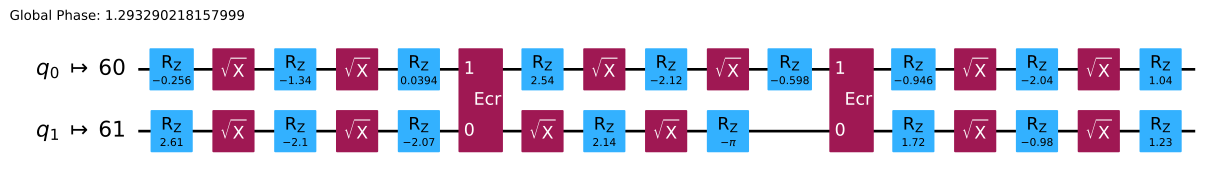
Questo circuito ha solo due gate ECR, ma è un circuito approssimato. Per capire in che misura il suo effetto differisce dal circuito esatto, possiamo calcolare la fedeltà tra l'operatore unitario implementato da questo circuito e l'unitario esatto. Prima di eseguire il calcolo, riduciamo il circuito transpilato, che contiene 127 qubit, a un circuito che contiene solo i qubit attivi, che sono due.
import numpy as np

def trace_to_fidelity_2q(trace: float) -> float:
    return (4.0 + trace * trace.conjugate()) / 20.0

# Reduce circuits down to 2 qubits so they are easy to simulate
qc_t3_exact_small = QuantumCircuit.from_instructions(qc_t3_exact)
qc_t3_approx_small = QuantumCircuit.from_instructions(qc_t3_approx)

# Compute the fidelity
exact_fid = trace_to_fidelity_2q(
    np.trace(np.dot(Operator(qc_t3_exact_small).adjoint().data, UU))
)
approx_fid = trace_to_fidelity_2q(
    np.trace(np.dot(Operator(qc_t3_approx_small).adjoint().data, UU))
)
print(
    f"Synthesis fidelity\nExact: {exact_fid:.3f}\nApproximate: {approx_fid:.3f}"
)
Synthesis fidelity
Exact: 1.000+0.000j
Approximate: 0.992+0.000j
Regolare il livello di ottimizzazione può cambiare anche altri aspetti del circuito, non solo il numero di gate ECR. Per esempi di come l'impostazione del livello di ottimizzazione cambia il layout, vedi Rappresentare i computer quantistici.
Passi successivi
- Per saperne di più sulla funzione
generate_preset_passmanager, inizia con l'argomento Impostazioni predefinite e opzioni di configurazione della transpilazione. - Continua a studiare la transpilazione con l'argomento Fasi del transpiler.
- Prova la guida Confronta le impostazioni del transpiler.
- Prova il tutorial Costruisci codici a ripetizione.
- Consulta la documentazione API di Transpile.