QESEM: una Qiskit Function di Qedma
Consulta il riferimento API
Versioni dei pacchetti
Il codice in questa pagina è stato sviluppato utilizzando i seguenti requisiti. Consigliamo di utilizzare queste versioni o versioni più recenti.
qiskit[all]~=2.5.0
qiskit-ibm-runtime~=0.47.0
Le Qiskit Functions sono una funzionalità sperimentale disponibile esclusivamente per gli utenti dei piani IBM Quantum® Premium, Flex e On-Prem (tramite IBM Quantum Platform API). Sono in stato di anteprima e soggette a modifiche.
Panoramica
Sebbene le unità di elaborazione quantistica abbiano fatto grandi progressi negli ultimi anni, gli errori dovuti al rumore e alle imperfezioni dell'hardware esistente rimangono una sfida centrale per gli sviluppatori di algoritmi quantistici. Con l'avvicinarsi di computazioni quantistiche su scala utilitaria che non possono essere verificate classicamente, le soluzioni per eliminare il rumore con precisione garantita diventano sempre più importanti. Per superare questa sfida, Qedma ha sviluppato Quantum Error Mitigation (QESEM), integrato senza soluzione di continuità su IBM Quantum Platform come Qiskit Function.
Con QESEM, gli utenti possono eseguire i propri circuiti quantistici su QPU rumorose per ottenere risultati altamente accurati e privi di errori, con overhead di tempo QPU estremamente efficienti, vicini ai limiti fondamentali. Per raggiungere questo obiettivo, QESEM sfrutta una serie di metodi proprietari sviluppati da Qedma per la caratterizzazione e la riduzione degli errori. Le tecniche di riduzione degli errori includono l'ottimizzazione dei gate, la transpilazione consapevole del rumore, la soppressione degli errori (ES) e la mitigazione degli errori non distorta (EM). Grazie a questa combinazione di metodi basati sulla caratterizzazione, gli utenti possono ottenere risultati affidabili e privi di errori per circuiti quantistici generici ad alto volume, aprendo la strada ad applicazioni altrimenti impossibili da realizzare.
Per una descrizione completa dei componenti sottostanti e una dimostrazione su scala utilitaria, consulta l'articolo Reliable high-accuracy error mitigation for utility-scale quantum circuits.
Descrizione
Puoi utilizzare la funzione QESEM di Qedma per stimare ed eseguire facilmente i tuoi circuiti con soppressione e mitigazione degli errori, ottenendo volumi di circuiti più grandi e precisioni più elevate. Per usare QESEM, devi fornire un circuito quantistico, un insieme di osservabili da misurare, una precisione statistica target per ciascun osservabile e una QPU scelta. Prima di eseguire il circuito alla precisione target, puoi stimare il tempo QPU necessario sulla base di un calcolo analitico che non richiede l'esecuzione del circuito. Una volta soddisfatto della stima del tempo QPU, puoi eseguire il circuito con QESEM.
Quando esegui un circuito, QESEM avvia un protocollo di caratterizzazione del dispositivo personalizzato per il tuo circuito, producendo un modello di rumore affidabile per gli errori che si verificano nel circuito. Sulla base della caratterizzazione, QESEM implementa innanzitutto la transpilazione consapevole del rumore per mappare il circuito di input su un insieme di qubit fisici e gate, minimizzando il rumore che influisce sull'osservabile target. Questi includono i gate nativamente disponibili (CX/CZ sui dispositivi IBM®), oltre a gate aggiuntivi ottimizzati da QESEM, che formano il set di gate esteso di QESEM. QESEM esegue quindi un insieme di circuiti ES ed EM basati sulla caratterizzazione sulla QPU e raccoglie i risultati delle misurazioni. Questi vengono poi post-elaborati classicamente per fornire un valore di aspettazione non distorto e una barra di errore per ciascun osservabile, corrispondente alla precisione richiesta.
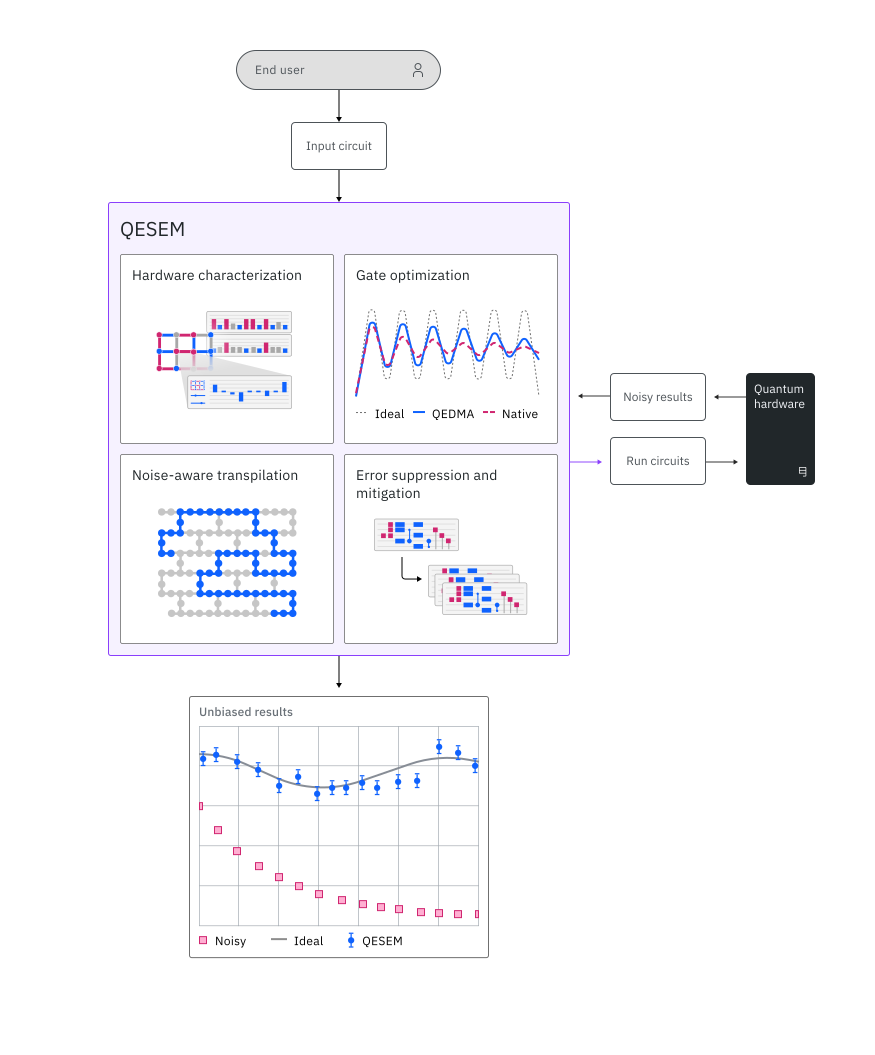 QESEM ha dimostrato di fornire risultati ad alta precisione per un'ampia varietà di applicazioni quantistiche e sui volumi di circuiti più grandi attualmente raggiungibili. QESEM offre le seguenti funzionalità orientate all'utente, dimostrate nella sezione benchmark qui sotto:
- Precisione garantita: QESEM produce stime non distorte per i valori di aspettazione degli osservabili. Il suo metodo EM è dotato di garanzie teoriche che, insieme alla caratterizzazione all'avanguardia di Qedma, assicurano che la mitigazione converga all'output del circuito privo di rumore entro la precisione specificata dall'utente. A differenza di molti metodi EM euristici soggetti a errori sistematici o distorsioni, la precisione garantita di QESEM è essenziale per garantire risultati affidabili in circuiti quantistici e osservabili generici.
- Scalabilità a QPU di grandi dimensioni: il tempo QPU di QESEM dipende dai volumi dei circuiti, ma è altrimenti indipendente dal numero di qubit. Qedma ha dimostrato QESEM sui dispositivi quantistici più grandi disponibili oggi, inclusi IBM Quantum Eagle a 127 qubit e Heron a 133 qubit.
- Indipendente dall'applicazione: QESEM è stato dimostrato su un'ampia varietà di applicazioni, tra cui simulazione hamiltoniana, VQE, QAOA e stima dell'ampiezza. Gli utenti possono inserire qualsiasi circuito quantistico e osservabile da misurare e ottenere risultati accurati e privi di errori. Le uniche limitazioni sono dettate dalle specifiche hardware e dal tempo QPU allocato, che determinano i volumi di circuiti accessibili e le precisioni di output. Al contrario, molte soluzioni di riduzione degli errori sono specifiche per applicazione o coinvolgono euristiche non controllate, rendendole inapplicabili per circuiti e applicazioni quantistiche generiche.
- Set di gate esteso: QESEM supporta i gate ad angolo frazionario e fornisce gate ad angolo frazionario ottimizzati da Qedma sui dispositivi IBM Quantum Heron e Eagle. Questo set di gate esteso consente una compilazione più efficiente e sblocca volumi di circuiti superiori fino a un fattore 2 rispetto alla compilazione CX/CZ predefinita.
- Osservabili multi-base: QESEM supporta osservabili di input composti da molte stringhe di Pauli non commutanti, come gli Hamiltoniani generici. La scelta delle basi di misura e l'ottimizzazione dell'allocazione delle risorse QPU (shot e circuiti) vengono quindi eseguite automaticamente da QESEM per minimizzare il tempo QPU richiesto per la precisione richiesta. Questa ottimizzazione, che tiene conto delle fedeltà hardware e dei tassi di esecuzione, consente di eseguire circuiti più profondi e ottenere precisioni più elevate.
Benchmark
QESEM è stato testato su un'ampia varietà di casi d'uso e applicazioni. I seguenti esempi possono aiutarti a valutare quali tipi di carichi di lavoro puoi eseguire con QESEM.
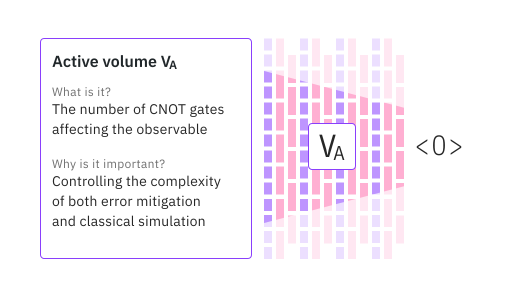
Una figura di merito fondamentale per quantificare la difficoltà sia della mitigazione degli errori sia della simulazione classica per un dato circuito e osservabile è il volume attivo: il numero di gate CNOT che influiscono sull'osservabile nel circuito. Il volume attivo dipende dalla profondità e dalla larghezza del circuito, dal peso dell'osservabile e dalla struttura del circuito, che determina il cono di luce dell'osservabile. Per ulteriori dettagli, consulta il talk dell'IBM Quantum Summit 2024. QESEM offre un valore particolarmente elevato nel regime ad alto volume, fornendo risultati affidabili per circuiti e osservabili generici.
| Applicazione | Numero di qubit | Dispositivo | Descrizione del circuito | Precisione | Tempo totale | Utilizzo runtime |
|---|---|---|---|---|---|---|
| Circuito VQE | 8 | Eagle (r3) | 21 strati totali, 9 basi di misura, catena 1D | 98% | 35 min | 14 min |
| Kicked Ising | 28 | Eagle (r3) | 3 strati unici x 3 passi, topologia heavy-hex 2D | 97% | 22 min | 4 min |
| Kicked Ising | 28 | Eagle (r3) | 3 strati unici x 8 passi, topologia heavy-hex 2D | 97% | 116 min | 23 min |
| Simulazione hamiltoniana di Trotter | 40 | Eagle (r3) | 2 strati unici x 10 passi di Trotter, catena 1D | 97% | 3 ore | 25 min |
| Simulazione hamiltoniana di Trotter | 119 | Eagle (r3) | 3 strati unici x 9 passi di Trotter, topologia heavy-hex 2D | 95% | 6,5 ore | 45 min |
| Kicked Ising | 136 | Heron (r2) | 3 strati unici x 15 passi, topologia heavy-hex 2D | 99% | 52 min | 9 min |
La precisione è misurata qui rispetto al valore ideale dell'osservabile: , dove '' è la precisione assoluta della mitigazione (impostata dall'input dell'utente) e è l'osservabile nel circuito privo di rumore. "Utilizzo runtime" misura l'utilizzo del benchmark in batch mode (somma dell'utilizzo dei singoli job), mentre "tempo totale" misura l'utilizzo in session mode (tempo reale dell'esperimento), che include i tempi di elaborazione classica e comunicazione aggiuntivi. QESEM è disponibile per l'esecuzione in entrambe le modalità, in modo che gli utenti possano fare il miglior uso delle risorse disponibili.
I circuiti Kicked Ising a 28 qubit simulano il Quasicristallo a Tempo Discreto studiato da Shinjo et al. (vedi arXiv 2403.16718 e Q2B24 Tokyo) su tre loop connessi di ibm_kawasaki. I parametri del circuito utilizzati qui sono , con uno stato iniziale ferromagnetico . L'osservabile misurato è il valore assoluto della magnetizzazione . L'esperimento Kicked Ising su scala utilitaria è stato eseguito sui 136 migliori qubit di ibm_fez; questo benchmark in particolare è stato eseguito all'angolo di Clifford , al quale il volume attivo cresce lentamente con la profondità del circuito, il che — insieme alle elevate fedeltà del dispositivo — consente alta precisione con un breve tempo di esecuzione.
I circuiti di simulazione hamiltoniana di Trotter sono relativi a un modello di Ising a Campo Trasverso ad angoli frazionari: e rispettivamente (vedi Q2B24 Tokyo). Il circuito su scala utilitaria è stato eseguito sui 119 migliori qubit di ibm_brisbane, mentre l'esperimento a 40 qubit è stato eseguito sulla migliore catena disponibile. La precisione è riportata per la magnetizzazione; risultati ad alta precisione sono stati ottenuti anche per osservabili di peso maggiore.
Il circuito VQE è stato sviluppato insieme a ricercatori del Center for Quantum Technology and Applications presso il Deutsches Elektronen-Synchrotron (DESY). L'osservabile target era un Hamiltoniano composto da un grande numero di stringhe di Pauli non commutanti, sottolineando le prestazioni ottimizzate di QESEM per gli osservabili multi-base. La mitigazione è stata applicata a un ansatz ottimizzato classicamente; sebbene questi risultati siano ancora inediti, risultati della stessa qualità si otterranno per circuiti diversi con proprietà strutturali simili.
Per iniziare
Autenticati con la tua chiave API di IBM Quantum Platform e seleziona la Qiskit Function QESEM come segue. (Questo snippet presuppone che tu abbia già salvato il tuo account nel tuo ambiente locale.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
import qiskit
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
# load the function
qesem_function = catalog.load("qedma/qesem")
Esempi
Esempio di job di stima del tempo
Il job di stima del tempo è utile per stimare il tempo QPU necessario per un dato pub e backend_name. backend_name può anche essere impostato su qualsiasi backend simulatore; ad esempio, fake_fez.
QESEM utilizza un metodo di mitigazione degli errori quasi-probabilistico basato sulla caratterizzazione. Questo metodo ha un overhead di tempo QPU che approssimativamente scala come:
Dove è il volume attivo del circuito, è la precisione target, e è l'infedeltà dei gate nativi.
Nota che "estimate_time_only": "empirical" utilizza alcuni minuti di tempo QPU per stimare il tempo necessario per il job (se il backend è un dispositivo reale; se è un simulatore, non viene utilizzato alcun tempo QPU). Questo di solito richiede circa 5 minuti, ma non più di 10 minuti. Se l'infedeltà cambia drasticamente tra il job di stima del tempo empirico e il job di mitigazione, anche il tempo QPU cambierà drasticamente.
Per iniziare, prova questo esempio di base per stimare il tempo QPU necessario all'esecuzione di QESEM per un dato pub:
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
backend_name = "fake_fez"

circ = qiskit.QuantumCircuit(5)
circ.cx(0, 1)
circ.cx(2, 3)
circ.cx(1, 2)
circ.cx(3, 4)

avg_magnetization = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("Z", [q], 1 / 5) for q in range(5)], num_qubits=5
)
other_observable = qiskit.quantum_info.SparsePauliOp.from_sparse_list(
    [("ZZ", [0, 1], 1.0), ("XZ", [1, 4], 0.5)], num_qubits=5
)

time_estimation_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    options={
        "estimate_time_only": "empirical",
    },
    backend_name=backend_name,  # example: "fake_fez", "ibm_fez"
)
time_estimate_result = (
    time_estimation_job.result()
)  # a list of results per pub (circuit)
Il seguente snippet di codice mostra come recuperare diverse metriche di esecuzione dal job di stima del tempo (estimate_time_only è impostato):
pub_result = time_estimate_result[0]

print(
    f"The estimated QPU time for mitigation for this PUB is: {pub_result.metadata['time_estimation_sec']}"
)
print(
    f"The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
)
print(
    f"Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
)
print(f"Total shots: {pub_result.metadata['total_shots']}")
print(f"Resource usage breakdown: {pub_result.metadata['resource_usage']}")
The estimated QPU time for mitigation for this PUB is: 300
The QPU time that this time estimation job took is (here it is 0 because we used fake_fez): 0
Gates fidelity measured during the experiment: {'CZ': 0.9951354916722668, 'ID1Q': 0.9991246627329172}
Total shots: 220000
Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 33.6066133165732, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 184.53575124032795, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
Quando la stima del tempo empirica è abilitata, QESEM esegue un piccolo numero di circuiti per fornire una stima del tempo QPU più accurata. I risultati di mitigazione di questi circuiti sono disponibili nel campo empirical_estimation_mitigation_results del job.
Poiché questi risultati derivano da un campione limitato di circuiti, sono significativamente meno accurati dei risultati finali ottenuti dal job di mitigazione QESEM completo. Tuttavia, quando il circuito è piccolo o la precisione target è bassa, la mitigazione eseguita durante la stima del tempo empirica può essere sufficiente a raggiungere la precisione desiderata, e il job di mitigazione completo potrebbe non essere necessario.
Il campo empirical_estimation_mitigation_results è un elenco di oggetti PrimitiveResult per ogni parametro di input. Se il circuito non è parametrizzato, l'elenco avrà lunghezza 1.
empirical_estimation_mitigation_results = time_estimate_result[0].metadata[
    "empirical_estimation_mitigation_results"
][0]  # a list per parameter
print("Partial results for the observables:")

print(
    f"    Mitigated expectation values: {empirical_estimation_mitigation_results.data.evs}"
)
print(
    f"    Mitigated error bars: {empirical_estimation_mitigation_results.data.stds}"
)
print(
    f"    Number of shots used for mitigation: {empirical_estimation_mitigation_results.metadata['mitigation_shots']}"
)
transpiled_circ = empirical_estimation_mitigation_results.metadata[
    "transpiled_circ"
]
print(f"    Qubit mapping: {transpiled_circ['qubit_maps']}")
print(
    f"    Number of measurement bases: {transpiled_circ['num_measurement_bases']}\n"
)

# results per obs
emp_obs_results = empirical_estimation_mitigation_results.metadata["results"][
    0
]
# print(f"Results for each observable: {results}")
print("Results for each observable:")

for i, (obs_array, result_dict) in enumerate(emp_obs_results):
    # obs_array, result_dict = results
    print(f"Observable {i+1}: {obs_array}")
    print(
        f"    QESEM mitigated value: {result_dict['qesem']['value']} \u00b1 {result_dict['qesem']['error_bar']}"
    )
Partial results for the observables:
    Mitigated expectation values: [1.00347302 1.00693905]
    Mitigated error bars: [0.00304061 0.00714276]
    Number of shots used for mitigation: 180000
    Qubit mapping: [[[0, 136], [1, 143], [2, 142], [3, 141], [4, 140]]]
    Number of measurement bases: 2

Results for each observable:
Observable 1: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
    QESEM mitigated value: 1.003473015776871 ± 0.0030406128032204015
Observable 2: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
    QESEM mitigated value: 1.0069390542613554 ± 0.0071427606736885925
Esempio di job di mitigazione QESEM
Il seguente esempio esegue un job QESEM:
sample_job = qesem_function.run(
    pubs=[(circ, [avg_magnetization, other_observable])],
    backend_name=backend_name,  # example: "ibm_fez"
    # options = {
    #     "estimate_time_only": "empirical",
    #     "default_precision": 0.2,  # Default precision is applied to all pubs that don't have a precision specified, see API reference for more details
    #     "max_execution_time": 3600,  # You can specify a maximum QPU time in seconds, see API reference for more details
    #     "transpilation_level": "standard",  # "minimal_with_layout_opt" for minimal transpilation, see API reference for more details
    #     "parallel_execution": True,  # True for parallel execution, see API reference for more details
    # },
)
Per una descrizione dettagliata di ogni campo di input e opzione, consulta il riferimento API di QESEM. Puoi utilizzare le familiari API di Qiskit Serverless per controllare lo stato del tuo carico di lavoro Qiskit Function o recuperare i risultati:
# Print the ID so you can use it later, if necessary
print(sample_job.job_id)
print(sample_job.status())
sample_result = sample_job.result()
3ac6b2df-15b0-4dc0-8f48-cf14bd20a1c8
DONE
Il seguente snippet di codice mostra come recuperare i risultati della mitigazione e le metriche di esecuzione. Questi contengono dati essenziali che consentono una comprensione più approfondita di come i diversi parametri influiscono sull'esecuzione di QESEM. Può essere utile anche quando scrivi un articolo basato sulla tua ricerca.
for pub_idx, pub_result in enumerate(
    sample_result
):  # each element in the list is a result for a different pub, here we sent only one pub
    print(f"\nPUB {pub_idx}:")
    print(
        f"  The QPU time that this job took is (here it is 0 because we used fake_fez): {pub_result.metadata['total_qpu_time']}"
    )
    print(
        f"  Gates fidelity measured during the experiment: {pub_result.metadata['gate_fidelities']}"
    )
    print(f"  Total shots: {pub_result.metadata['total_shots']}")
    print(
        f"  Number of shots used for mitigation: {pub_result.metadata['mitigation_shots']}"
    )
    print(
        f"  Resource usage breakdown: {pub_result.metadata['resource_usage']}"
    )
PUB 0:
  The QPU time that this job took is (here it is 0 because we used fake_fez): 0.0
  Gates fidelity measured during the experiment: {'CZ': 0.9953704216147041, 'ID1Q': 0.9991834123567518}
  Total shots: 446000
  Number of shots used for mitigation: 194000
  Resource usage breakdown: {'RUNNING: MAPPING': {'CPU_TIME': 32.52745003718883, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: OPTIMIZING_FOR_HARDWARE': {'CPU_TIME': 257.850521848537, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: WAITING_FOR_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: EXECUTING_QPU': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}, 'RUNNING: POST_PROCESSING': {'CPU_TIME': 0.0, 'GPU_TIME': 0.0, 'QPU_TIME': 0.0}}
In metadata["results"], i risultati sono raggruppati prima per istanza di circuito e poi per osservabile.
print("Full QESEM mitigation results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")

    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata.get("noisy_results")
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")

    print("  Transpiled circuits:")
    for circ_idx, transpiled_circ in enumerate(
        pub_result.metadata["transpiled_circs"]
    ):
        print(f"    Circuit {circ_idx}:")
        # print(f"      Circuit: \n {transpiled_circ['circuit']}") # not printing it because it's long but you can see the transpiled circuit itself
        print(f"      Qubit mapping: {transpiled_circ['qubit_maps']}")
        print(
            f"      Measurement bases: {transpiled_circ['num_measurement_bases']}"
        )

    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Full QESEM mitigation results:

PUB 0:
  Mitigated expectation values: [1.00648343 1.00636289]
  Mitigated error bars: [0.00253812 0.00693586]
  Unmitigated expectation values: [0.98031429 0.96357143]
  Unmitigated error bars: [0.00124128 0.00578812]
  Transpiled circuits:
    Circuit 0:
      Qubit mapping: [[[0, 140], [1, 141], [2, 142], [3, 143], [4, 136]]]
      Measurement bases: 2
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 1.0064834305181962 ± 0.002538119914534849
        Unmitigated value: 0.9803142857142859 ± 0.0012412835813609938
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0063628870614818 ± 0.006935859820870656
        Unmitigated value: 0.9635714285714285 ± 0.005788121870526659
Riepilogo dei risultati principali:
mitigated: il valore di aspettazione QESEM completamente mitigato.unmitigated: il risultato grezzo del rumore fisico senza mitigazione degli errori.
Risultati di estrapolazione euristica QESEM
In un'esecuzione QESEM standard con un singolo valore precision in virgola mobile, i risultati includono anche punti di scaling del rumore disponibili automaticamente che vengono utilizzati per l'euristica QESEM. Questi punti vengono calcolati senza risorse QPU aggiuntive.
La scala 1.0 rappresenta il livello di rumore del dispositivo fisico con mitigazione della lettura (REM), mentre la scala 2.0 è il punto complementare a rumore amplificato, anch'esso con REM. Questi punti vengono utilizzati per produrre il risultato qesem_heuristic.
-
qesem_heuristic: una stima in stile ZNE calcolata a partire dai dati con scala del rumore disponibili. Attualmente, utilizza l'estrapolazione esponenziale. -
noise_scaling.results_with_REM: valori di aspettazione a diverse scale di rumore, tutti con mitigazione della lettura (REM).
Un dettaglio sottile ma importante è che il risultato alla scala 1.0 non è uguale al risultato unmitigated. Entrambi corrispondono al livello di rumore del dispositivo fisico, ma il punto a scala 1.0 include la mitigazione della lettura, mentre unmitigated no.
print("QESEM heuristic results:")

for pub_idx, pub_result in enumerate(sample_result):
    print(f"\nPUB {pub_idx}:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"  Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"    Observable {obs_idx}: {obs_array}")
            qesem_heuristic = result_dict["qesem_heuristic"][0]
            print("      QESEM heuristic:")
            print(
                f"        Value: {qesem_heuristic['value']} ± {qesem_heuristic['error_bar']}"
            )
            print(
                f"        Extrapolation: {qesem_heuristic['extrapolation']}"
            )
            print(
                f"        Scale factors: {qesem_heuristic['scale_factors']}"
            )
            noise_scaling = result_dict["noise_scaling"]
            print("      Noise scaling results:")
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QESEM heuristic results:

PUB 0:
  Circuit 0:
    Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
      QESEM heuristic:
        Value: 1.0008161638888535 ± 0.0038859458884403964
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9918395459270772 ± 0.0012565417579355634
          Scale factor 2.0: 0.982943441922748 ± 0.0028919278067695018
    Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
      QESEM heuristic:
        Value: 0.9960853148925298 ± 0.013811635038961175
        Extrapolation: exponential
        Scale factors: [1.0, 2.0]
      Noise scaling results:
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 1.0: 0.9902860583785115 ± 0.005921236914723409
          Scale factor 2.0: 0.984520565414274 ± 0.006909522262347639
I seguenti esempi si concentrano su input e risultati specifici della funzionalità, quindi non stampano le metriche di esecuzione complete ogni volta. I metadati di primo livello mostrati in precedenza, come total_qpu_time, gate_fidelities, total_shots, mitigation_shots, e resource_usage, sono disponibili anche per questi job.
Alcune variabili dagli esempi precedenti, tra cui il backend, gli osservabili e i parametri del circuito di base, vengono riutilizzate di seguito per brevità.
Tutti i seguenti esempi possono anche essere eseguiti con la stima del tempo empirica. Per abilitarla, passa "estimate_time_only": "empirical" nelle opzioni della funzione.
Esempio di circuito parametrizzato
Molti algoritmi valutano lo stesso circuito a diversi valori dei parametri. Inviare il circuito parametrizzato come un unico job QESEM permette a QESEM di condividere la caratterizzazione e la calibrazione tra le istanze del circuito, il che può ridurre l'overhead di tempo QPU rispetto all'esecuzione di job separati.
L'invio di un circuito parametrizzato richiede l'utilizzo del livello di transpilazione "minimal_with_layout_opt".
I circuiti inviati a questo livello dovrebbero già essere espressi utilizzando i gate di base del backend, a seconda del backend. A questo livello, QESEM mantiene la struttura inviata il più vicino possibile al circuito di input, rispetta le barriere durante la layerificazione (raggruppando le operazioni in strati di gate a due qubit paralleli), e gestisce comunque automaticamente la mappatura hardware su qubit ad alta fedeltà e la connettività del dispositivo.
In pratica, questo significa che dovresti transpilare i circuiti sui gate di base del backend target prima dell'invio. Di seguito è mostrato un semplice esempio di transpilazione dei gate di base.
QESEM attualmente supporta solo un osservabile per set di parametri. Le due righe di parametri qui sotto sono abbinate ai due osservabili: la prima riga viene misurata con avg_magnetization, e la seconda riga viene misurata con other_observable.
# Transpile to the backend basis gates only. With minimal_with_layout_opt, QESEM handles hardware mapping/connectivity and observable layout internally.
from qiskit_ibm_runtime.fake_provider import FakeFez

backend = FakeFez()
basis = backend.operation_names
print(basis)

param0 = qiskit.circuit.Parameter("param0")
param1 = qiskit.circuit.Parameter("param1")
parametrized_circ = qiskit.QuantumCircuit(5)
parametrized_circ.rx(param0, 0)
parametrized_circ.rx(param1, 1)
parametrized_circ.cx(0, 1)
parametrized_circ.cx(2, 3)
parametrized_circ.cx(1, 2)
parametrized_circ.cx(3, 4)

parametrized_circ = qiskit.transpile(
    parametrized_circ, basis_gates=basis, optimization_level=1
)
parametrized_parameter_values = [[0.5, 0.1], [0.0, 0.6]]
parametrized_observables = [avg_magnetization, other_observable]

parametrized_job = qesem_function.run(
    pubs=[
        (
            parametrized_circ,
            parametrized_observables,
            parametrized_parameter_values,
            0.1,
        )
    ],
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
    },
)
print(parametrized_job.job_id)
print(parametrized_job.status())
d1b0e29b-196c-4896-aec6-44a268ebd874
DONE
parametrized_result = parametrized_job.result()
print("Parameterized circuit QESEM results:")

for pub_idx, pub_result in enumerate(parametrized_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each parameter value:")
    for param_idx, param_results in enumerate(pub_result.metadata["results"]):
        print(
            f"    Parameter set {param_idx}: {parametrized_parameter_values[param_idx]}"
        )
        for obs_idx, (obs_array, result_dict) in enumerate(param_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Parameterized circuit QESEM results:

PUB 0:
  Mitigated expectation values: [0.92392021 0.82517653]
  Mitigated error bars: [0.00565281 0.00616016]
  Unmitigated expectation values: [0.9028     0.78771429]
  Unmitigated error bars: [0.00335142 0.00925413]
  Results for each parameter value:
    Parameter set 0: [0.5, 0.1]
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.923920210615709 ± 0.005652811570890183
        Unmitigated value: 0.9028 ± 0.0033514176105045447
    Parameter set 1: [0.0, 0.6]
      Observable 0: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 0.8251765289285893 ± 0.006160161743353999
        Unmitigated value: 0.7877142857142858 ± 0.009254130564027902
Esempio multi-pub
L'esecuzione multi-pub è utile quando vuoi eseguire diversi circuiti correlati in un unico job QESEM. Come l'esecuzione parametrizzata, questo può ridurre l'overhead perché QESEM può condividere la caratterizzazione e la calibrazione tra le istanze del circuito invece di ripeterla in job separati.
Questo è particolarmente utile per circuiti con una struttura a strati condivisa, come i carichi di lavoro di tipo Trotter, dove diversi circuiti riutilizzano gli stessi strati unici. In questo caso, eseguirli insieme può ridurre il costo di caratterizzazione rispetto a job QESEM indipendenti.
I job multi-pub richiedono "transpilation_level": "minimal_with_layout_opt". Come nell'esempio parametrizzato, i circuiti dovrebbero essere transpilati sui gate di base del backend target prima dell'invio. QESEM gestisce quindi internamente la connettività del dispositivo, il layout e la mappatura sui qubit ad alta fedeltà.
Ogni PUB qui sotto contiene un circuito e gli stessi due osservabili utilizzati in precedenza nel notebook, quindi il PrimitiveResult restituito contiene un PubResult per ogni circuito di input.
L'esempio seguente utilizza due semplici circuiti Trotter con lo stesso schema di strati: circ_a ha uno strato Trotter, e circ_b ripete due volte lo stesso schema di strati. Questo rende esplicita la struttura condivisa.
def make_trotter_circuit(num_qubits, num_layers, zz_angle=0.2, x_angle=0.1):
    trotter_circ = qiskit.QuantumCircuit(num_qubits)
    for _ in range(num_layers):
        for q in range(num_qubits):
            trotter_circ.rx(x_angle, q)
        trotter_circ.barrier()
        for q in range(0, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
        for q in range(1, num_qubits - 1, 2):
            trotter_circ.rzz(zz_angle, q, q + 1)
        trotter_circ.barrier()
    return trotter_circ

circ_a = make_trotter_circuit(num_qubits=5, num_layers=1)
circ_b = make_trotter_circuit(num_qubits=5, num_layers=2)
multi_pubs = [
    (
        qiskit.transpile(qci, basis_gates=basis, optimization_level=1),
        [avg_magnetization, other_observable],
    )
    for qci in [circ_a, circ_b]
]

multi_circ_job = qesem_function.run(
    pubs=multi_pubs,
    backend_name=backend_name,
    options={
        "max_execution_time": 300,
        "transpilation_level": "minimal_with_layout_opt",
        "default_precision": 0.1,
    },
)
print(multi_circ_job.job_id)
print(multi_circ_job.status())
e34565b8-7262-4133-a120-de42ce624a99
DONE
multi_circ_result = multi_circ_job.result()
print("Multi-pub QESEM results:")

for pub_idx, pub_result in enumerate(multi_circ_result):
    print(f"\nPUB {pub_idx}:")
    print(f"  Mitigated expectation values: {pub_result.data.evs}")
    print(f"  Mitigated error bars: {pub_result.data.stds}")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            print(
                f"        QESEM mitigated value: {result_dict['qesem']['value']} ± {result_dict['qesem']['error_bar']}"
            )
            print(
                f"        Unmitigated value: {result_dict['unmitigated']['value']} ± {result_dict['unmitigated']['error_bar']}"
            )
Multi-pub QESEM results:

PUB 0:
  Mitigated expectation values: [0.99502406 1.02209332]
  Mitigated error bars: [0.00483819 0.00707488]
  Unmitigated expectation values: [0.96934286 0.97271429]
  Unmitigated error bars: [0.00124855 0.00617294]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.9950240647925642 ± 0.004838188086259301
        Unmitigated value: 0.9693428571428573 ± 0.0012485470362492692
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.0220933230604674 ± 0.007074884384355636
        Unmitigated value: 0.9727142857142859 ± 0.006172939375512439

PUB 1:
  Mitigated expectation values: [0.98850017 1.02555188]
  Mitigated error bars: [0.0077912  0.01672652]
  Unmitigated expectation values: [0.93682857 0.95371429]
  Unmitigated error bars: [0.00156245 0.00665735]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        QESEM mitigated value: 0.988500171577252 ± 0.007791203181151346
        Unmitigated value: 0.9368285714285716 ± 0.001562451883089579
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        QESEM mitigated value: 1.02555188098689 ± 0.016726524388086233
        Unmitigated value: 0.9537142857142858 ± 0.006657345655544263
Esempio di Quasi-probabilistic Error Tuning (QET)
Quasi-probabilistic Error Tuning (QET) richiede valori di aspettazione a fattori di scala del rumore selezionati. Questo è utile per studi personalizzati di scaling del rumore e flussi di lavoro di Zero-Noise Extrapolation. La scala 1.0 è il livello di rumore fisico, i valori tra 0.0 e 1.0 riducono parzialmente il rumore, e i valori superiori a 1.0 amplificano il rumore.
Per utilizzare QET con la Qiskit Function, passa un dizionario come precisione del PUB. Il dizionario mappa ogni scala di rumore richiesta alla sua precisione target. I risultati dei fattori di scala restituiti sono memorizzati in noise_scaling.results_with_REM e includono la mitigazione della lettura. Il punto a scala 1.0 non è quindi identico al valore non mitigato, perché 1.0 include la mitigazione della lettura mentre unmitigated no.
Quando viene richiesta una scala, QESEM restituisce anche la scala complementare attorno a 1.0 senza utilizzo aggiuntivo di QPU. Ad esempio, richiedere 0.5 può anche restituire 1.5, e richiedere 1.3 può anche restituire 0.7. La precisione sulla scala complementare non è garantita.
noise_scale_precision = {0.5: 0.15, 1.3: 0.2}

qet_job = qesem_function.run(
    pubs=[
        (
            circ,
            [avg_magnetization, other_observable],
            None,
            noise_scale_precision,
        )
    ],
    backend_name=backend_name,
    options={"max_execution_time": 300},
)
print(qet_job.job_id)
print(qet_job.status())
8195fa58-f037-4651-8715-36ce1cdc5521
DONE
qet_result = qet_job.result()
print("QET noise-scaling results:")

for pub_idx, pub_result in enumerate(qet_result):
    print(f"\nPUB {pub_idx}:")
    noisy_results = pub_result.metadata["noisy_results"]
    print(f"  Unmitigated expectation values: {noisy_results.evs}")
    print(f"  Unmitigated error bars: {noisy_results.stds}")
    print("  Results for each observable:")
    for circ_idx, circ_results in enumerate(pub_result.metadata["results"]):
        print(f"    Circuit {circ_idx}:")
        for obs_idx, (obs_array, result_dict) in enumerate(circ_results):
            print(f"      Observable {obs_idx}: {obs_array}")
            noise_scaling = result_dict["noise_scaling"]
            print(
                f"        Scaling method: {noise_scaling['scaling_method']}"
            )
            print("        Results with Readout mitigation (REM):")
            for rem_result in sorted(
                (
                    item
                    for item in noise_scaling["results_with_REM"]
                    if item["scale"] != 0.0
                ),
                key=lambda item: item["scale"],
            ):
                print(
                    f"          Scale factor {rem_result['scale']}: {rem_result['value']} ± {rem_result['error_bar']}"
                )
QET noise-scaling results:

PUB 0:
  Unmitigated expectation values: [0.97822857 0.96171429]
  Unmitigated error bars: [0.00123812 0.00672958]
  Results for each observable:
    Circuit 0:
      Observable 0: ObservablesArray({'IIIIZ': 0.2, 'IIIZI': 0.2, 'IIZII': 0.2, 'IZIII': 0.2, 'ZIIII': 0.2}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 0.9938730340199383 ± 0.0032116907357568275
          Scale factor 0.7: 0.9963976191853445 ± 0.00036300258869586616
          Scale factor 1.0: 0.9898115079506586 ± 0.0012525947426560995
          Scale factor 1.3: 0.9864667065580341 ± 0.002633221613518526
          Scale factor 1.5: 0.9838755527197551 ± 0.002948417797996015
      Observable 1: ObservablesArray({'IIIZZ': 1.0, 'ZIIXI': 0.5}, shape=())
        Scaling method: QESEM
        Results with Readout mitigation (REM):
          Scale factor 0.5: 1.0006538544450332 ± 0.002121742014777343
          Scale factor 0.7: 1.0004159801523036 ± 0.0021671375357823794
          Scale factor 1.0: 0.9898058846339917 ± 0.00690183710903159
          Scale factor 1.3: 0.9948946719997267 ± 0.002146532859610311
          Scale factor 1.5: 0.9927220368192772 ± 0.0020875057190323882
Recupero dei messaggi di errore
Se lo stato del tuo carico di lavoro è ERROR, usa job.result() per recuperare il messaggio di errore come segue:
# Get the result and truncate for readability
result = sample_job.result()
result_str = str(result)
max_length = 500  # Adjust this value as necessary

if len(result_str) > max_length:
    truncated = (
        result_str[:max_length]
        + f"... (truncated {len(result_str) - max_length} characters)"
    )
else:
    truncated = result_str

print(truncated)
PrimitiveResult([PubResult(data=DataBin(evs=np.ndarray(<shape=(2,), dtype=float64>), stds=np.ndarray(<shape=(2,), dtype=float64>), shape=(2,)), metadata={'gate_fidelities': {'CZ': 0.9979444718552628, 'ID1Q': 0.9991994239814883}, 'total_shots': 498600, 'mitigation_shots': 223400, 'transpiled_circs': [{'circuit': 'OPENQASM 3.0;\ninclude "stdgates.inc";\nbit[76] c0;\nqubit[76] q0;\nrx(0) q0[54];\nrx(0) q0[59];\nrx(0) q0[75];\nrz(pi/2) q0[54];\nrz(pi/2) q0[59];\nrz(pi/2) q0[75];\nrx(pi/2) q0[54];\nr... (truncated 3771 characters)
Supporto
Il team di supporto di Qedma è qui per aiutarti! Se riscontri problemi o hai domande sull'uso della Qiskit Function QESEM, non esitare a contattarci. Il nostro personale di supporto qualificato e disponibile è pronto ad assisterti per qualsiasi questione tecnica o richiesta.
Puoi inviarci un'e-mail a support@qedma.com per ricevere assistenza. Includi quanti più dettagli possibile sul problema che stai riscontrando per aiutarci a fornire una risposta rapida e precisa. Puoi anche contattare il tuo referente dedicato Qedma (POC) tramite e-mail o telefono.
Per aiutarci ad assisterti in modo più efficiente, fornisci le seguenti informazioni quando ci contatti:
-
Una descrizione dettagliata del problema
-
L'ID del job
-
Eventuali messaggi o codici di errore pertinenti
Ci impegniamo a fornirti un supporto rapido ed efficace per garantirti la migliore esperienza possibile con la nostra Qiskit Function.
Siamo sempre alla ricerca di miglioramenti per il nostro prodotto e accogliamo con piacere i tuoi suggerimenti! Se hai idee su come possiamo migliorare i nostri servizi o funzionalità che vorresti vedere, inviaci i tuoi pensieri a support@qedma.com.
Passi successivi
-
Consulta il riferimento API per questa Qiskit Function.
-
Prova il tutorial Simulate 2D tilted-field Ising with the QESEM function.