Performance Management: Una Qiskit Function di Q-CTRL Fire Opal
Consulta il riferimento API
Le Qiskit Functions sono una funzionalità sperimentale disponibile esclusivamente per gli utenti dei piani IBM Quantum® Premium Plan, Flex Plan e On-Prem (tramite IBM Quantum Platform API). Sono in stato di anteprima e soggette a modifiche.
Versioni dei pacchetti
Il codice in questa pagina è stato sviluppato usando i seguenti requisiti. Si raccomanda di usare queste versioni o versioni più recenti.
qiskit[all]~=2.3.1
qiskit-ibm-runtime~=0.45.1
Panoramica
Fire Opal Performance Management permette a chiunque di ottenere risultati significativi dai computer quantistici su larga scala, senza dover essere esperti di hardware quantistico. Quando esegui circuiti con Fire Opal Performance Management, vengono applicate automaticamente tecniche di soppressione degli errori basate sull'IA, consentendo di scalare problemi più complessi con più gate e qubit. Questo approccio riduce il numero di shot necessari per ottenere la risposta corretta, senza overhead aggiuntivo — garantendo un risparmio significativo sia in termini di tempo di calcolo che di costi.
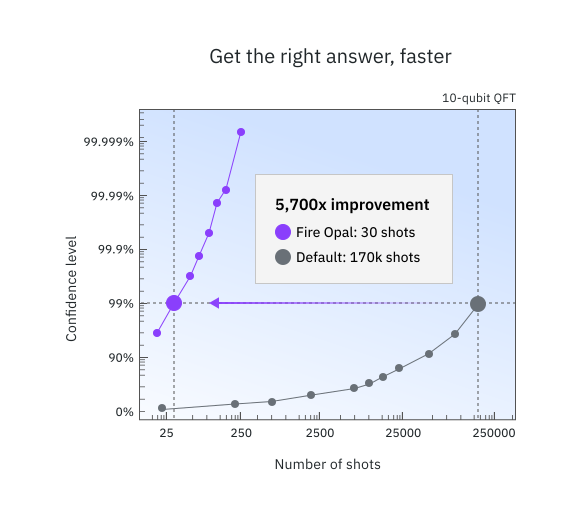
Performance Management sopprime gli errori e aumenta la probabilità di ottenere la risposta corretta su hardware rumoroso. In altre parole, aumenta il rapporto segnale-rumore. L'immagine seguente mostra come la maggiore accuratezza abilitata da Performance Management possa ridurre la necessità di shot aggiuntivi nel caso di un algoritmo Quantum Fourier Transform a 10 qubit. Con soli 30 shot, Q-CTRL raggiunge la soglia di confidenza del 99%, mentre la configurazione predefinita (QiskitRuntime Sampler, optimization_level=3 e resilience_level=1, ibm_sherbrooke) richiede 170.000 shot. Ottenendo la risposta giusta più velocemente, risparmi un tempo di calcolo considerevole.
La funzione Performance Management può essere utilizzata con qualsiasi algoritmo, e puoi facilmente usarla al posto delle primitive IBM Quantum standard. Dietro le quinte, più tecniche di soppressione degli errori lavorano insieme per prevenire gli errori in fase di esecuzione. Tutti i metodi della pipeline Fire Opal sono preconfigurati e indipendenti dall'algoritmo, il che significa che ottieni sempre le migliori prestazioni senza alcuna configurazione.
Per accedere a Performance Management, contatta Q-CTRL.
Descrizione
Fire Opal Performance Management offre due opzioni di esecuzione simili alle primitive IBM Quantum, così puoi facilmente sostituire Q-CTRL Sampler ed Estimator. Il flusso di lavoro generale per utilizzare la funzione Performance Management è:
- Definisci il tuo circuito (e gli operatori nel caso dell'Estimator).
- Esegui il circuito.
- Recupera i risultati.
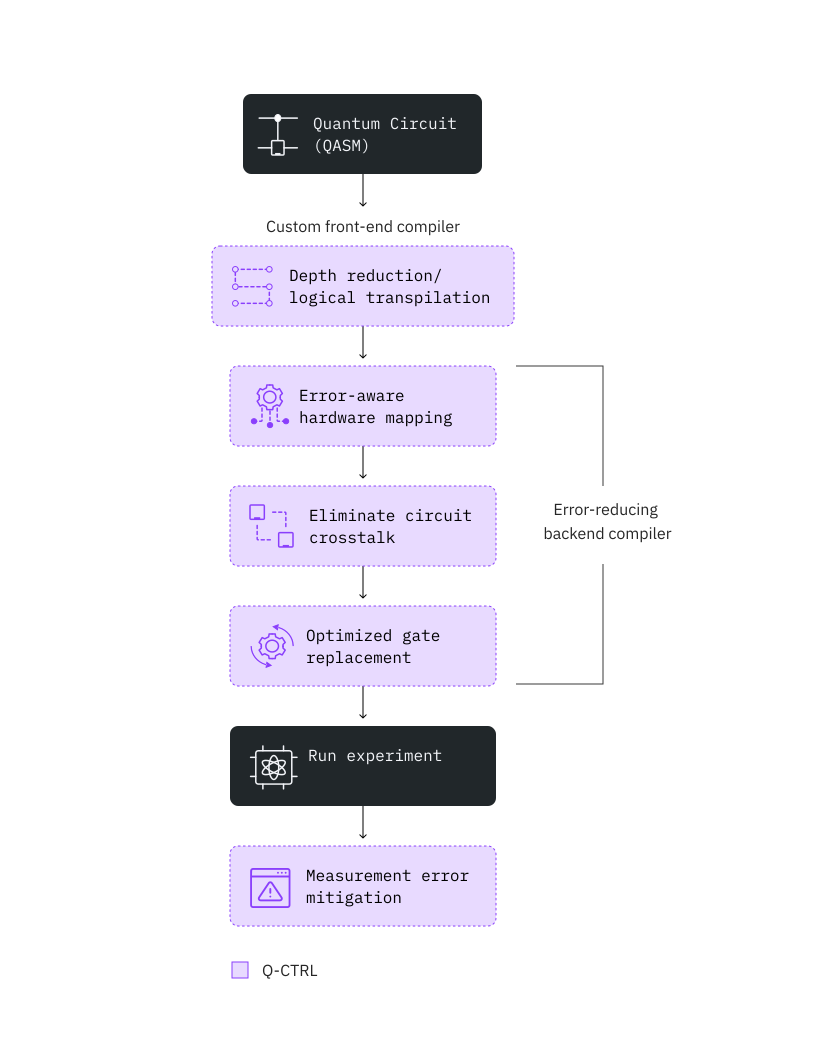
Per ridurre il rumore hardware, Fire Opal impiega una serie di tecniche di soppressione degli errori basate sull'IA, illustrate nell'immagine seguente. Con Fire Opal, l'intera pipeline è completamente automatizzata senza alcun bisogno di configurazione.
La pipeline di Fire Opal elimina la necessità di overhead aggiuntivo, come un maggiore tempo di esecuzione quantistica o qubit fisici extra. Tieni presente che il tempo di elaborazione classica rimane un fattore (consulta la sezione Benchmark per le stime, dove "Tempo totale" riflette sia l'elaborazione classica che quella quantistica). A differenza della mitigazione degli errori, che richiede overhead sotto forma di campionamento, la soppressione degli errori di Fire Opal opera sia a livello di gate che di impulso per affrontare le varie fonti di rumore e ridurre la probabilità che si verifichi un errore. Prevenendo gli errori, si elimina la necessità di una costosa fase di post-elaborazione.
L'immagine seguente illustra i metodi di soppressione degli errori automatizzati da Fire Opal Performance Management.
La funzione offre due primitive, Sampler ed Estimator, e gli input e output di entrambe estendono le specifiche implementate per le primitive IBM Quantum V2.
Benchmark
I risultati pubblicati di benchmark algoritmici dimostrano un miglioramento significativo delle prestazioni su vari algoritmi, tra cui Bernstein-Vazirani, quantum Fourier transform, ricerca di Grover, quantum approximate optimization algorithm e variational quantum eigensolver. Il resto di questa sezione fornisce ulteriori dettagli sui tipi di algoritmi che puoi eseguire, nonché sulle prestazioni e sui tempi di esecuzione previsti.
I seguenti studi indipendenti dimostrano come Performance Management di Q-CTRL abiliti la ricerca algoritmica su scala record:
- Parametrized Energy-Efficient Quantum Kernels for Network Service Fault Diagnosis - quantum kernel learning fino a 50 qubit
- Tensor-based quantum phase difference estimation for large-scale demonstration - quantum phase estimation fino a 33 qubit
- Hierarchical Learning for Quantum ML: Novel Training Technique for Large-Scale Variational Quantum Circuits - caricamento dati quantistico fino a 21 qubit
La tabella seguente fornisce una guida approssimativa su accuratezza e tempi di esecuzione da precedenti esecuzioni di benchmark su ibm_fez. Le prestazioni su altri dispositivi possono variare. Il tempo di utilizzo è basato su un'ipotesi di 10.000 shot per circuito. Il "Numero di qubit" indicato non rappresenta un limite rigido, ma soglie approssimative entro cui ci si può aspettare un'accuratezza della soluzione estremamente stabile. Problemi di dimensioni maggiori sono stati risolti con successo, e si incoraggia il test oltre questi limiti.
| Esempio | Numero di qubit | Accuratezza | Misura dell'accuratezza | Tempo totale (s) | Utilizzo runtime (s) | Primitiva (Modalità) |
|---|---|---|---|---|---|---|
| Bernstein–Vazirani | 50Q | 100% | Tasso di successo (percentuale di esecuzioni in cui la risposta corretta è la bitstring con il conteggio più alto) | 10 | 8 | Sampler |
| Quantum Fourier Transform | 30Q | 100% | Tasso di successo (percentuale di esecuzioni in cui la risposta corretta è la bitstring con il conteggio più alto) | 10 | 8 | Sampler |
| Quantum Phase Estimation | 30Q | 99,9998% | Accuratezza dell'angolo trovato: 1- abs(real_angle - angle_found)/pi | 10 | 8 | Sampler |
| Simulazione quantistica: modello di Ising (15 passi) | 20Q | 99,775% | (definito di seguito) | 60 (per passo) | 15 (per passo) | Estimator |
| Simulazione quantistica 2: dinamica molecolare (20 punti temporali) | 34Q | 96,78% | (definito di seguito) | 10 (per punto temporale) | 6 (per punto temporale) | Estimator |
Definizione dell'accuratezza della misura di un valore di aspettazione — la metrica è definita come segue:
dove = valore di aspettazione ideale, = valore di aspettazione misurato, = valore massimo ideale, e = valore minimo ideale. è semplicemente la media del valore di su più misurazioni.
Questa metrica viene utilizzata perché è invariante rispetto a traslazioni globali e ridimensionamenti nell'intervallo dei valori ottenibili. In altre parole, indipendentemente dal fatto che tu sposti l'intervallo dei possibili valori di aspettazione verso l'alto o verso il basso, o aumenti la dispersione, il valore di dovrebbe rimanere costante.
Inizia
Fire Opal Performance Management utilizza Qiskit v2.0.0, che è la versione consigliata. Le versioni supportate sono Qiskit >=v2.0.0.
Autenticati usando la tua chiave API di IBM Quantum Platform e seleziona la Qiskit Function come segue. (Questo snippet presuppone che tu abbia già salvato il tuo account nel tuo ambiente locale.)
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_catalog": "qiskit-ibm-catalog", "qiskit_ibm_runtime": "qiskit-ibm-runtime"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
# This cell is hidden from users. It hides the "...You have imported samplomatic..." warning.
import warnings

warnings.filterwarnings("ignore", message=".*You have imported samplomatic*")
from qiskit_ibm_catalog import QiskitFunctionsCatalog

catalog = QiskitFunctionsCatalog(channel="ibm_quantum_platform")

# verify that you have access to the function
catalog.list()
[QiskitFunction(qunova/hivqe-chemistry),
 QiskitFunction(global-data-quantum/quantum-portfolio-optimizer),
 QiskitFunction(algorithmiq/tem),
 QiskitFunction(qedma/qesem),
 QiskitFunction(multiverse/singularity),
 QiskitFunction(ibm/circuit-function),
 QiskitFunction(q-ctrl/optimization-solver),
 QiskitFunction(colibritd/quick-pde),
 QiskitFunction(q-ctrl/performance-management),
 QiskitFunction(kipu-quantum/iskay-quantum-optimizer)]
# Access Function
perf_mgmt = catalog.load("q-ctrl/performance-management")
Se vuoi usare un backend che questa funzione non supporta attualmente, contatta Q-CTRL per aggiungere supporto.
Primitiva Estimator
Esempio con Estimator
Usa la primitiva Estimator di Fire Opal Performance Management per determinare il valore di aspettazione di una coppia circuito-osservabile.
Oltre ai pacchetti qiskit-ibm-catalog e qiskit, utilizzerai anche il pacchetto numpy per eseguire questo esempio. Puoi installare questo pacchetto decommentando la cella seguente se stai eseguendo questo esempio in un notebook con il kernel IPython.
# %pip install numpy
1. Crea il circuito
Come esempio, genera un operatore Hermitiano casuale e un osservabile da passare alla funzione Performance Management.
import numpy as np
from qiskit.circuit.library import iqp
from qiskit.quantum_info import random_hermitian, SparsePauliOp

n_qubits = 50

# Generate a random circuit
mat = np.real(random_hermitian(n_qubits, seed=1234))
circuit = iqp(mat)
circuit.measure_all()

# Define observables as a string
observable = SparsePauliOp("Z" * n_qubits)
# Create PUB tuple
estimator_pubs = [(circuit, observable)]
2. Esegui il circuito
Esegui il circuito e, facoltativamente, definisci il backend e il numero di shot.
# This cell is hidden from users
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService()
backend_name = service.least_busy().name
# Run the circuit using Estimator
qctrl_estimator_job = perf_mgmt.run(
    primitive="estimator",
    pubs=estimator_pubs,
    backend_name=backend_name,
)
Puoi usare le familiari API Qiskit Serverless per verificare lo stato del tuo workload Qiskit Function:
qctrl_estimator_job.status()
'QUEUED'
3. Recupera il risultato
# Retrieve the counts from the result list
result = qctrl_estimator_job.result()
I risultati hanno lo stesso formato di un risultato Estimator:
import numpy

result_str = str(result)

with numpy.printoptions(threshold=200):
    print(
        f"The result of the submitted job had {len(result)} PUB "
        f"and has a value:\n {result[0]}\n"
    )

print("The associated PubResult of this job has the following DataBins:")
print(f"{result[0].data}\n")

print(f"And this DataBin has attributes: {result[0].data.keys()}")

print("The expectation values measured from this PUB are:")
print(f"{result[0].data.evs}")
The result of the submitted job had 1 PUB
The result of the submitted job had 1 PUB and has a value:
 PubResult(data=DataBin(evs=0.0195, stds=0.9998098569228051), metadata={'precision': None})

The associated PubResult of this job has the following DataBins:
DataBin(evs=0.0195, stds=0.9998098569228051)

And this DataBin has attributes: dict_keys(['evs', 'stds'])
The expectation values measured from this PUB are:
0.0195
Primitiva Sampler
Esempio con Sampler
Usa la primitiva Sampler di Fire Opal Performance Management per eseguire un circuito Bernstein–Vazirani. Questo algoritmo, usato per trovare una stringa nascosta dagli output di una funzione a scatola nera, è un comune algoritmo di benchmark perché ha un'unica risposta corretta. 1. Crea il circuito
Definisci la risposta corretta all'algoritmo, la bitstring nascosta e il circuito Bernstein–Vazirani. Puoi regolare la larghezza del circuito semplicemente modificando circuit_width.
import qiskit

circuit_width = 35
hidden_bitstring = "1" * circuit_width

# Create circuit, reserving one qubit for BV oracle
bv_circuit = qiskit.QuantumCircuit(circuit_width + 1, circuit_width)
bv_circuit.x(circuit_width)
bv_circuit.h(range(circuit_width + 1))
for input_qubit, bit in enumerate(reversed(hidden_bitstring)):
    if bit == "1":
        bv_circuit.cx(input_qubit, circuit_width)
bv_circuit.barrier()
bv_circuit.h(range(circuit_width + 1))
bv_circuit.barrier()
for input_qubit in range(circuit_width):
    bv_circuit.measure(input_qubit, input_qubit)

# Create PUB tuple
sampler_pubs = [(bv_circuit,)]
2. Esegui il circuito
Esegui il circuito e, facoltativamente, definisci il backend e il numero di shot.
# Run the circuit using Sampler
qctrl_sampler_job = perf_mgmt.run(
    primitive="sampler",
    pubs=sampler_pubs,
    backend_name=backend_name,
)
Controlla lo stato del workload della tua Qiskit Function o recupera i risultati come segue:
# Print the ID so you can use it later, if necessary
print(qctrl_sampler_job.job_id)

qctrl_sampler_job.status()
60fe2fa1-a860-43e4-8615-c6ac4180f93b
'QUEUED'
3. Recupera il risultato
# Retrieve the job results
sampler_result = qctrl_sampler_job.result()
# Get results for the first (and only) PUB
pub_result = sampler_result[0]
counts = pub_result.data.c.get_counts()

print("Counts for the meas output register (limited to 30 results):")
for i, (bitstring, count) in enumerate(counts.items()):
    if i >= 50:
        print(f"  ... ({len(counts) - 30} more items)")
        break
    print(f"  {bitstring}: {count}")
Counts for the meas output register (limited to 30 results):
  11111111111111111111111111111111111: 1661
  11111111111111111111111111110111111: 60
  11111111111111111111111111111101111: 54
  11111111111111111111111111111110111: 54
  11111111111111011111111111111111111: 46
  11111111111111111110111111111111111: 44
  11111111111111111111111101111111111: 42
  11111111111111111111111110111111111: 42
  11111111111111110111111111111111111: 41
  11111111111111111111111111111111101: 39
  11111111111111111111101111111111111: 38
  11111111111111111111110111111111111: 38
  11111111111111111111111111101111111: 37
  11111111111111111111111111111111110: 36
  11111111111110111111111111111111111: 35
  11111111111111111111111111111011111: 32
  11111111111111101111111111111111111: 32
  01111111111111111111111111111111111: 27
  11111111111111111011111111111111111: 23
  11111111101111111111111111111111111: 22
  11111111111111111111111111111111011: 21
  11111111011111111111111111111111111: 20
  00000000000000011111111111111111111: 18
  11111111111111111111110101111111111: 18
  00000001111111111111111111111111111: 17
  11111111001111111111111111111111111: 16
  11101111111111111111111111111111111: 16
  11111111111101111111111111111111111: 16
  00000101111111111111111111111111111: 13
  11111111111111111111111011111111111: 13
  11111111111111111111111110101111111: 13
  11111111111111111101111111111111111: 12
  10111111111111111111111111111111111: 12
  11111111111111111111111110001111111: 12
  00000000000000000011111111111111111: 11
  11111111111111111111111111111110110: 10
  00000000000000000000000001111111111: 10
  11111111111011111111111111111111111: 9
  11111111111111101011111111111111111: 9
  00000000011111111111111111111111111: 8
  10101111111111111111111111111111111: 8
  00000000000000000000000001011111111: 8
  11111111111111111111111111111111001: 8
  00000111111111111111111111111111111: 7
  11111111111111111111111111111101110: 7
  11111111110111111111111111111111111: 7
  00000000000001011111111111111111111: 6
  00000000000000001111111111111111111: 6
  00000000000000000001011111111111111: 6
  11111111111111111111111111011111111: 6
  ... (1050 more items)
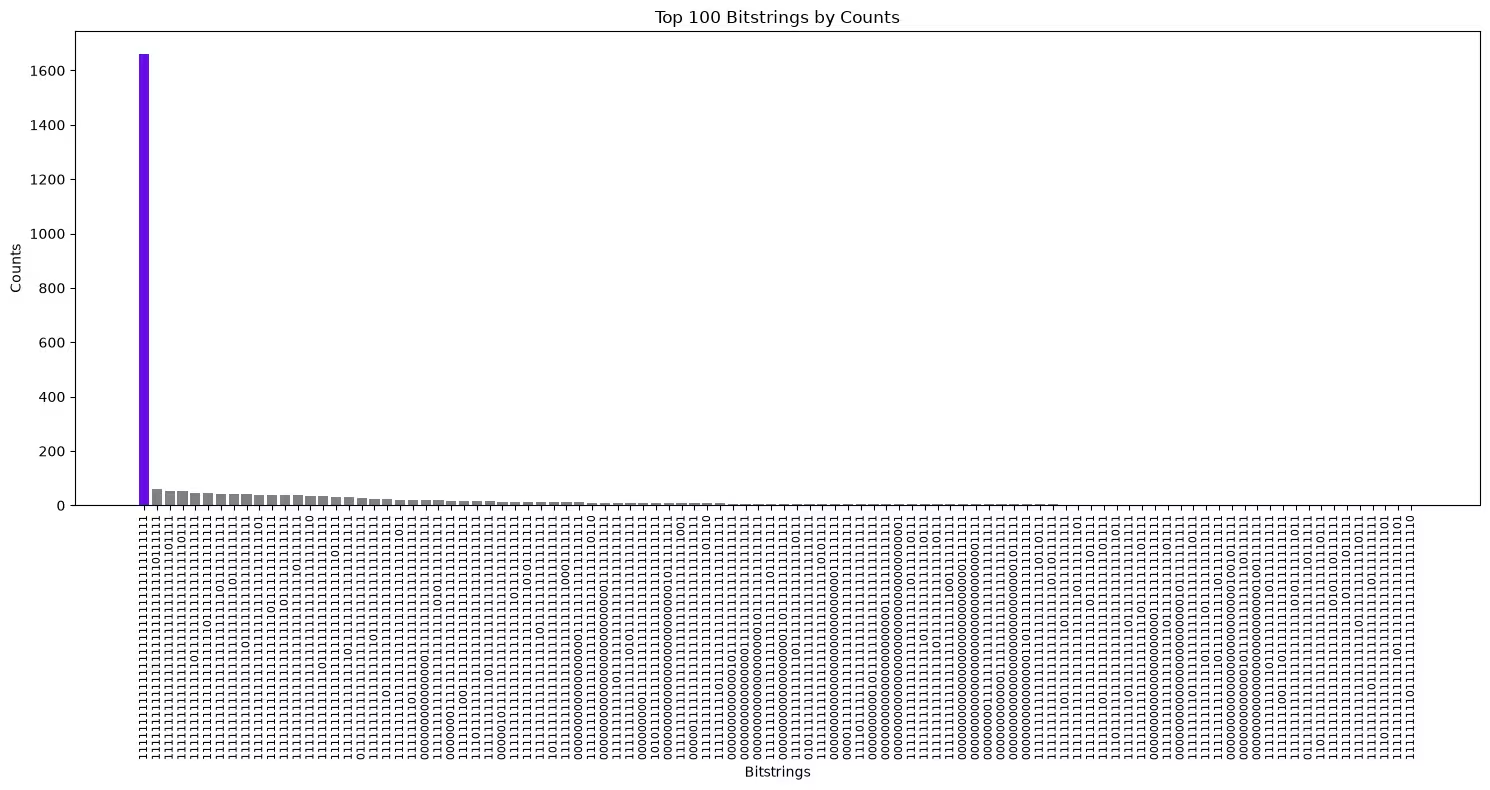
3. Visualizza le bitstring principali
Visualizza la bitstring con il conteggio più alto per verificare se la bitstring nascosta è la moda.
import matplotlib.pyplot as plt

def plot_top_bitstrings(counts_dict, hidden_bitstring=None):
    # Sort and take the top 100 bitstrings
    top_100 = sorted(counts_dict.items(), key=lambda x: x[1], reverse=True)[
        :100
    ]
    if not top_100:
        print("No bitstrings found in the input dictionary.")
        return

    # Unzip the bitstrings and their counts
    bitstrings, counts = zip(*top_100)

    # Assign colors: purple if the bitstring matches hidden_bitstring,
    # otherwise gray
    colors = [
        "#680CE9" if bit == hidden_bitstring else "gray" for bit in bitstrings
    ]

    # Create the bar plot
    plt.figure(figsize=(15, 8))
    plt.bar(
        range(len(bitstrings)), counts, tick_label=bitstrings, color=colors
    )

    # Rotate the bitstrings for better readability
    plt.xticks(rotation=90, fontsize=8)
    plt.xlabel("Bitstrings")
    plt.ylabel("Counts")
    plt.title("Top 100 Bitstrings by Counts")

    # Show the plot
    plt.tight_layout()
    plt.show()
La bitstring nascosta è evidenziata in viola e dovrebbe essere quella con il numero di conteggi più alto.
plot_top_bitstrings(counts, hidden_bitstring)
Registro delle modifiche
-
2026-02-20: Avviso di deprecazione - il campo di metadati
provider_job_idssarà deprecato tra 30 giorni nella versione 0.13.0. Gli utenti possono accedere all'ID del job tramite il metodojob_id()del runtime service. -
2026-02-11: È ora disponibile il supporto per
ibm_miami, e sono stati aggiunti metadati di esecuzione aPubResult.
Assistenza
Per qualsiasi domanda o problema, contatta Q-CTRL.
Passi successivi
-
Richiedi l'accesso a Q-CTRL Performance Management
-
Consulta il riferimento API per questa Qiskit Function.
-
Prova il tutorial Modello di Ising a Campo Trasversale con Performance Management di Q-CTRL.
-
Prova il tutorial Quantum Phase Estimation con le Qiskit Functions di Q-CTRL
-
Consulta il caso di studio Mitsubishi Chemical Corp.
-
Consulta il caso di studio della banca anonima.
-
Consulta il caso di studio BlueQubit.