Simulare la dinamica di Fermi-Hubbard 1D con i flow set
Le funzioni descritte in questa guida sono attualmente disponibili solo nell'API Python. Una funzionalità equivalente sarà resa disponibile nell'API C in una versione futura.
Questa guida costruisce un circuito per la dinamica temporale del modello di Fermi-Hubbard unidimensionale, dalla scrittura dell'Hamiltoniana fino alla verifica delle densità di sito evolute. Ciò che rende interessante questo percorso è una singola idea, tratta dal framework dei flow set di Gandon et al. [1], il lavoro che ha ispirato anche il TransferVertexOperator in questo pacchetto:
Invece di raggruppare i termini dell'Hamiltoniana dopo la mappatura da fermione a qubit, raggruppali prima, in flow set, sottoinsiemi unidimensionali del grafo di interazione fermionico orientato i cui operatori di trasferimento commutano a due a due.
Questa scelta guida tutto ciò che segue. Richiede quanto segue:
-
Una codifica personalizzata da fermione a qubit su misura per i flow set, che qui impiega un qubit ancilla così che il numero di qubit associato all'implementazione di un dato termine dell'Hamiltoniana non cresca più con il numero di modi fermionici (come accade con Jordan-Wigner (JW)).
-
Una sintesi personalizzata che sfrutta la commutatività all'interno di ciascun insieme. Il vantaggio è un circuito la cui profondità a due qubit è costante rispetto alla dimensione del sistema, contro la crescita lineare di una Trotterizzazione termine per termine basata su JW.
Il meccanismo che porta una tua codifica nel Transpiler (CustomF2QLayout e MapperFnEvolutionSynthesis) si applica a qualsiasi modello.
La guida alla transpilazione per gli stage del Transpiler citati in tutto il testo, e la guida ai mapper per la ricetta generale su come scrivere un mapper personalizzato.
Operatori di trasferimento e flow set
Un TransferVertexOperator è costruito a partire da operatori di vertice e operatori di trasferimento . In termini di operatori fermionici di creazione e annichilazione,
quindi misura l'occupazione del modo (vale quando è vuoto e quando è pieno), mentre trasferisce un fermione lungo l'arco orientato . Nota che i due indici di non sono intercambiabili. Il primo indice porta la combinazione con il segno meno e il secondo quella con il segno più, ed è ciò che rende distinto da e dà all'arco il suo orientamento.
Questi soddisfano relazioni di commutazione miste. Due operatori di trasferimento che agiscono su siti disgiunti commutano in modo banale, poiché ciascuno è un prodotto pari di operatori fermionici. Il caso interessante è quello di un sito condiviso. In tal caso, i due commutano se le frecce fluiscono attraverso quel sito (una arriva, una parte) e anticommutano se si scontrano (arrivano entrambe, o partono entrambe).
La regola si vede meglio in un'immagine. Disegnando i vertici come nodi e ogni come una freccia da a si ottiene il grafo di interazione orientato, qui per la catena di quattro siti usata in tutta questa guida, che porta entrambi gli orientamenti di ogni legame:

Segui la regola sulla figura. Guarda ad esempio e . Una freccia arriva al sito 2 e l'altra ne parte, quindi il fermione fluisce direttamente attraverso e i due operatori commutano. Guarda invece e . Entrambe le frecce puntano verso il sito 2. Si scontrano, e questi due anticommutano.
È ciò che rende possibili i flow set. Scegli un insieme di frecce che formano un cammino orientato e ogni coppia o si incontra testa-coda o non si incontra affatto, quindi l'intero insieme commuta, anche se i singoli operatori si sovrappongono su siti condivisi. Evolvere sotto un singolo flow set non comporta quindi alcun errore di Trotter, e come mostra il passo 7, può essere fatto anche a profondità di circuito costante.
1. L'Hamiltoniana di Fermi-Hubbard
Il modello di Fermi-Hubbard 1D su siti (senza spin, con bordi aperti) è
Seguendo l'Eq. (9) del Rif. [1], il termine di hopping è . L'interazione è diagonale, quindi si esprime tramite operatori di vertice usando :
Entrambe le parti sono costruite direttamente come TransferVertexOperator. Nota che è memorizzato come voce diagonale (j, j):
>>> from collections import defaultdict
>>> from qiskit_fermions.operators import TransferVertexOperator
>>>
>>> def fermi_hubbard_1d(num_sites, tunneling, interaction):
...     data: defaultdict[tuple[tuple[int, int], ...], complex] = defaultdict(complex)
...     for j in range(num_sites - 1):
...         k = j + 1
...         # hopping: -t (a^dag_j a_k + a^dag_k a_j) = t (T_jk + T_kj)
...         data[((j, k),)] += tunneling
...         data[((k, j),)] += tunneling
...         # interaction: U n_j n_k with n_j = (1 - V_j) / 2
...         data[()] += interaction / 4
...         data[((j, j),)] -= interaction / 4
...         data[((k, k),)] -= interaction / 4
...         data[((j, j), (k, k))] += interaction / 4
...     return TransferVertexOperator.from_dict(data)
>>>
>>> num_sites = 4
>>> hamiltonian = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
>>> print(format(hamiltonian))
  1.500000e0 +0.000000e0j * ()
-5.000000e-1 +0.000000e0j * (V(0))
 5.000000e-1 +0.000000e0j * (V(0) V(1))
  1.000000e0 +0.000000e0j * (T(0,1))
  1.000000e0 +0.000000e0j * (T(1,0))
 -1.000000e0 +0.000000e0j * (V(1))
 5.000000e-1 +0.000000e0j * (V(1) V(2))
  1.000000e0 +0.000000e0j * (T(1,2))
  1.000000e0 +0.000000e0j * (T(2,1))
 -1.000000e0 +0.000000e0j * (V(2))
 5.000000e-1 +0.000000e0j * (V(2) V(3))
  1.000000e0 +0.000000e0j * (T(2,3))
  1.000000e0 +0.000000e0j * (T(3,2))
-5.000000e-1 +0.000000e0j * (V(3))
I siti interni ottengono un coefficiente di su perché compaiono in due legami, mentre i siti di bordo compaiono in uno solo. Ogni termine elencato qui compare nel grafo disegnato sopra. I termini T(j,k) sono le sue frecce e i termini V(j) i suoi nodi.
2. Partizionare in flow set
Poi, etichetta ogni termine con il flow set a cui appartiene. L'attributo groups esiste a questo scopo. Un Gate Evolution su un operatore raggruppato si scompone in un Evolution per ogni gruppo (il passo 6 lo mette in pratica), quindi il raggruppamento deciso qui a livello fermionico sopravvive nel circuito.
Per la catena 1D, i due flow set di hopping sono le frecce orientate a est () e quelle orientate a ovest (). I termini di interazione diagonali commutano con tutto ciò che è diagonale e formano un terzo gruppo:
>>> def flow_set_groups(operator):
...     groups = []
...     for terms, _ in operator.iter_terms():
...         match terms:
...             case [(left, right)] if right == left + 1:
...                 groups.append(0)  # east-oriented: T_{j,j+1}
...             case [(left, right)] if right == left - 1:
...                 groups.append(1)  # west-oriented: T_{j+1,j}
...             case _:
...                 groups.append(2)  # diagonal interaction terms
...     return groups
>>>
>>> hamiltonian.groups = flow_set_groups(hamiltonian)
>>> hamiltonian.num_groups()
3
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(index, sorted(terms for terms, _ in group.iter_terms()))
0 [[(0, 1)], [(1, 2)], [(2, 3)]]
1 [[(1, 0)], [(2, 1)], [(3, 2)]]
2 [[], [(0, 0)], [(0, 0), (1, 1)], [(1, 1)], [(1, 1), (2, 2)], [(2, 2)], [(2, 2), (3, 3)], [(3, 3)]]
I gruppi 0 e 1 sono i due flow set. Ciascun insieme è un cammino orientato lungo la catena, quindi per la proprietà di flusso tutti i termini all'interno di un gruppo commutano.
Ogni gruppo deve inoltre essere hermitiano di per sé, poiché una formula di prodotto esponenzia i gruppi separatamente e solo un fattore hermitiano ha un'evoluzione unitaria. groups_are_hermitian() lo conferma:
>>> from qiskit_fermions.operators.terms.grouping import groups_are_hermitian
>>>
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Vale la pena soffermarsi su questo punto, perché i due gruppi di hopping sono unidirezionali: il gruppo 0 contiene solo termini orientati a est e il gruppo 1 solo termini orientati a ovest. Dividere così un'Hamiltoniana normalmente romperebbe l'hermiticità, poiché richiede accanto a sé il suo partner coniugato . Un TransferVertexOperator evita il problema perché è già hermitiano di per sé. È un prodotto di due operatori di Majorana (vedi la sua definizione al passo 1), non un semplice , quindi la sua immagine di Jordan-Wigner porta un coefficiente reale anziché immaginario. Scegliere questa rappresentazione dell'operatore è quindi ciò che rende un flow set unidirezionale un fattore di Trotter legittimo.
Le etichette est/ovest usate in questa guida sono geometriche, con la catena disegnata da sinistra a destra e gli indici dei modi crescenti in quella direzione; punta a est e punta a ovest. Il Rif. [1] è internamente incoerente su questa denominazione (il testo e le figure non concordano), quindi questa guida deliberatamente non segue il testo e mantiene invece le etichette della figura. Quando confronti con l'articolo, abbina i flow set in base ai loro pesi di Pauli (1 e 3 più avanti), non in base ai punti cardinali.
3. Scrivere la codifica personalizzata
La Sezione IV B del Rif. [1] classifica le forme che una codifica locale da fermione a qubit può assumere quando è ristretta a un flow set. Il semplice Jordan-Wigner usa qubit e mappa ogni termine di hopping in un Pauli di peso 2. La classificazione mostra che spendere qubit extra compra struttura negli operatori codificati.
La codifica qui implementata è la costruzione a parità delocalizzata dell'Appendice B 2 (equazioni B4 e B5), che usa un qubit ancilla, quindi . La parità fermionica è delocalizzata su una coppia di qubit:
L'indice nell'ultima espressione rende necessario il qubit extra. L'ultimo legame della catena ha , quindi il suo cade sul qubit , uno oltre l'ultimo modo fermionico . Quel qubit finale è l'ancilla, ed è il motivo per cui anziché . La stessa portata compare in , il cui è sull'ancilla per .
Il vantaggio è subito visibile: un intero flow set viene mappato in una somma di Pauli di peso 1.
I prefattori sono fissati dalla normalizzazione , e il segno meno relativo tra i due orientamenti è fissato dall'identità di prodotto , che i Pauli qui sopra soddisfano. Sbagliare uno dei due produce un operatore che obbedisce alle relazioni di commutazione ma non rappresenta più la stessa Hamiltoniana, quindi dovresti verificare numericamente la codifica, come mostrato al passo 4.
Scrivere la codifica significa scrivere una funzione che mappa un singolo operatore di trasferimento generalizzato in una stringa di Pauli; map_transfer_vertex_generators() gestisce l'iterazione sui termini e la loro composizione:
>>> from qiskit.quantum_info import SparseObservable
>>> from qiskit_fermions.mappers import map_transfer_vertex_generators
>>>
>>> def flow_set_action(action, num_qubits):
...     match action:
...         case (j, k) if j == k:
...             # vertex operator: V_j = Z_j Z_{j+1}
...             return SparseObservable.from_sparse_list(
...                 [("ZZ", [j, j + 1], 1.0)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j + 1:
...             # east-oriented transfer operator: weight 1
...             return SparseObservable.from_sparse_list(
...                 [("X", [k], -0.5)], num_qubits=num_qubits
...             )
...         case (j, k) if k == j - 1:
...             # west-oriented transfer operator: weight 3
...             return SparseObservable.from_sparse_list(
...                 [("ZXZ", [k, k + 1, k + 2], 0.5)], num_qubits=num_qubits
...             )
...         case _:
...             raise ValueError(f"not a nearest-neighbor transfer operator: {action}")
>>>
>>> def flow_set_encoding(operator, num_qubits):
...     return map_transfer_vertex_generators(
...         operator,
...         lambda action: flow_set_action(action, num_qubits),
...         identity=lambda: SparseObservable.identity(num_qubits),
...         compose=SparseObservable.compose,
...     ).simplify()
MapperFnEvolutionSynthesis.mapper_fn si aspetta la firma (operator, num_qubits), e il tipo restituito deve essere un SparseObservable, che rende la funzione direttamente utilizzabile come plugin del Transpiler. Vedi il passo 6.
Applicandola all'Hamiltoniana del passo 1 si ottiene l'operatore codificato su qubit:
>>> num_qubits = num_sites + 1
>>> encoded = flow_set_encoding(hamiltonian, num_qubits)
>>> for label, indices, coeff in sorted(encoded.to_sparse_list()):
...     print(f"{label:3s} {str(indices):12s} {coeff.real:+.2f}")
    []           +1.50
X   [1]          -0.50
X   [2]          -0.50
X   [3]          -0.50
ZXZ [0, 1, 2]    +0.50
ZXZ [1, 2, 3]    +0.50
ZXZ [2, 3, 4]    +0.50
ZZ  [0, 1]       -0.50
ZZ  [0, 2]       +0.50
ZZ  [1, 2]       -1.00
ZZ  [1, 3]       +0.50
ZZ  [2, 3]       -1.00
ZZ  [2, 4]       +0.50
ZZ  [3, 4]       -0.50
Ci sono 14 termini, in tre forme: l'hopping è diventato X e ZXZ, l'interazione ZZ, e il [] iniziale è l'identità, che contribuisce solo con una fase globale. Nota che i termini ZZ raggiungono i primi e i secondi vicini; copre i qubit da a , che è il costo della delocalizzazione della parità.
Raggruppare per flow set mette in luce l'asimmetria che la costruzione procura. Elenca i pesi di Pauli presenti in ciascun gruppo:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     weights = {len(indices) for _, indices, _ in flow_set_encoding(group, num_qubits).to_sparse_list()}
...     print(index, sorted(weights))
0 [1]
1 [3]
2 [0, 2]
Il flow set orientato a est (gruppo 0) è composto interamente da Pauli di peso 1. La sua evoluzione temporale è quindi uno strato di rotazioni a singolo qubit e non richiede Gate di entanglement, mentre con Jordan-Wigner ogni termine di hopping ha peso 2 e li richiede. È il compromesso spazio-tempo del Rif. [1] nella sua forma più semplice: un qubit in più converte metà dell'Hamiltoniana di hopping in rotazioni a singolo qubit.
Il flow set orientato a ovest (gruppo 1) lo paga al peso tre, e l'interazione (gruppo 2) si colloca al peso due, dove la voce di peso zero è l'identità. Niente di tutto ciò è ancora un'affermazione su un circuito; ciò che una sintesi ricava da questi pesi è l'argomento dei passi 6 e 7.
4. Verificare la codifica
Una codifica personalizzata è utile solo se è fedele, e una scritta a mano va verificata. Poiché questa codifica usa qubit, lo spazio di Hilbert dei qubit è grande il doppio di quello fermionico, quindi l'Hamiltoniana codificata non può essere uguale a quella di Jordan-Wigner termine per termine. Le due sono invece legate da un'isometria.
Da dove viene l'isometria: In Jordan-Wigner uno stato di base è la stringa di occupazione; il qubit contiene . Questa codifica memorizza invece le parità cumulative. Definisci
così il bit registra la parità di tutte le occupazioni fino al sito incluso. Ci sono bit di questo tipo per occupazioni, ed è da qui che viene l'ancilla. L'occupazione si recupera come differenza tra bit vicini, . Un sito occupato compare quindi come una parete di dominio tra due bit adiacenti, ed è per questo che si chiama codifica a parete di dominio (o di Kramers-Wannier). È anche il motivo per cui : il prodotto di due vicini legge quella differenza.
Scrivere esplicitamente questa mappa per alcuni stati rende concreta la struttura (nota che è fissato, quindi solo metà dei stati di qubit appartiene all'immagine, e quindi si tratta di un'isometria e non di un'unitaria):
>>> def domain_wall_bits(occupations):
...     parity = 0
...     bits = [0]
...     for occupation in occupations:
...         parity ^= occupation
...         bits.append(parity)
...     return bits
>>>
>>> for occupations in ([0, 0, 0, 0], [1, 0, 0, 0], [1, 1, 0, 0], [1, 0, 1, 0]):
...     bits = domain_wall_bits(occupations)
...     # little-endian: reversed() prints qubit 0 on the right, as Qiskit labels do
...     print("".join(map(str, occupations)), "->", "".join(str(b) for b in reversed(bits)))
0000 -> 00000
1000 -> 11110
1100 -> 00010
1010 -> 00110
Un singolo fermione sul sito 0 inverte ogni parità cumulativa al di sopra di esso, ed è questa la delocalizzazione in azione. Raccogliendo queste colonne in una matrice si ottiene l'isometria , e la codifica è fedele quando intreccia i due Hamiltoniani:
Cioè, mappare uno stato fermionico nello spazio dei qubit e poi farlo evolvere lì deve dare lo stesso risultato che farlo prima evolvere nello spazio fermionico e mappare dopo.
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp
>>> from qiskit_fermions.mappers.library import transfer_vertex_jordan_wigner
>>>
>>> def to_matrix(observable):
...     # SparseObservable carries no dense-matrix method, so route through
...     # SparsePauliOp. This is only ever needed for the checks below --
...     # the encoding itself never leaves SparseObservable.
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix()
>>>
>>> def domain_wall_isometry(num_sites):
...     isometry = np.zeros((2 ** (num_sites + 1), 2**num_sites), dtype=complex)
...     for index in range(2**num_sites):
...         occupations = [(index >> j) & 1 for j in range(num_sites)]
...         bits = domain_wall_bits(occupations)
...         isometry[sum(b << j for j, b in enumerate(bits)), index] = 1.0
...     return isometry
>>>
>>> isometry = domain_wall_isometry(num_sites)
>>> np.allclose(isometry.conj().T @ isometry, np.eye(2**num_sites))
True
>>>
>>> def intertwines(operator):
...     """Whether both mappings of `operator` agree through the isometry."""
...     flow = to_matrix(flow_set_encoding(operator, num_qubits))
...     reference = to_matrix(transfer_vertex_jordan_wigner(operator, num_sites).simplify())
...     return np.allclose(flow @ isometry, isometry @ reference)
>>>
>>> intertwines(hamiltonian)
True
>>> # and, more strongly, once per flow set: a product formula evolves the groups
>>> # separately, so each one has to be intertwined on its own
>>> all(intertwines(group) for group in hamiltonian.split_out_groups())
True
La relazione di intreccio vale esattamente, e separatamente per ciascun flow set. Questa seconda affermazione, più forte, è quella su cui si basano i passaggi successivi: una formula di prodotto fa evolvere i gruppi uno alla volta, e un prodotto di fattori intrecciati è a sua volta intrecciato, quindi qualsiasi approssimazione costruita a partire da questi gruppi coincide tra le due codifiche anche se le codifiche differiscono. Come corollario, gli spettri devono coincidere, con ogni autovalore di Jordan-Wigner che compare due volte nello spazio più grande, una volta per ciascun valore della parità globale non vincolata:
>>> jw_matrix = to_matrix(transfer_vertex_jordan_wigner(hamiltonian, num_sites).simplify())
>>> flow_matrix = to_matrix(flow_set_encoding(hamiltonian, num_qubits))
>>>
>>> jw_spectrum = np.linalg.eigvalsh(jw_matrix)
>>> flow_spectrum = np.linalg.eigvalsh(flow_matrix)
>>> np.allclose(
...     np.sort(flow_spectrum),
...     np.sort(np.concatenate([jw_spectrum, jw_spectrum])),
... )
True
>>> print(f"{jw_spectrum[0]:.10f}  {flow_spectrum[0]:.10f}")
-1.8557725066  -1.8557725066
5. Costruisci il circuito fermionico
Prima di coinvolgere qualsiasi qubit, la dinamica viene espressa a livello fermionico. Un FermionicCircuit agisce su modi fermionici anziché su qubit, e un gate Evolution sull'Hamiltoniano costituisce l'intero circuito:
>>> from qiskit_fermions.circuit import FermionicCircuit
>>> from qiskit_fermions.circuit.library import Evolution
>>> from qiskit_fermions.circuit.library.synthesis import FermionicLieTrotter
>>>
>>> total_time = 1.0
>>> circuit = FermionicCircuit(num_sites)
>>> circuit.append(
...     Evolution(
...         num_sites, hamiltonian, time=total_time, synthesis=FermionicLieTrotter()
...     ),
...     circuit.modes,
... )
>>> circuit.draw("mpl")
<Figure size ... with 1 Axes>

C'è una sola scatola opaca su tutti e quattro i modi, e la parte interessante è ciò in cui si scompone. L'argomento synthesis indica come: FermionicLieTrotter è la formula di prodotto del primo ordine, che divide l'operatore in base ai suoi groups e fa evolvere ciascun gruppo a turno. Quindi la partizione in flow set del passaggio 2 è la trotterizzazione, e un singolo decompose() la esegue, dando un Evolution per flow set nell'ordine dei gruppi: est, ovest, poi l'interazione diagonale, con rispettivamente 3, 3 e 8 termini.
>>> flow_set_circuit = circuit.decompose()
>>> flow_set_circuit.draw("mpl")
<Figure size ... with 1 Axes>
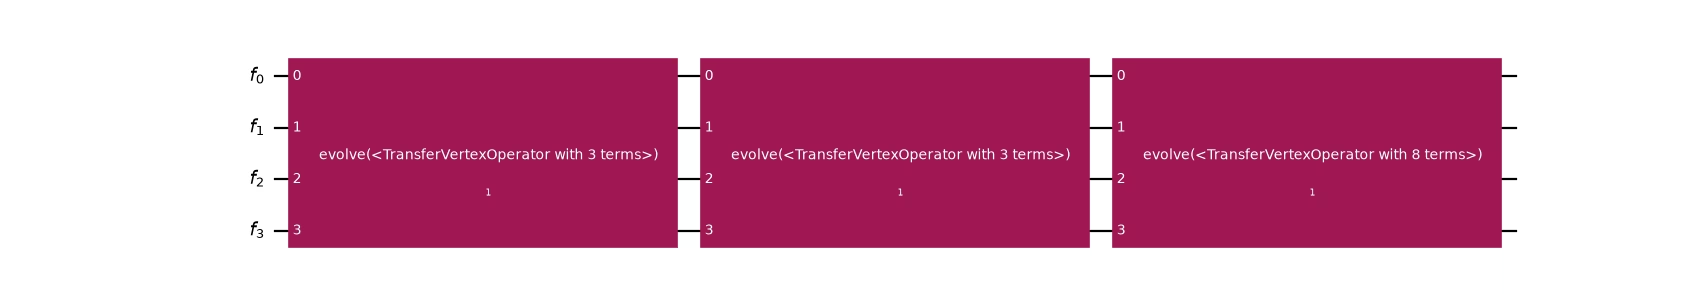
Nota che tutto ciò avviene interamente nello spazio fermionico: non è ancora stato menzionato alcun qubit, e l'approssimazione è già stata fatta. Anche il numero di passi di Trotter appartiene quindi a questo livello, come reps, che divide il tempo e ripete l'intera sequenza:
>>> def trotter_steps(reps):
...     step = FermionicCircuit(num_sites)
...     step.append(
...         Evolution(
...             num_sites,
...             hamiltonian,
...             time=total_time,
...             synthesis=FermionicLieTrotter(reps=reps),
...         ),
...         step.modes,
...     )
...     return step.decompose()
>>>
>>> trotter_steps(3).count_ops()["Evolution"]
9
Nove gate: i tre flow set, ripetuti ciclicamente tre volte, ciascuna con un terzo del tempo. È questo ciclo a farne una trotterizzazione anziché una semplice suddivisione di un solo gruppo. Ripetere un singolo gruppo non otterrebbe nulla, poiché esponenziali consecutive dello stesso operatore commutano, quindi A(t/3) A(t/3) A(t/3) è semplicemente A(t). Una formula che legge i gruppi può intercalarli; una applicata dopo la mappatura non può, perché a quel punto il raggruppamento è andato perso.
Questo è il passaggio che rende rilevante il raggruppamento. Ogni gate emesso viene mappato e sintetizzato in modo indipendente, quindi tutto ciò che segue agisce sulla partizione decisa a livello fermionico. Saltare la decomposizione consegna l'intero operatore alla fase successiva, e il raggruppamento viene ignorato.
6. Esegui il transpile con la codifica personalizzata
La codifica è ora pronta per essere usata dal Transpiler. Servono ancora due elementi:
-
Un layout. Il
TrivialF2QLayoutpredefinito presuppone un qubit per modo, il che è sbagliato in questa situazione.CustomF2QLayoutassocia il registro fermionico a unQuantumRegisterdi dimensione diversa, ed è così che i qubit ancilla entrano nella pipeline. -
Un plugin di sintesi.
MapperFnEvolutionSynthesisprende direttamente la funzione mapper, mappa con essa l'Hamiltoniano del gateEvolutioned emette unPauliEvolutionGate, preservando la convenzione . Il suoproduct_formuladecide come quel gate viene trasformato in rotazioni. Nota che questa è una seconda formula di prodotto, indipendente, che agisce sui qubit dopo la mappatura: qui viene passatoLieTrotterdi Qiskit, e il passaggio 7 lo sostituisce con uno che conosce i flow set.
Poiché ogni confronto che segue riesegue questa pipeline, conviene incapsularla una volta sola:
>>> from qiskit.circuit import QuantumRegister
>>> from qiskit.passmanager import MultiStagePassManager
>>> from qiskit_fermions.transpiler import FermionicCircuitToDAG, QuantumDAGToCircuit
>>> from qiskit_fermions.transpiler.passes import (
...     CustomF2QLayout,
...     F2QSynthesis,
...     MapperFnEvolutionSynthesis,
... )
>>>
>>> def flow_set_pass_manager(mode_register, product_formula=None):
...     '''Build the pipeline mapping `mode_register` with the flow-set encoding.'''
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         flow_set_encoding, product_formula=product_formula
...     )
...     # this encoding spends one ancilla on top of the fermionic modes
...     qubit_register = QuantumRegister(mode_register.size + 1, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from qiskit.synthesis import LieTrotter
>>>
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, LieTrotter())
>>> qubit_circuit = pass_manager.run(flow_set_circuit)
>>> qubit_circuit.num_qubits
5
Quattro modi fermionici sono diventati un circuito a cinque qubit, con l'ancilla fornita dal layout personalizzato.
Ora osserva cosa contiene effettivamente il circuito risultante. Decomporre ripetutamente riduce i gate di evoluzione fino a U e CX, in modo che il costo a due qubit delle due strategie di sintesi confrontate sotto sia misurato con la stessa unità: count_ops() riporta quindi il numero di CX, e depth() accetta una funzione filtro per misurare la profondità a due qubit. Nota che questo reps è una profondità di decomposizione, non correlata al numero di passi di Trotter di una formula di prodotto, che più avanti in questa guida si chiama anch'esso reps:
>>> decomposed = qubit_circuit.decompose(reps=6)
>>> decomposed.count_ops()["cx"]
26
>>> decomposed.depth(lambda instruction: len(instruction.qubits) == 2)
23
Ventisei gate CX in ventitré livelli, quindi quasi nulla viene eseguito in parallelo. Disegnare il circuito mostra perché:
>>> decomposed.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
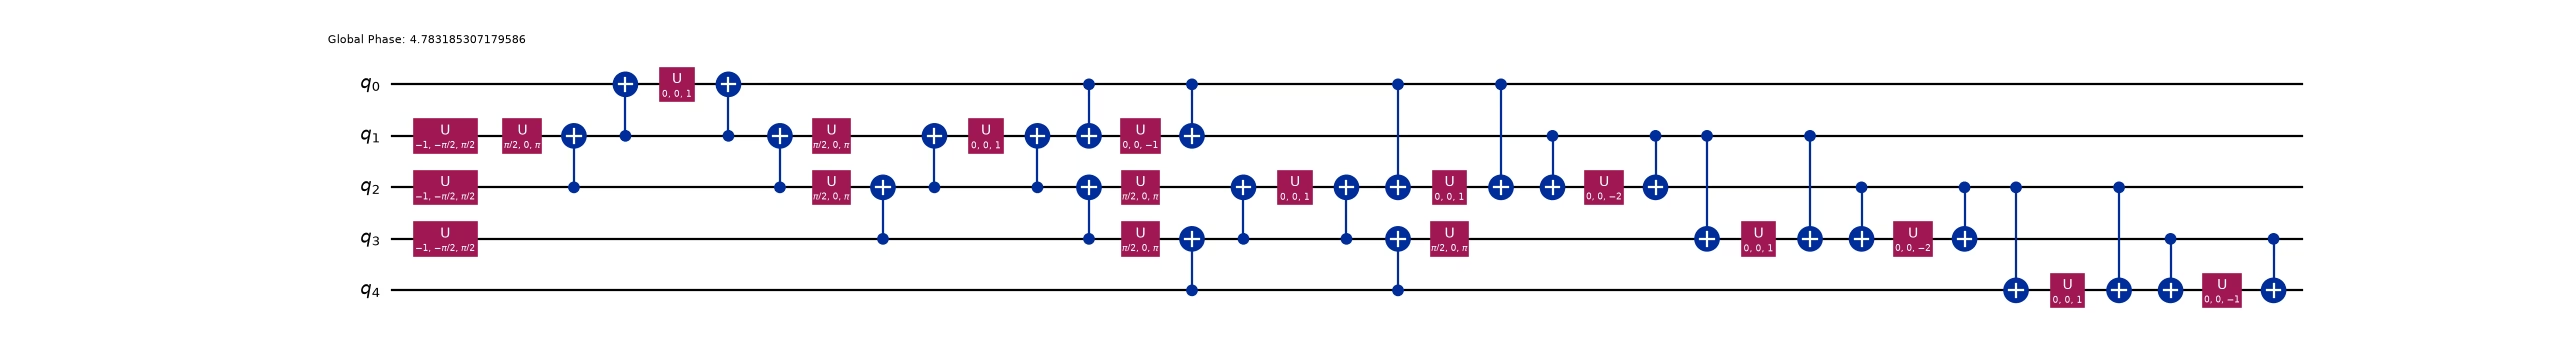
Ogni termine è stato compilato isolatamente: un cambio di base, una scala di CX fino a una singola rotazione, poi la scala viene annullata. Il flow set di peso 1 è gratuito; i suoi termini sono rotazioni isolate senza scala attorno, ma ogni termine di peso 3 costa quattro gate CX, e poiché le scale vengono emesse in sequenza, nulla si sovrappone.
Quindi il raggruppamento sopravvive all'intera pipeline (tre flow set, tre PauliEvolutionGate mappati) e tuttavia non fa guadagnare quasi nulla. La trotterizzazione fermionica del passaggio 5 ha svolto il suo compito; ciò che la vanifica è la formula sul lato dei qubit. LieTrotter riceve un insieme di termini di cui, per com'è fatto, non sa nulla, e compila ciascuno isolatamente. Non può sapere che commutano tutti tra loro, quindi serializza ciò che potrebbe condividere un cambio di base.
Questo è il divario che questa codifica esiste per colmare: sono all'opera due formule di prodotto, e finora solo quella fermionica ha ricevuto la struttura. Il passaggio successivo fornisce una sintesi lato qubit che la sfrutta a sua volta.
7. Una sintesi consapevole dei flow set
Recuperare il vantaggio significa comunicare la struttura alla sintesi lato qubit. Questa è la Sezione IV C del rif. [1]: poiché tutti i termini di un flow set commutano, possono essere diagonalizzati simultaneamente da un unico circuito di Clifford, ruotati in una base condivisa e ruotati indietro, anziché una volta per termine.
Per questa codifica, il Clifford è semplice. Coniugare con una catena di gate CZ tra primi vicini mappa
simultaneamente per ogni . Una catena di CZ trasforma l'intero flow set di peso 3 (ovest) in uno strato di rotazioni indipendenti su singolo qubit. L'interfaccia EvolutionSynthesis richiede soltanto un metodo synthesize(), ed è tutto ciò che questa classe implementa. Non ha un numero di passi di Trotter, perché riceve un flow set alla volta e quindi non può suddividere l'evoluzione tra gli insiemi. Questa suddivisione appartiene a un livello superiore, nello spazio fermionico, dove un F2FSynthesisPlugin li vede tutti insieme (vedi il passaggio 9):
>>> from qiskit.circuit import QuantumCircuit
>>> from qiskit.synthesis.evolution import EvolutionSynthesis
>>>
>>> def cz_brickwork(circuit):
...     # emit even and odd bonds as two layers, so the CZs are scheduled in
...     # parallel: a chain of overlapping CZs has depth 2, not num_qubits - 1
...     #
...     # NOTE: CZ gates are diagonal, so they all commute and each is its own inverse.
...     # This whole layer is therefore self-inverse, which is why the conjugation below
...     # calls it twice rather than calling it and then its inverse.
...     for offset in (0, 1):
...         for j in range(offset, circuit.num_qubits - 1, 2):
...             circuit.cz(j, j + 1)
>>>
>>> # The interaction reaches nearest (distance 1) and next-nearest (distance 2)
>>> # neighbors, so every interior qubit carries four Rzz gates and can only do one at
>>> # a time: four layers is the best any schedule can do. These offsets achieve it.
>>> def rzz_layers(circuit, angles):
...     """Emit the diagonal Rzz gates in four layers of disjoint qubit pairs."""
...     near = [(j, k) for j, k in angles if k - j == 1]
...     far = [(j, k) for j, k in angles if k - j == 2]
...     schedule = [
...         [(j, k) for j, k in near if j % 2 == 0],
...         [(j, k) for j, k in far if j % 4 in (0, 1)],
...         [(j, k) for j, k in near if j % 2 == 1],
...         [(j, k) for j, k in far if j % 4 in (2, 3)],
...     ]
...     # emit layer by layer, since Qiskit's depth follows the order gates were added
...     for layer in schedule:
...         for j, k in layer:
...             circuit.rzz(angles[j, k], j, k)
>>>
>>> class FlowSetSynthesis(EvolutionSynthesis):
...     '''Synthesize one flow set of the encoded Hamiltonian at a time.'''
...
...     preserve_order = True
...
...     def synthesize(self, evolution):
...         circuit = QuantumCircuit(evolution.operator.num_qubits)
...         east, west, diagonal = [], [], {}
...
...         for label, indices, coeff in evolution.operator.to_sparse_list():
...             angle = 2 * evolution.time * coeff.real
...             match label, indices:
...                 case "", _:  # the identity contributes only a global phase
...                     circuit.global_phase -= angle / 2
...                 case "X", [qubit]:  # east flow set: already weight-1
...                     east.append((qubit, angle))
...                 case "ZXZ", [j, k, l] if (k, l) == (j + 1, j + 2):
...                     west.append((k, angle))  # needs the CZ conjugation below
...                 case "ZZ", [j, k]:  # interaction: diagonal, see rzz_layers above
...                     diagonal[min(j, k), max(j, k)] = angle
...                 case _:
...                     raise ValueError(f"unexpected Pauli term: {label} on {indices}")
...
...         # east flow set: bare rotations, no entangling gates at all
...         for qubit, angle in east:
...             circuit.rx(angle, qubit)
...
...         # west flow set: one CZ chain diagonalizes the WHOLE set at once
...         if west:
...             cz_brickwork(circuit)
...             for qubit, angle in west:
...                 circuit.rx(angle, qubit)
...             cz_brickwork(circuit)
...
...         if diagonal:
...             rzz_layers(circuit, diagonal)
...
...         return circuit
Due dettagli sono facili da trascurare. Un EvolutionSynthesis personalizzato deve esporre un attributo preserve_order, che viene letto dal pass di high-level synthesis.
Entrambi gli helper emettono i loro gate in strati espliciti anziché nell'ordine dei termini, perché depth() pianifica i gate il prima possibile, nell'ordine in cui sono stati aggiunti. Poiché tutti i gate all'interno di uno di questi insiemi commutano, l'ordine è libero. Una sintesi termine per termine sceglie male l'ordine. Emettere in sequenza la catena di CZ sovrapposti riporta una profondità che cresce con il numero di qubit anziché la costante 2 che l'hardware potrebbe raggiungere.
Per questo la sintesi sopra non ha un numero di passi di Trotter. Riceve un flow set per gate, quindi una ripetizione al suo interno ripeterebbe dentro un insieme anziché alternare tra di essi:
repeating within one set:      A(t/2) A(t/2) B(t/2) B(t/2)
what a Trotterization needs:   A(t/2) B(t/2) A(t/2) B(t/2)
La prima forma non fa guadagnare nulla: esponenziali consecutive dello stesso operatore commutano, quindi A(t/2) A(t/2) è semplicemente A(t) e l'errore resta al valore di un solo passo, per quanti passi vengano richiesti.
Il numero di passi appartiene quindi al FermionicLieTrotter fermionico del passaggio 5, che legge i groups e può intercalarli. Questa divisione dei compiti è il punto chiave: la formula fermionica decide quanti passi e in che ordine, e questa classe decide con quanta economia viene realizzato ciascun insieme risultante.
Per selezionare l'ordine, passalo a MapperFnEvolutionSynthesis.product_formula, che è l'argomento che flow_set_pass_manager accetta. Nient'altro nella pipeline (o nel circuito fermionico su cui opera) cambia:
>>> pass_manager = flow_set_pass_manager(flow_set_circuit.register, FlowSetSynthesis())
>>>
>>> flow_circuit = pass_manager.run(flow_set_circuit).decompose(reps=6)
>>> flow_circuit.count_ops()["cx"]
22
>>> flow_circuit.depth(lambda instruction: len(instruction.qubits) == 2)
12
>>> flow_circuit.draw("mpl", fold=-1)
<Figure size ... with 1 Axes>
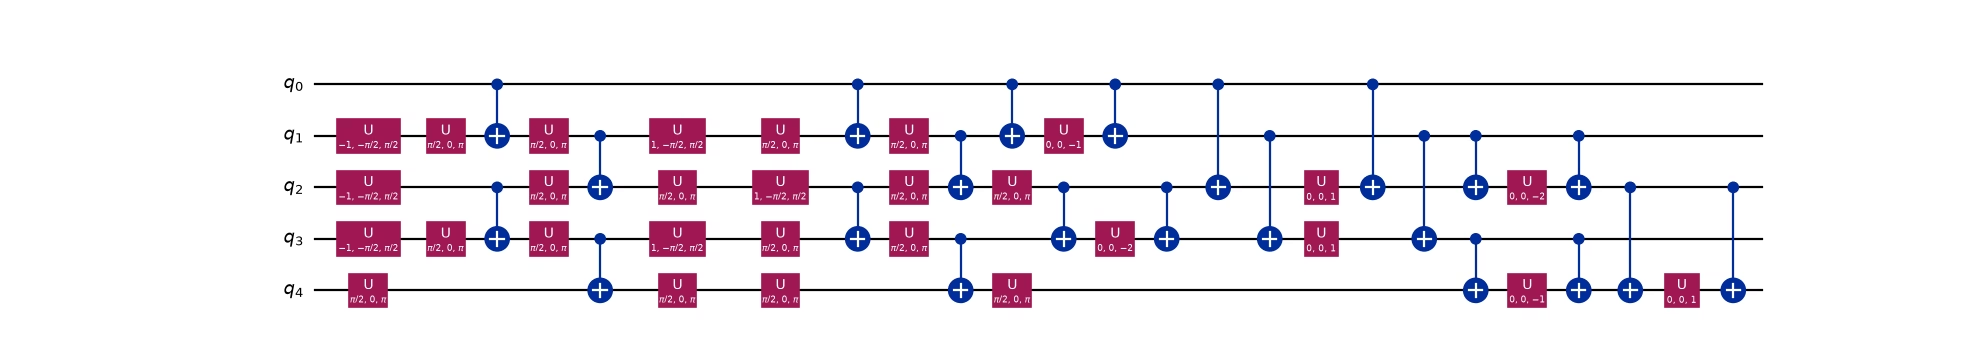
Da profondità 23 con 26 gate CX a profondità 12 con 22 gate CX. Nota che si tratta di meno gate entanglement e di quasi metà della profondità. Confrontando le due figure, la differenza non è che i gate costano meno, ma che si impilano. Le scale seriali sono sparite; i gate entanglement ora stanno uno sopra l'altro in strati condivisi perché l'intero flow set ovest viene ruotato in un'unica base condivisa e l'interazione viene emessa in strati di coppie disgiunte.
FlowSetSynthesis confronta per pattern gli indici assoluti dei qubit, il che qui è sicuro solo perché ogni flow set di questo Hamiltoniano copre l'intero registro. Una formula di prodotto fermionica restringe ogni fattore ai modi che tocca effettivamente, quindi un raggruppamento i cui insiemi coprissero solo parte della catena arriverebbe rietichettato e i pattern sopra non corrisponderebbero.
Entrambi i disegni mostrano il circuito dopo decompose(reps=6), che riscrive tutto nella base U e CX, quindi i gate CZ, Rx e Rzz emessi da FlowSetSynthesis non sono visibili come tali. È voluto: mette entrambi i circuiti nella stessa base, che è l'unico modo per rendere confrontabili i conteggi e le profondità a due qubit sopra. In queste figure ciò che conta è la struttura a strati, non le etichette dei gate.
8. Profondità costante su larga scala
La domanda interessante non è il conteggio con quattro modi, ma come scala. I due strati CZ a mattoncino non crescono con la lunghezza della catena, quindi la profondità a due qubit di un passo di Trotter dovrebbe essere costante. Misurandola direttamente sul pieno Hamiltoniano di Fermi-Hubbard, ben oltre ciò che si potrebbe simulare con la forza bruta:
>>> def evolution_stats(num_sites, product_formula):
...     operator = fermi_hubbard_1d(num_sites, tunneling=1.0, interaction=2.0)
...     operator.groups = flow_set_groups(operator)
...
...     circuit = FermionicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, operator, time=total_time, synthesis=FermionicLieTrotter()
...         ),
...         circuit.modes,
...     )
...     circuit = circuit.decompose()  # one Evolution per flow set, as in step 5
...
...     pass_manager = flow_set_pass_manager(circuit.register, product_formula)
...     decomposed = pass_manager.run(circuit).decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     return decomposed.count_ops()["cx"], decomposed.depth(two_qubit)
>>>
>>> sites = [4, 10, 20, 50, 100]
>>> flow = [evolution_stats(n, FlowSetSynthesis()) for n in sites]
>>> lie_trotter = [evolution_stats(n, LieTrotter()) for n in sites]
>>>
>>> [depth for _, depth in flow]
[12, 12, 12, 12, 12]
>>> [depth for _, depth in lie_trotter]
[23, 47, 87, 207, 407]
La profondità a due qubit resta 12 da quattro modi fino a 100, mentre LieTrotter cresce linearmente fino a 407. I flow set gli permettono di parallelizzare un poco all'interno della pipeline, ma ogni insieme viene comunque trotterizzato termine per termine, quindi la crescita è solo rallentata, non eliminata:
>>> import matplotlib.pyplot as plt
>>>
>>> figure, axes = plt.subplots(1, 2, figsize=(9, 3.5), layout="constrained")
>>> for panel, index, title in zip(axes, (1, 0), ("two-qubit depth", "CX count")):
...     _ = panel.plot(sites, [stat[index] for stat in lie_trotter], "o-", label="qubit-level")
...     _ = panel.plot(sites, [stat[index] for stat in flow], "s-", label="flow set")
...     _ = panel.set(xlabel="modes", title=title)
...     _ = panel.legend()
>>> figure
<Figure size ... with 2 Axes>

Il numero di gate cresce linearmente in entrambi i casi (ci sono termini da applicare, e ciò è inevitabile), ma la sintesi per flow set li applica in un numero costante di strati paralleli. Questo è il risultato a profondità costante del rif. [1].
La profondità 12 si ripartisce tra i tre flow set come 0 + 4 + 8, a ogni lunghezza della catena. Il flow set est contribuisce con zero; sono pure rotazioni Rx. Il flow set ovest costa 4, dai due strati CZ a mattoncino in entrata e dai due in uscita; eliminando l'interazione resta una profondità a due qubit di quattro a qualsiasi lunghezza della catena. Gli otto rimanenti sono l'interazione, i cui termini Rzz agiscono sia sui primi vicini sia sui secondi vicini e richiedono quindi quattro strati disgiunti, ciascuno con un costo di due gate CX. Quattro è ottimale qui: ogni qubit interno porta quattro gate Rzz (due verso ciascun primo vicino e due verso ciascun secondo vicino) e può partecipare a uno solo alla volta, quindi nessuna pianificazione può fare meglio.
Due terzi della profondità sono l'interazione, il che mostra che questa codifica eccelle nell'hopping, e quindi nella dinamica di una catena di fermioni liberi. Tuttavia, nota che l'interazione non commuta con l'hopping. Ometterla non è un'approssimazione di Fermi-Hubbard ma un modello diverso. Dove cada l'equilibrio per un dato problema merita di essere esplorato.
9. Verifica la dinamica
Con la mappa domain-wall, uno schema di occupazione diventa una stringa di parità cumulativa, quindi lo stato iniziale si prepara in modo diverso rispetto a Jordan-Wigner. È una conseguenza pratica facilmente trascurata della delocalizzazione della parità. L'helper del passaggio 4 fornisce l'etichetta corretta:
>>> occupations = [1, 0, 1, 0]
>>> initial_label = "".join(str(b) for b in reversed(domain_wall_bits(occupations)))
>>> initial_label
'00110'
Con lo stato preparato restano due domande, ed è meglio porle separatamente: la sintesi per flow set calcola la cosa giusta, e la calcola a un costo inferiore?
Cominciamo dalla correttezza. FlowSetSynthesis e LieTrotter di Qiskit ricevono gli stessi flow set codificati dalla stessa trotterizzazione fermionica, quindi devono realizzare la stessa unitaria a meno di una fase globale. I Clifford personalizzati riorganizzano il lavoro; non cambiano il risultato. I vettori di stato casuali rilevano qualsiasi discrepanza in modo molto più economico che costruire l'intera unitaria:
>>> from qiskit.quantum_info import Statevector
>>>
>>> rng = np.random.default_rng(1234)
>>>
>>> def agrees_up_to_one_phase(reps, samples=3):
...     """Compare both qubit-side syntheses of the same fermionic Trotterization."""
...     step = trotter_steps(reps)
...     trotter = flow_set_pass_manager(step.register, LieTrotter()).run(step)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     trotter, flow = trotter.decompose(reps=6), flow.decompose(reps=6)
...     dimension = 2**trotter.num_qubits
...     residuals, phases = [], []
...     for _ in range(samples):
...         vector = rng.normal(size=dimension) + 1j * rng.normal(size=dimension)
...         state = Statevector(vector / np.linalg.norm(vector))
...         a = state.evolve(trotter).data
...         b = state.evolve(flow).data
...         overlap = np.vdot(a, b)
...         phases.append(overlap / abs(overlap))
...         residuals.append(np.linalg.norm(b - a * overlap / abs(overlap)))
...     # the SAME global phase must work for every input state
...     spread = max(abs(phase - phases[0]) for phase in phases)
...     return bool(max(residuals) < 1e-9), bool(spread < 1e-9)
>>>
>>> [agrees_up_to_one_phase(reps) for reps in (1, 3)]
[(True, True), (True, True)]
Entrambe le metà di quel controllo contano. Una sovrapposizione di modulo unitario su un singolo stato è necessaria ma non sufficiente: una sintesi che sbagliasse una fase dipendente dallo stato lo mostrerebbe comunque. Richiedere la stessa fase su più stati casuali è ciò che colma il divario. Anche controllare più di un valore di reps è importante, perché conferma che l'accordo sopravvive all'intercalazione dei flow set anziché valere solo per una singola sequenza.
Quindi la scelta della sintesi lato qubit è ininfluente per l'accuratezza, ed è ciò che rende significativo un confronto dei costi. La domanda rimanente è che cosa ottenga la codifica nel suo complesso rispetto all'alternativa ovvia: il semplice Jordan-Wigner su num_sites qubit, senza ancilla e senza Clifford personalizzati. Sia la codifica sia la sintesi lato qubit differiscono tra le due colonne, ma il controllo precedente ha mostrato che quest'ultima non può influire sul risultato, quindi ciò che le fedeltà testano è la codifica. Inoltre entrambe le pipeline partono dalla stessa trotterizzazione fermionica, quindi qualsiasi differenza di fedeltà indicherebbe un bug anziché un compromesso. Le due colonne sono le codifiche, flow set contro Jordan-Wigner:
>>> def jordan_wigner_pass_manager(mode_register, product_formula):
...     """The same pipeline under plain Jordan-Wigner: one qubit per mode."""
...     synthesis = F2QSynthesis()
...     synthesis.methods["Evolution"] = MapperFnEvolutionSynthesis(
...         transfer_vertex_jordan_wigner, product_formula=product_formula
...     )
...     qubit_register = QuantumRegister(mode_register.size, "q")
...     return MultiStagePassManager(
...         input=FermionicCircuitToDAG(),
...         layout=CustomF2QLayout({mode_register: qubit_register}),
...         synthesis=synthesis,
...         output=QuantumDAGToCircuit(),
...     )
>>>
>>> from scipy.linalg import expm
>>>
>>> jw_state = np.zeros(2**num_sites, dtype=complex)
>>> jw_state[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> reference_jw = expm(-1j * total_time * jw_matrix) @ jw_state
>>> reference_flow = expm(-1j * total_time * flow_matrix) @ (isometry @ jw_state)
>>>
>>> def cost_and_fidelity(reps):
...     step = trotter_steps(reps)
...     flow = flow_set_pass_manager(step.register, FlowSetSynthesis()).run(step)
...     jw = jordan_wigner_pass_manager(step.register, LieTrotter()).run(step)
...     flow, jw = flow.decompose(reps=6), jw.decompose(reps=6)
...     two_qubit = lambda instruction: len(instruction.qubits) == 2
...     evolved_flow = Statevector.from_label(initial_label).evolve(flow).data
...     evolved_jw = Statevector(jw_state).evolve(jw).data
...     return (
...         abs(np.vdot(evolved_flow, reference_flow)) ** 2,
...         flow.count_ops()["cx"],
...         flow.depth(two_qubit),
...         abs(np.vdot(evolved_jw, reference_jw)) ** 2,
...         jw.count_ops()["cx"],
...         jw.depth(two_qubit),
...     )
>>>
>>> for reps in (1, 2, 4, 8):
...     flow_f, flow_cx, flow_d, jw_f, jw_cx, jw_d = cost_and_fidelity(reps)
...     print(
...         f"{reps} step(s):  flow set {flow_f:.6f}"
...         f" ({flow_cx:3d} CX, depth {flow_d:3d})"
...         f"   JW {jw_f:.6f} ({jw_cx:3d} CX, depth {jw_d:3d})"
...     )
1 step(s):  flow set 0.590661 ( 22 CX, depth  12)   JW 0.590661 ( 18 CX, depth  14)
2 step(s):  flow set 0.926656 ( 44 CX, depth  24)   JW 0.926656 ( 36 CX, depth  26)
4 step(s):  flow set 0.982053 ( 88 CX, depth  48)   JW 0.982053 ( 72 CX, depth  50)
8 step(s):  flow set 0.995395 (176 CX, depth  96)   JW 0.995395 (144 CX, depth  98)
Leggi prima la colonna della fedeltà: identica, in ogni cifra stampata, in due spazi di Hilbert diversi con due codifiche diverse. È la trotterizzazione fermionica che si fa vedere. L'approssimazione è stata fissata nel passaggio 5, prima che venisse scelta una qualsiasi delle codifiche, quindi entrambi i circuiti portano esattamente l'errore di una formula del primo ordine su tre flow set, e questo scende di circa quattro volte a ogni raddoppio del numero di passi.
Ciò in cui le codifiche differiscono è il costo, e il compromesso va esposto con chiarezza. Il flow set spende più gate entanglement: 22 contro 18 a un passo. L'ancilla non è il motivo, dato che non porta alcun gate a due qubit proprio. Il motivo è l'interazione, esattamente come avvertito nel passaggio 3: delocalizzare la parità trasforma tre termini ZZ tra primi vicini in sette che coprono primi e secondi vicini, e ciascuno costa due gate CX. È il prezzo da pagare per rendere economico l'hopping.
Inoltre vince solo di poco in profondità a questa dimensione (12 contro 14), perché quattro modi sono troppo pochi perché si manifesti il comportamento asintotico. Il punto è la scalabilità misurata nel passaggio 8: quella profondità di 12 è costante, mentre la profondità di Jordan-Wigner cresce con la catena. Con 14 modi è già 12 contro 34.
Le chiamate a decompose() qui sopra sono essenziali, per due motivi indipendenti.
evolve() e Operator usano la definizione esatta di un PauliEvolutionGate, aggirando una sintesi personalizzata lato qubit. Verificare su un circuito non decomposto riporta una fedeltà perfetta anche per una sintesi deliberatamente sbagliata.
Lo stesso vale un livello più in alto, per la sintesi fermionica. Un gate Evolution che non viene mai decomposto passa intero alla fase da fermione a qubit, che lo mappa senza consultare affatto Evolution.synthesis, quindi reps non avrebbe silenziosamente alcun effetto. trotter_steps del passaggio 5 esegue quella decomposizione; una pipeline che imposta il metodo con F2FSynthesis ottiene la stessa espansione dal pass.
Come controllo incrociato finale, le densità dei siti calcolate nello spazio codificato devono riprodurre il risultato di Jordan-Wigner. Questo controllo riguarda la codifica, non il circuito, quindi nessuna approssimazione di Trotter vi entra. Entrambe le evoluzioni temporali sono calcolate esattamente, tramite esponenziazione di matrice dei rispettivi Hamiltoniani. Qualsiasi discrepanza indicherebbe quindi la codifica anziché una formula di prodotto:
>>> time = 0.8
>>> state_jw = np.zeros(2**num_sites, dtype=complex)
>>> state_jw[sum(o << j for j, o in enumerate(occupations))] = 1.0
>>> evolved_jw = expm(-1j * time * jw_matrix) @ state_jw
>>> evolved_flow = expm(-1j * time * flow_matrix) @ (isometry @ state_jw)
>>>
>>> for j in range(num_sites):
...     v_flow = to_matrix(
...         SparseObservable.from_sparse_list([("ZZ", [j, j + 1], 1.0)], num_qubits)
...     )
...     v_jw = to_matrix(SparseObservable.from_sparse_list([("Z", [j], 1.0)], num_sites))
...     density_flow = (1 - np.vdot(evolved_flow, v_flow @ evolved_flow).real) / 2
...     density_jw = (1 - np.vdot(evolved_jw, v_jw @ evolved_jw).real) / 2
...     print(f"site {j}:  {density_flow:.10f}  {density_jw:.10f}")
site 0:  0.6507935456  0.6507935456
site 1:  0.5963201678  0.5963201678
site 2:  0.3365016619  0.3365016619
site 3:  0.4163846247  0.4163846247
Le densità coincidono fino a dieci cifre decimali.
Cosa portare a casa
-
Raggruppa prima di mappare. I flow set sono definiti sul grafo di interazione fermionico orientato, quindi il raggruppamento viene scelto quando la struttura del problema è ancora disponibile. L'attributo
groupslo porta nel circuito, dove un singolodecompose()lo trasforma in un gateEvolutionper flow set. -
Le ancille comprano struttura. Spendere un qubit in più trasforma un intero flow set in Pauli di peso 1, la cui evoluzione non richiede gate entanglement. Il rif. [1] osserva questo compromesso in generale. Rapporti qubit-fermioni maggiori ammettono circuiti di evoluzione meno profondi.
-
Una codifica personalizzata è una funzione. Mappa un singolo operatore di trasferimento generalizzato in una stringa di Pauli;
map_transfer_vertex_generators()eMapperFnEvolutionSynthesisfanno il resto. -
La mappatura e il raggruppamento da soli non bastano. Dividere l'evoluzione per flow set ha solo rallentato la crescita lineare della profondità; una sintesi termine per termine di ciascun insieme buttava comunque via il fatto che i suoi termini commutano. Solo fornire un
EvolutionSynthesisconsapevole dei flow set ha reso la profondità costante. Codifiche personalizzate, raggruppamento e sintesi personalizzata sono complementari: servono tutti e tre. -
Due formule di prodotto, due compiti.
FermionicLieTrotterfissa l'approssimazione nello spazio fermionico, dove il raggruppamento è ancora visibile, quindi da solo determina l'errore di Trotter e il numero di passi. L'EvolutionSynthesislato qubit decide poi soltanto con quanta economia viene realizzato ciascun insieme: il passaggio 9 conferma che entrambe le scelte danno la stessa unitaria. Separare i due è ciò che permette di regolare accuratezza e costo in modo indipendente. Vedi Sintetizzare un gate Evolution nello spazio fermionico. -
Verificalo. Una codifica che soddisfa le relazioni di commutazione potrebbe comunque rappresentare un Hamiltoniano diverso se un prefattore o un segno è sbagliato. Controllare una relazione di intreccio (o, più economicamente, lo spettro) intercetta questo problema.
Il FlowSetSynthesis sopra è scritto deliberatamente per questa codifica su una catena 1D. Confronta per pattern le specifiche etichette di Pauli che la codifica produce e solleva un errore su qualsiasi altra cosa, anziché ripiegare silenziosamente su una formula di prodotto generica. Un'implementazione generale ha due metà. Leggere la struttura dei flow set dai groups dell'operatore è ciò che un F2FSynthesisPlugin per un'evoluzione già fa. Derivare il Clifford diagonalizzante dal gruppo stabilizzatore, come descritto nella Sezione IV C del rif. [1], è la metà che resta specifica della codifica.
Inoltre, delocalizzare la parità rende il termine di interazione di peso 2 anziché diagonale nei singoli qubit, che è il costo speculare dei termini di hopping più economici.
Prossimo passo: due dimensioni
Tutto quanto sopra è unidimensionale, e deliberatamente. Su una catena, i flow set sono solo i due orientamenti delle frecce, e la codifica richiede una sola ancilla. Nessuna delle due semplificazioni sopravvive in due dimensioni, ed è lì che servono le codifiche locali.
Su un reticolo planare, un flow set è un cammino orientato (o un'unione di cammini orientati disgiunti nei vertici) attraverso il grafo di interazione, e trovare un piccolo insieme di tali cammini che copra ogni arco diventa un problema combinatorio a sé stante, anziché una classificazione in due righe. Anche le codifiche cambiano carattere; anziché una singola ancilla per l'intera catena, ne aggiungono una per ogni sito o cella del reticolo. Verstraete-Cirac associa a ogni sito fermionico il proprio qubit ausiliario, con un rapporto qubit-modi di , mentre Derby-Klassen ne colloca uno al centro di ogni plaquette dispari, con un rapporto di . Il layout del registro ha allora una genuina struttura bidimensionale, e il gruppo stabilizzatore su cui si deve proiettare non è più banale. L'Hamiltoniano codificato è fedele solo su un sottospazio, il che cambia sia la preparazione dello stato sia la procedura di verifica del passaggio 4.
I pezzi che questa guida costruisce sono quelli che si trasferiscono: CustomF2QLayout per un registro la cui dimensione differisce dal numero di modi, map_transfer_vertex_generators() per la codifica stessa, MapperFnEvolutionSynthesis per integrarla nel Transpiler, e un EvolutionSynthesis personalizzato per far fruttare la struttura dei flow set. Cambiano solo la codifica e la decomposizione in flow set.
La guida ai flow set 2D riparte da qui, sviluppando la codifica di Verstraete-Cirac su un reticolo quadrato: quattro flow set, un Clifford di profondità 2 per ciascuno e la proiezione sugli stabilizzatori di cui poi ha bisogno la verifica.
A. Gandon, S. Piccinelli, M. Rossmannek, F. Tacchino, A. Baiardi, J. Nys, and I. Tavernelli, Stabilizer-based quantum simulation of fermion dynamics with local qubit encodings (2026), arXiv:2512.11418v2.