Postselezione con controlli degli errori non markoviani
Questa guida spiega cosa sono i controlli degli errori non markoviani e come implementarli nel software con qiskit-mitigation. Inizierai con un piccolo esempio a due qubit per visualizzare i controlli e discutere come funzionano. Dopo aver sviluppato un po' di intuizione, proverai un esempio a 20 qubit in cui implementerai i controlli e confronterai diverse strategie di postselezione.
Cosa sono i controlli degli errori non markoviani?
I controlli degli errori non markoviani sono test basati sulla misura per verificare se lo stato di un qubit è probabilmente corrotto da una sorgente di errore non markoviana. Questo test si effettua posizionando un gate di bit-flip di durata estesa (xslow o una serie di gate rx con angolo ) su ciascun qubit all'inizio di un circuito, seguito da un normale XGate e misurando per assicurarsi che lo stato sia stato invertito con successo . Questo test può essere eseguito anche alla fine del circuito dopo ogni misura terminale per assicurarsi che il dispositivo riesca a invertire lo stato misurato del qubit da . I campioni associati a controlli falliti possono essere considerati inaffidabili, e postselezionare solo i campioni che superano tutti i controlli può aumentare la fedeltà della distribuzione rumorosa.
Strategie di postselezione basate sui controlli degli errori non markoviani
-
Postselezione basata sui nodi: postseleziona solo i campioni per cui ogni qubit ha superato i propri controlli. È la strategia più rigorosa e in genere comporta lo scarto di più campioni.
-
Postselezione basata sugli archi: per ogni arco nel grafo di accoppiamento dei qubit, assicurati che almeno un qubit superi i controlli. Questa strategia è più permissiva; se un qubit fallisce un controllo, il campione può comunque essere mantenuto se tutti i suoi vicini superano i propri controlli.
Qubit spettatori
È possibile specificare qubit ausiliari "spettatori" adiacenti ai qubit usati per eseguire il circuito originale. I controlli degli errori non markoviani possono essere posizionati su questi spettatori, fornendo una maggiore copertura contro il rumore non markoviano che questi controlli sono progettati per rilevare.
Parte 1. Visualizza i controlli degli errori non markoviani
Prima di dimostrare la tecnica su una QPU, creerai un piccolo circuito a due qubit e aggiungerai dei controlli per visualizzare come funziona. Inizia con uno stato di Bell transpilato per la QPU backend ibm_kingston.
# Added by doQumentation — installs the packages this notebook needs if they are missing
import importlib.util

_needed = {"matplotlib": "matplotlib", "numpy": "numpy", "qiskit": "qiskit", "qiskit_ibm_runtime": "qiskit-ibm-runtime", "qiskit_mitigation": "qiskit-mitigation", "samplomatic": "samplomatic"}
_missing = [pip for module, pip in _needed.items()
            if importlib.util.find_spec(module) is None]
# One at a time, so a package that fails to install does not block the others
for _pip in _missing:
    %pip install -q {_pip}
if not _missing:
    print("\u2713 All required packages are installed")
from qiskit import QuantumCircuit
from qiskit.transpiler import generate_preset_pass_manager
from qiskit_ibm_runtime import QiskitRuntimeService

service = QiskitRuntimeService(channel="ibm_quantum_platform")
backend = service.backend("ibm_kingston")

qc = QuantumCircuit(2)
qc.h(0)
qc.cx(0, 1)
qc.measure_all()
qc_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(qc)
qc_isa.draw("mpl")

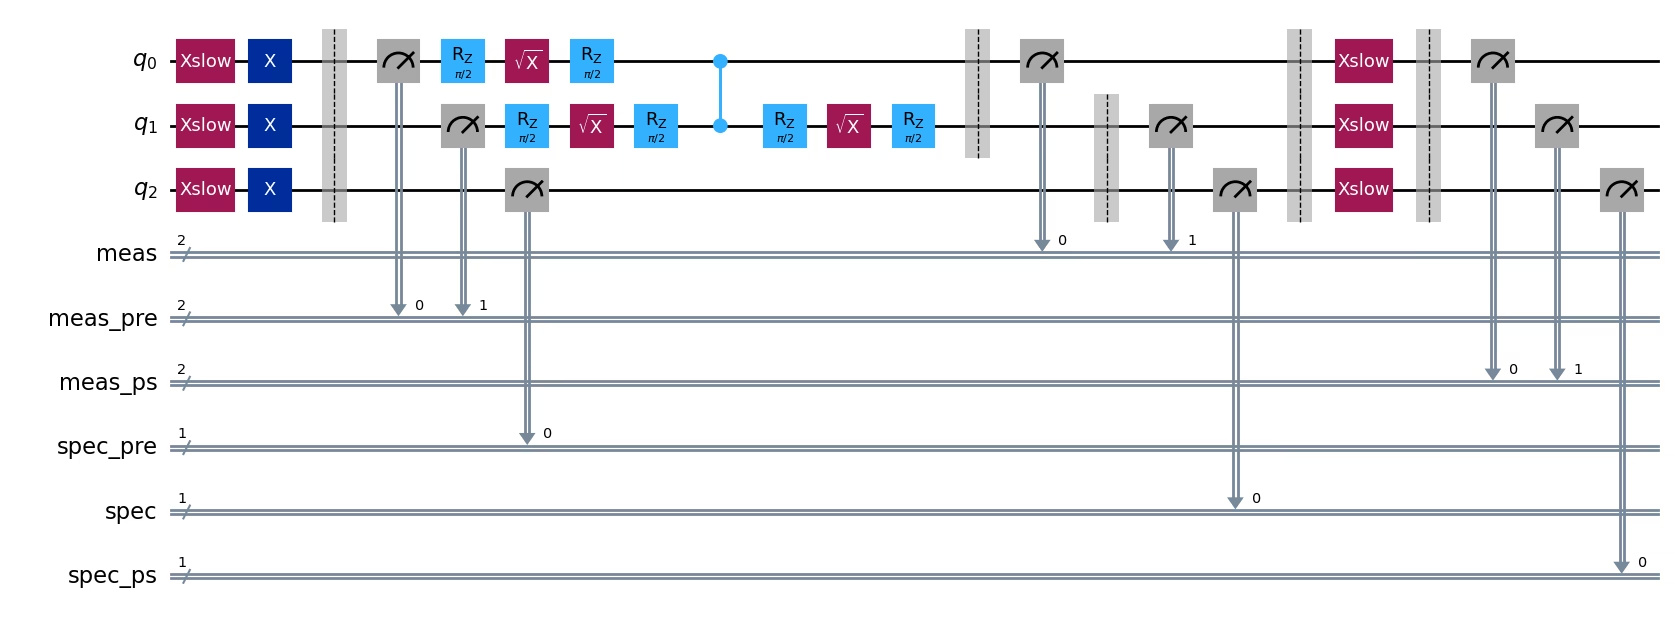
Aggiungi alcuni controlli degli errori non markoviani all'inizio del circuito. I controlli verranno posizionati solo sui qubit che terminano con una misura. Questi controlli assicurano che il dispositivo riesca a invertire lo stato iniziale del qubit da , e le misure di questi controlli vengono lette in un nuovo registro classico chiamato meas_pre.
from qiskit.transpiler import PassManager
from qiskit_mitigation.postselection.passes import (
    AddPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPreCircuitNonMarkovianErrorChecks()]).run(
    qc_isa
)
qc_w_checks.draw("mpl", idle_wires=False)

Analogamente, puoi aggiungere controlli alla fine del circuito dopo ogni misura terminale. Questi controlli assicurano che il dispositivo riesca a invertire lo stato del qubit da , e le loro misure vengono lette in un nuovo registro classico chiamato meas_ps.
from qiskit_mitigation.postselection.passes import (
    AddPostCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager([AddPostCircuitNonMarkovianErrorChecks()]).run(
    qc_w_checks
)
qc_w_checks.draw("mpl", idle_wires=False)

Come accennato nell'introduzione, puoi usare qubit ancilla adiacenti ai qubit di dati come "spettatori" per ottenere una maggiore copertura degli errori. Aggiungi controlli spettatore pre-circuito e post-circuito. Puoi vedere che, poiché il qubit fisico 2 su ibm_kingston è adiacente al qubit di dati 1, è stato aggiunto come spettatore, e a esso sono stati aggiunti controlli pre- e post-circuito. Le misure degli spettatori sono state aggiunte a nuovi registri classici chiamati spec_pre e spec.
Un circuito come questo contiene tutti i possibili controlli degli errori non markoviani, quindi campionare da questo circuito offre agli utenti la possibilità di effettuare la postselezione in base a qualsiasi combinazione di controlli [pre/post]-circuito e di strategia di postselezione [basata su nodi/basata su archi]. Consulta la Parte 2 di questa guida per vedere come funziona su hardware quantistico.
from qiskit_mitigation.postselection.passes import (
    AddSpectatorPostCircuitNonMarkovianErrorChecks,
    AddSpectatorPreCircuitNonMarkovianErrorChecks,
)

qc_w_checks = PassManager(
    [
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            coupling_map=backend.coupling_map
        ),
    ]
).run(qc_w_checks)
qc_w_checks.draw("mpl", idle_wires=False, fold=-1)
Parte 2: Dimostrare i controlli degli errori non markoviani su una QPU e confrontare le strategie di postselezione
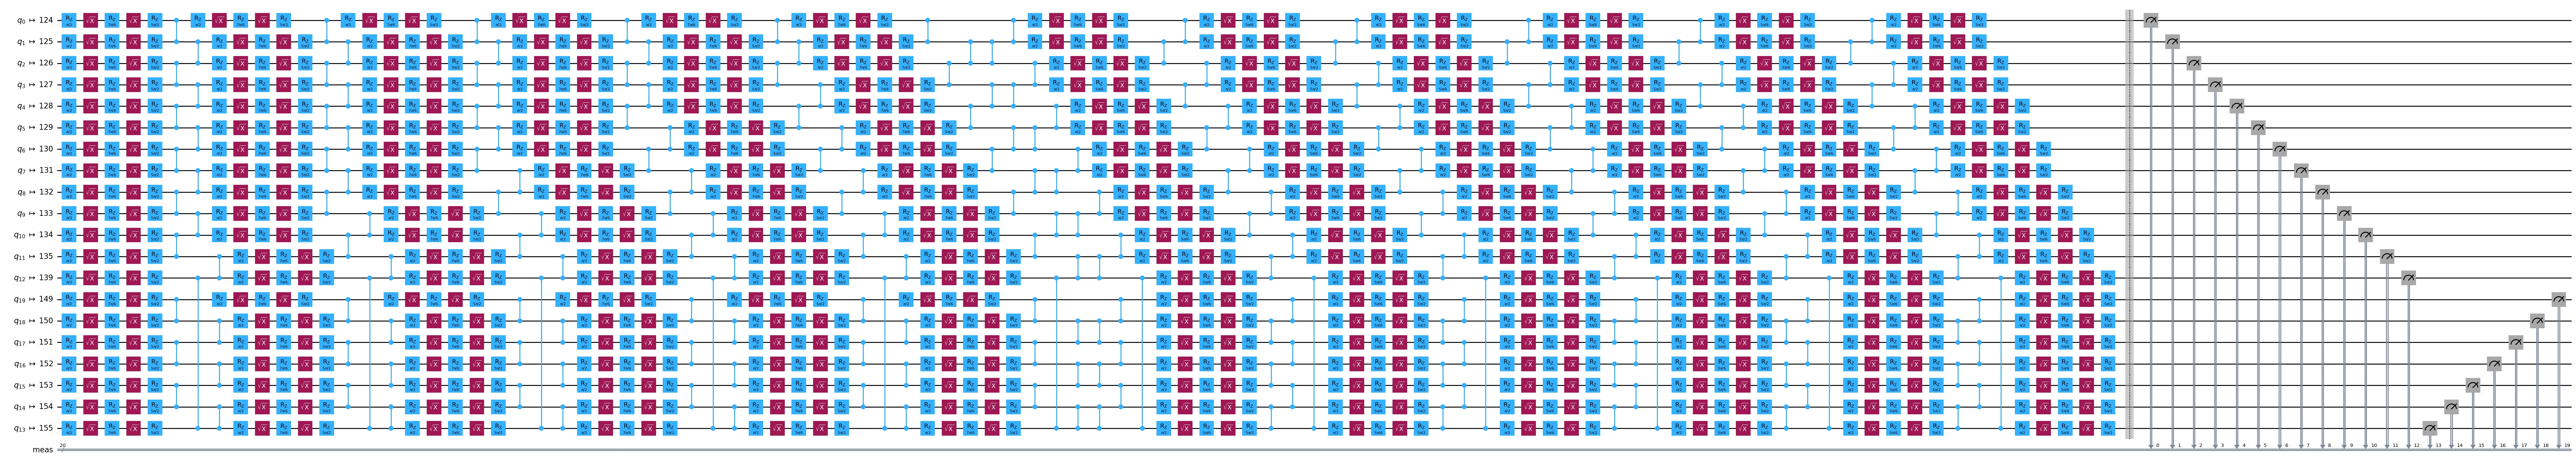
Ora che hai compreso cosa sono i controlli degli errori non markoviani e come vengono implementati nel software, puoi eseguire un esempio più grande su una QPU e vedere come funziona. Per prima cosa, prepara un circuito. La scelta del circuito non è molto importante; ti serve solo un circuito di cui puoi verificare facilmente il risultato. Qui scegliamo un circuito di Ising speculare 1D a 20 qubit. Questo circuito è non banale da eseguire su hardware e dovrebbe essere influenzato da errori non markoviani, il che offre l'opportunità di dimostrare l'efficacia dei controlli degli errori non markoviani. Inoltre, la struttura speculare ci permette di confrontare in modo banale i calcoli dei valori di aspettazione affetti da rumore con i valori esatti.
In questo esperimento calcoliamo valori di aspettazione di osservabili. Anche la scelta dell'osservabile non è importante, quindi scegliamo semplicemente la magnetizzazione media del singolo sito .
import numpy as np
from qiskit.quantum_info import SparsePauliOp
from qiskit.transpiler import CouplingMap

num_qubits = 20
initial_layout = initial_layout = [
    124,
    125,
    126,
    127,
    128,
    129,
    130,
    131,
    132,
    133,
    134,
    135,
    139,
    155,
    154,
    153,
    152,
    151,
    150,
    149,
][:num_qubits]
coupling_map = CouplingMap.from_line(num_qubits, bidirectional=False)

# Num Trotter steps and `rx` angle
num_steps = 6
theta_rx = np.pi / 6

# Average single-site magnetization
observable = (
    SparsePauliOp(
        [
            "I" * iq + "Z" + "I" * (num_qubits - iq - 1)
            for iq in range(num_qubits)
        ]
    )
    / num_qubits
)

# Create the Trotter circuit
circuit = QuantumCircuit(num_qubits)
edges = CouplingMap.from_line(num_qubits, bidirectional=False).get_edges()
edges_a = [e for e in edges if e[0] % 2 == 0]
edges_b = [e for e in edges if e[0] % 2 == 1]
for _ in range(num_steps):
    circuit.rx(theta_rx, [i for i in range(num_qubits)])
    for edge in edges_a:
        circuit.cz(edge[0], edge[1])
    for edge in edges_b:
        circuit.cz(edge[0], edge[1])
circuit = circuit.compose(circuit.inverse())
circuit.measure_all()

# Transpile circuit to backend
pm = generate_preset_pass_manager(
    optimization_level=0, backend=backend, initial_layout=initial_layout
)
isa_circuit = pm.run(circuit)
print(
    f"two-qubit depth: {isa_circuit.depth(lambda instr: instr.operation.num_qubits == 2)}"
)
print(f"total depth:     {isa_circuit.depth()}")
isa_circuit.draw("mpl", fold=-1, idle_wires=False)
two-qubit depth: 24
total depth:     85
Ora aggiungiamo controlli pre- e post-circuito su ogni qubit, compresi i sette qubit spettatori adiacenti. Quando aggiungi tutti i controlli possibili a un circuito, puoi decidere quale strategia di postselezione usare durante la post-elaborazione.
# Use all non-Markovian error checks so we can compare all strategies in post-processing.
combined = PassManager(
    [
        AddPreCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPreCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
        AddPostCircuitNonMarkovianErrorChecks(x_pulse_type="rx"),
        AddSpectatorPostCircuitNonMarkovianErrorChecks(
            backend.coupling_map, x_pulse_type="rx"
        ),
    ]
).run(isa_circuit)
combined_isa = generate_preset_pass_manager(
    optimization_level=0, backend=backend
).run(combined)

print("cregs:", [(c.name, c.size) for c in combined_isa.cregs])
cregs: [('meas', 20), ('meas_pre', 20), ('spec_pre', 7), ('meas_ps', 20), ('spec', 7), ('spec_ps', 7)]
Usa la primitiva Executor per campionare il circuito che contiene i controlli.
from qiskit_ibm_runtime import Executor
from samplomatic.quantum_program import QuantumProgram

# Raw and combined-checks circuits in a single 100k-shot program so they share calibration.
program = QuantumProgram(shots=100_000)
program.append_circuit_item(isa_circuit)  # raw circuit, no checks
program.append_circuit_item(
    combined_isa
)  # combined pre + post non-Markovian error checks
job = Executor(backend).run(program)
print(f"job id: {job.job_id()}")
print(f"status: {job.status()}")
job id: d9badrm6hjac73ffe31g
status: QUEUED
La classe PostSelector conosce la struttura creg dei controlli, quindi può associare ogni bit dei campioni alla relativa misura del circuito. Il suo metodo compute_mask può essere usato per creare una maschera su una sequenza di campioni, data la strategia di postselezione (nodo o arco) e il tipo di controlli degli errori non markoviani da considerare (pre- o post-circuito). Per combinare le strategie pre- e post-circuito in un'unica maschera, le rispettive maschere possono essere calcolate in modo indipendente e poi combinate con l'operazione AND. Qui usiamo il PostSelector per creare le maschere per tutte le varie strategie e osserviamo i risultati usando ogni permutazione di strategie disponibile.
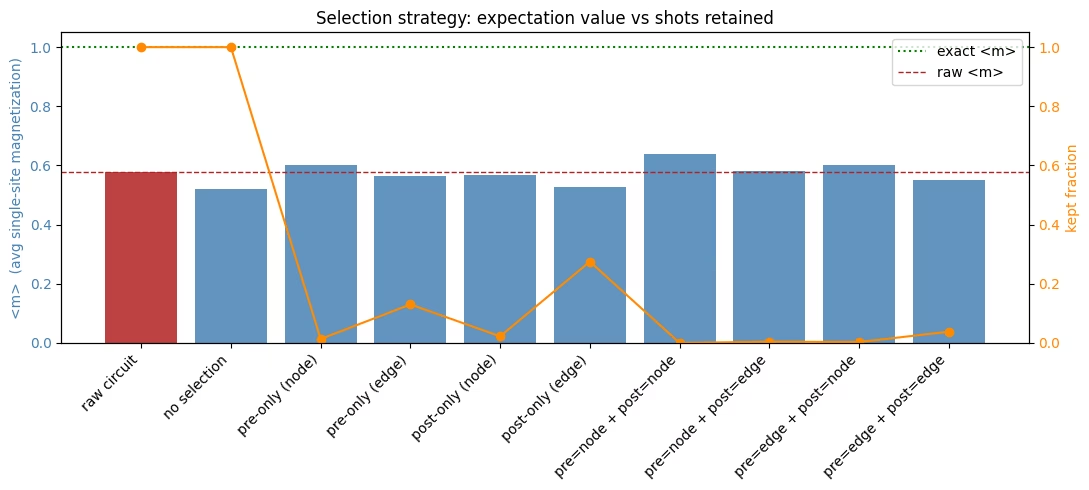
Nella visualizzazione seguente vediamo come la strategia di postselezione influisce sul tasso di postselezione e sulla qualità della risposta. Come previsto, le strategie che prevedono la postselezione basata su nodi hanno prodotto i tassi di postselezione più bassi. Le strategie basate su archi sono più permissive e tendono a produrre tassi di postselezione più alti. Gli utenti dovrebbero sperimentare le varie strategie sul proprio problema per determinare il giusto equilibrio tra tasso di postselezione e qualità della distribuzione campionata. In questo esempio, usare la postselezione basata su nodi con i controlli pre- e post-circuito ha prodotto la risposta migliore con un tasso di postselezione di .028%. Alcune delle strategie non hanno superato il circuito grezzo. Puoi anche vedere che aggiungere i controlli senza usarne nessuno (barra con etichetta "no selection" nel grafico seguente) ha le prestazioni peggiori.
import matplotlib.pyplot as plt
from qiskit_mitigation.postselection import PostSelector

selector = PostSelector.from_circuit(combined_isa, backend.coupling_map)

exec_results = job.result()
# The Executor returns numpy arrays keyed by classical-register name, so each result item is
# already the {creg_name: ndarray} mapping that compute_mask expects.
raw_bits = exec_results[0]["meas"]  # raw circuit, no checks
bits = exec_results[1]  # combined pre+post circuit

meas_bits = bits["meas"]
total = meas_bits[..., 0].size

def magnetization(b, mask=None):
    """Average single-site magnetization over the (optionally masked) measurement bits."""
    kept = b if mask is None else b[mask]
    return (1 - 2 * kept.astype(int)).mean()  # bit 0 -> +1, bit 1 -> -1

rows = []

def report(label, mask=None, b=meas_bits):
    """Record and print the magnetization and kept fraction for one selection strategy."""
    kept = b[..., 0].size if mask is None else int(mask.sum())
    ev = magnetization(b, mask)
    rows.append((label, ev, kept / total))
    print(f"{label:<24}: <m> = {ev:+.4f}   (kept {kept:>6}/{total})")

# Compare all possible postselection strategies
report("raw circuit", b=raw_bits)
report("no selection")
for s in ("node", "edge"):
    report(f"pre-only ({s})", selector.compute_mask(bits, s, mode="pre"))
for s in ("node", "edge"):
    report(f"post-only ({s})", selector.compute_mask(bits, s, mode="post"))
for pre_s in ("node", "edge"):
    for post_s in ("node", "edge"):
        keep = selector.compute_mask(
            bits, pre_s, mode="pre"
        ) & selector.compute_mask(bits, post_s, mode="post")
        report(f"pre={pre_s} + post={post_s}", keep)

labels = [r[0] for r in rows]
evs = [r[1] for r in rows]
fracs = [r[2] for r in rows]
x = range(len(labels))

fig, ax1 = plt.subplots(figsize=(11, 5))

# Bars: expectation value per selection strategy.
bar_colors = ["firebrick"] + ["steelblue"] * (len(evs) - 1)
ax1.bar(x, evs, color=bar_colors, alpha=0.85)
ax1.axhline(1.0, color="green", ls=":", lw=1.5, label="exact <m>")
ax1.axhline(rows[0][1], color="firebrick", ls="--", lw=1, label="raw <m>")
ax1.set_ylabel("<m>  (avg single-site magnetization)", color="steelblue")
ax1.tick_params(axis="y", labelcolor="steelblue")
ax1.set_xticks(list(x))
ax1.set_xticklabels(labels, rotation=45, ha="right")
ax1.legend(loc="upper right")

# Line: fraction of shots retained (right axis).
ax2 = ax1.twinx()
ax2.plot(x, fracs, "o-", color="darkorange")
ax2.set_ylabel("kept fraction", color="darkorange")
ax2.tick_params(axis="y", labelcolor="darkorange")
ax2.set_ylim(0, 1.05)

ax1.set_title("Selection strategy: expectation value vs shots retained")
fig.tight_layout()
plt.show()
raw circuit             : <m> = +0.5791   (kept 100000/100000)
no selection            : <m> = +0.5211   (kept 100000/100000)
pre-only (node)         : <m> = +0.6026   (kept   1357/100000)
pre-only (edge)         : <m> = +0.5637   (kept  13029/100000)
post-only (node)        : <m> = +0.5682   (kept   2254/100000)
post-only (edge)        : <m> = +0.5265   (kept  27514/100000)
pre=node + post=node    : <m> = +0.6393   (kept     28/100000)
pre=node + post=edge    : <m> = +0.5799   (kept    442/100000)
pre=edge + post=node    : <m> = +0.6006   (kept    317/100000)
pre=edge + post=edge    : <m> = +0.5521   (kept   3836/100000)