Simula la dinamica di Bose-Hubbard con una scelta di codifica
Questa guida costruisce un circuito per la dinamica temporale del modello di Bose-Hubbard unidimensionale, dalla scrittura dell'Hamiltoniana fino al confronto delle densità di sito evolute con un riferimento esatto. Ciò che rende interessante questo percorso è un'unica idea:
Non scegliere una codifica da bosone a qubit quando costruisci il circuito. Costruisci il circuito su modi bosonici e lascia che sia il transpiler a decidere come quei modi diventano qubit.
Per i bosoni, quasi sempre è necessario rimandare la codifica. Un modo bosonico può contenere un numero arbitrario di particelle, quindi il suo spazio di Fock ha dimensione infinita e nessuna codifica esiste finché non scegli prima una troncazione (il numero di livelli di occupazione che mantieni). Nel codice la troncazione è data come la massima occupazione che un modo può contenere, max_occupation , quindi un modo che mantiene i livelli ha max_occupation = 2 e .
Questo rende la troncazione un parametro della codifica, non della fisica, ed è un parametro che vuoi far variare: troppo piccolo e la risposta è sbagliata, troppo grande e il circuito è inutilmente largo. Se rimandi la codifica al momento della transpilazione, puoi variare la troncazione senza modificare il circuito, l'Hamiltoniana o il raggruppamento.
La guida sugli operatori per la struttura dati degli operatori, la guida sui mapper per le codifiche e la ricetta per scrivere un mapper personalizzato, e la guida alla transpilazione per le fasi del transpiler a cui si fa riferimento nel testo.
Troncazione e il suo costo
Quando tronchi un modo a livelli, rompi il commutatore canonico sul livello massimo mantenuto [1], quindi nessuna codifica è un isomorfismo di algebre: una codifica bosonica mappa gli stati e gli operatori che agiscono all'interno del sottospazio troncato. Due conseguenze sono importanti per tutto ciò che segue:
-
deve limitare l'occupazione raggiungibile dalla dinamica, non solo quella dello stato iniziale.
-
La mappatura non commuta con l'ordinamento normale, quindi decidi una volta per tutte se la tua Hamiltoniana è definita in forma ordinata normalmente e mantieni la coerenza.
La guida sui mapper ricava il difetto e mostra entrambe le conseguenze su codice funzionante.
1. L'Hamiltoniana
Il modello di Bose-Hubbard su un reticolo con legami è
con . L'interazione conta le coppie di bosoni su un sito, quindi richiede che un sito contenga due particelle contemporaneamente. In ordine normale, , che è la forma usata di seguito.
La geometria entra solo attraverso l'elenco degli spigoli, quindi nulla è specifico di una catena:
>>> from qiskit_bosons.operators import BosonOperator, ann, cre
>>>
>>> def bose_hubbard(edges, num_sites, tunneling, interaction):
...     """Build the normal-ordered Bose-Hubbard Hamiltonian on an arbitrary lattice."""
...     terms = {}
...     for i, j in edges:
...         terms[(cre(i), ann(j))] = -tunneling
...         terms[(cre(j), ann(i))] = -tunneling
...     for i in range(num_sites):
...         # U/2 * n_i (n_i - 1), already normal-ordered
...         terms[(cre(i), cre(i), ann(i), ann(i))] = 0.5 * interaction
...     return BosonOperator.from_dict(terms)
>>>
>>> num_sites = 4
>>> edges = [(i, i + 1) for i in range(num_sites - 1)]
>>> hamiltonian = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> print(f"Number of terms: {len(hamiltonian)}")
Number of terms: 10
Vale la pena verificare prima due proprietà. L'Hamiltoniana deve essere hermitiana affinché sia unitaria, e conserva il numero totale di bosoni:
>>> hamiltonian.is_hermitian()
True
>>> hamiltonian.conserves_particle_number()
True
Ora la domanda bosonica: quanti livelli richiede questo operatore?
>>> hamiltonian.max_occupation()
2
Il termine di interazione applica due operatori di creazione a un solo modo, quindi un modo deve poter contenere due bosoni affinché il termine agisca. Questa è un'occupazione massima di 2, ovvero il numero che LevelSpec accetta come max_occupation. Un modo che mantiene le occupazioni ha livelli, quindi max_occupation >= 2 è lo stesso requisito di .
Questo è solo un limite inferiore: deriva da una singola applicazione dell'operatore, e l'applicazione ripetuta nel corso di un'evoluzione temporale può spingersi oltre. Esclude i cutoff che sono certamente troppo piccoli, mentre il passo 6 stabilisce, per questo modello e questo stato, quanto grande debba essere il cutoff. mode_occupations() riporta il limite per ciascun modo separatamente, ed è con questo che si confronta un cutoff per singolo modo.
2. Raggruppare prima della mappatura
L'evoluzione è trotterizzata, e il modo in cui l'Hamiltoniana viene partizionata determina ciò che viene passato alla sintesi. Due considerazioni vanno nella stessa direzione.
Prima, una di natura fisica: il singolo termine di hopping non è hermitiano. Solo la coppia lo è. Se evolvi sotto un singolo termine non hermitiano, l'operazione non è unitaria, e l'operatore mappato avrebbe coefficienti complessi che PauliEvolutionGate rifiuta. I due termini di hopping di ciascun legame devono quindi restare insieme.
Seconda, una di efficienza: tutti i termini di interazione on-site sono diagonali nella base di occupazione e commutano tra loro, quindi possono condividere un unico gruppo ed essere sintetizzati insieme. Lo stesso vale per i legami che non toccano alcun sito in comune. Su una catena, un legame ogni due costituisce un insieme di questo tipo: i legami 0 e 2 agiscono su coppie di modi disgiunte, quindi i loro termini di hopping commutano e possono condividere un gruppo, mentre il legame 1 forma un gruppo a sé. Se raggruppi i legami pari e dispari, servono quindi tre gruppi, laddove un gruppo per legame ne richiede quattro. Meno gruppi significano meno fattori, e anche un circuito meno profondo: con il codice di Gray a max_occupation = 2 la profondità a due qubit è 95 contro 139. Il reticolo decide quali legami possono condividere un gruppo, ed è per questo che la partizione viene scelta qui.
L'attributo groups porta questa decisione nel circuito: un gate Evolution su un operatore raggruppato si decompone in una sotto-evoluzione per gruppo. La partizione viene scelta a livello bosonico, quando la struttura del reticolo è ancora visibile, e sopravvive intatta alla mappatura. La guida al raggruppamento illustra i controlli che un raggruppamento dovrebbe superare.
>>> def group_of(actions, edges):
...     """Assign each term to the even bonds, the odd bonds, or the on-site group."""
...     creations = sorted(mode for action, mode in actions if action)
...     annihilations = sorted(mode for action, mode in actions if not action)
...     if creations == annihilations:
...         return 2  # diagonal: the on-site interaction group
...     bond = tuple(sorted(set(creations) | set(annihilations)))
...     return edges.index(bond) % 2  # bonds 0 and 2 share a group, bond 1 has its own
>>>
>>> hamiltonian.groups = [group_of(actions, edges) for actions, _ in hamiltonian.iter_terms()]
>>> hamiltonian.num_groups()
3
Ogni gruppo deve essere a sua volta hermitiano, ed è ciò che garantisce l'accoppiamento precedente. groups_are_hermitian() verifica tutti i gruppi in una sola chiamata:
>>> from qiskit_bosons.operators.terms import groups_are_hermitian
>>> groups_are_hermitian(hamiltonian)
[True, True, True]
Per vedere cosa contiene ogni gruppo, separa i gruppi:
>>> for index, group in enumerate(hamiltonian.split_out_groups()):
...     print(f"group {index}: {len(group)} terms, hermitian={group.is_hermitian()}")
group 0: 4 terms, hermitian=True
group 1: 2 terms, hermitian=True
group 2: 4 terms, hermitian=True
Il raggruppamento pari-dispari è una scelta, e l'alternativa è facile da misurare. Se dai a ogni legame un gruppo a sé, servono quattro gruppi, e lo stesso circuito costa allora più profondità a due qubit. La profondità è contata dopo aver abbassato il circuito con il codice di Gray a max_occupation = 2, come spiega il passo 4:
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution
>>> from qiskit_bosons.mappers import LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> def two_qubit_depth(operator):
...     """The two-qubit depth of one evolution under ``operator``, lowered with the Gray code."""
...     probe = BosonicCircuit(num_sites)
...     probe.append(Evolution(num_sites, operator, time=0.4), probe.modes)
...     pass_manager = generate_preset_occupation_pass_manager(LevelSpec(2, "gray"))
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(probe.decompose())
...     return lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
>>>
>>> per_bond = bose_hubbard(edges, num_sites, tunneling=1.0, interaction=2.0)
>>> per_bond.groups = [
...     len(edges) if sorted(m for a, m in actions if a) == sorted(m for a, m in actions if not a)
...     else edges.index(tuple(sorted({m for _, m in actions})))
...     for actions, _ in per_bond.iter_terms()
... ]
>>> per_bond.num_groups(), two_qubit_depth(per_bond)
(4, 139)
>>> hamiltonian.num_groups(), two_qubit_depth(hamiltonian)
(3, 95)
3. Il circuito bosonico
Nota che cosa è assente dal circuito. Non ci sono troncazione, codifica né numero di qubit. Agisce su quattro modi bosonici:
>>> from qiskit_bosons.circuit import BosonicCircuit
>>> from qiskit_bosons.circuit.library import Evolution, InitializeModes
>>>
>>> total_time = 0.4
>>> occupation = [1, 1, 0, 0]  # one boson on each of the first two sites
>>>
>>> circuit = BosonicCircuit(num_sites)
>>> circuit.append(InitializeModes(occupation), circuit.modes)
>>> circuit.append(Evolution(num_sites, hamiltonian, time=total_time), circuit.modes)
>>> dict(circuit.count_ops())
{'InitializeModes': 1, 'Evolution': 1}

Le linee sono modi bosonici, non qubit. Nota che InitializeModes accetta interi, non flag: un modo può contenere un numero qualsiasi di bosoni, quindi uno stato di Fock è una lista di numeri di occupazione.
Una singola decompose() trasforma il raggruppamento del passo 2 in un gate per gruppo:
>>> decomposed = circuit.decompose()
>>> dict(decomposed.count_ops())
{'Evolution': 3, 'InitializeModes': 1}
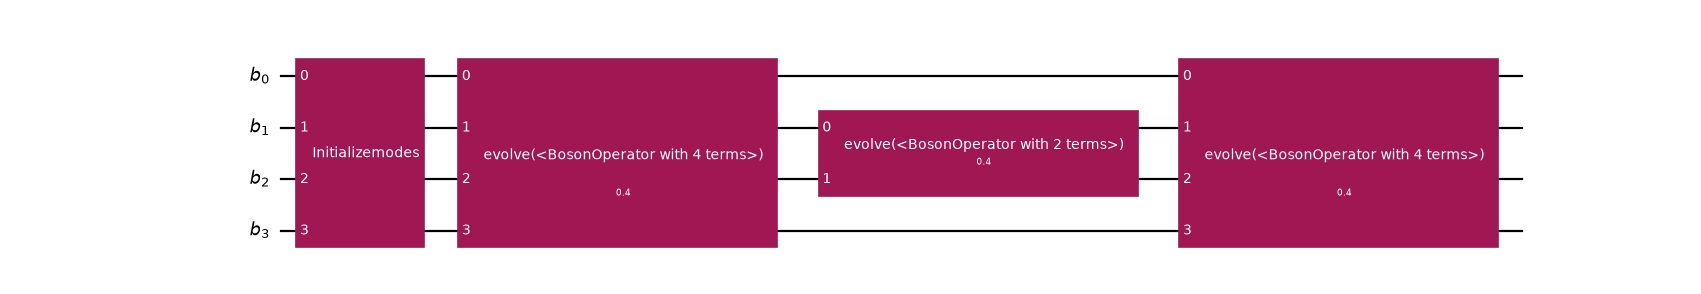
Il primo gruppo contiene i legami sui modi 0 e 1 e sui modi 2 e 3, quindi il suo gate si estende su tutti e quattro i modi, e lo stesso vale per il gruppo on-site. Il legame centrale ha un gate proprio sui modi 1 e 2.
Se salti quella decomposizione, il raggruppamento viene semplicemente ignorato. Il metodo che esegue la suddivisione è la synthesis del gate, con BosonicLieTrotter come predefinito; Sintetizzare un gate Evolution nello spazio bosonico mostra le alternative.
4. Scegliere la codifica al momento della transpilazione
Ecco il vantaggio. Lo stesso circuito viene abbassato quattro volte, con quattro diversi valori di LevelEncoding, cambiando un solo argomento. Un LevelSpec abbina la codifica alla troncazione di ogni modo, e il preset seguente ricava il layout, la preparazione dello stato e la mappatura dell'operatore da quell'unica specifica (vedi Descrivere la troncazione con un LevelSpec). Una stringa come "gray" è accettata ovunque sia accettato un LevelEncoding.
>>> from qiskit.transpiler import PassManager
>>> from qiskit_bosons.mappers import LevelEncoding, LevelSpec
>>> from qiskit_bosons.transpiler.presets import generate_preset_occupation_pass_manager
>>>
>>> max_occupation = 2  # the largest occupation per mode, so d = max_occupation + 1 = 3 levels
>>>
>>> encodings = (
...     LevelEncoding.UNARY_PROJECTED,
...     LevelEncoding.UNARY_UNPROJECTED,
...     LevelEncoding.STANDARD_BINARY,
...     LevelEncoding.GRAY,
... )
>>> for encoding in encodings:
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     pass_manager.qubit = PassManager()  # keep the circuit as the pipeline synthesized it
...     qubit_circuit = pass_manager.run(decomposed)
...     basis = qubit_circuit.decompose(reps=6)
...     two_qubit = basis.depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"{encoding!s:18s} qubits={qubit_circuit.num_qubits:2d}  2q-depth={two_qubit:4d}")
unary_projected    qubits=12  2q-depth= 645
unary_unprojected  qubits=12  2q-depth= 383
standard_binary    qubits= 8  2q-depth= 218
gray               qubits= 8  2q-depth=  95
Questi numeri smentiscono una congettura naturale. Le codifiche unarie usano qubit per modo contro dei codici compatti, e a i codici compatti vincono su entrambi i fronti: meno qubit e molti meno gate di entanglement. Le due varianti unarie differiscono per l'operatore che emettono, non per il layout: LevelEncoding.UNARY_PROJECTED porta un proiettore su un qubit ogni due di un modo, il che la rende la più costosa da evolvere delle quattro, mentre LevelEncoding.UNARY_UNPROJECTED omette i proiettori e concorda con essa sul sottospazio one-hot. La guida sui mapper mostra i due operatori affiancati e spiega perché il codice di Gray batte il binario standard (SB) sui termini di hopping.
Sawaya et al. riportano lo stesso ordinamento [2]:
sebbene il codice unario tenda a richiedere più qubit ma meno operazioni, accade spesso che il codice SB o di Gray sia più efficiente sia in termini di numero di qubit sia di numero di operazioni
La loro conclusione è che il codice migliore dipende dall'Hamiltoniana e da , il che è l'argomento più forte per non fissare la scelta nel circuito.
Con una codifica di livello un modo si estende su più qubit, quindi il registro dei qubit è più largo del registro dei modi. Il preset usa OccupationB2QLayout, che ricava la larghezza del registro dal LevelSpec. La guida alla transpilazione illustra le fasi eseguite dal preset.
5. Verifica rispetto alla dinamica esatta
Nessuno dei passi precedenti stabilisce che il circuito sia corretto. Per questo, confronta le densità di sito dopo l'evoluzione con un riferimento esatto calcolato sull'Hamiltoniana codificata.
Il riferimento deve essere calcolato nello stesso spazio troncato in cui lavora il circuito, perché il confronto con un calcolo non troncato confonderebbe l'errore di Trotter con l'errore di troncazione, che sono cose diverse e vale la pena separare (vedi Troncare lo spazio di Fock).
>>> import numpy as np
>>> from qiskit.quantum_info import SparsePauliOp, Statevector
>>> from scipy.sparse.linalg import expm_multiply
>>> from qiskit_bosons.mappers.library import occupation_encoding
>>>
>>> def sparse_matrix(operator, encoding):
...     """Map a bosonic operator and hand back a sparse qubit matrix."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     observable = occupation_encoding(operator, spec)
...     return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
>>>
>>> def fock_index(occupation, encoding):
...     """The computational basis index encoding a product Fock state."""
...     spec = LevelSpec(max_occupation, encoding).resolve(num_sites)
...     return sum(
...         encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets)
...     )
>>>
>>> def densities(state, encoding):
...     """The per-site boson number <n_m> of an encoded state vector."""
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         matrix = sparse_matrix(number, encoding)
...         out.append(float((state.conj() @ (matrix @ state)).real))
...     return out
Con questi elementi a disposizione, l'evoluzione esatta nello spazio troncato:
>>> encoding = LevelEncoding.GRAY
>>> num_qubits = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
>>>
>>> initial = np.zeros(2**num_qubits, dtype=complex)
>>> initial[fock_index(occupation, encoding)] = 1.0
>>>
>>> evolved_exact = expm_multiply(
...     -1j * total_time * sparse_matrix(hamiltonian, encoding), initial
... )
>>> reference = densities(evolved_exact, encoding)
>>> for site, value in enumerate(reference):
...     print(f"site {site}: {value:.6f}")
site 0: 0.993834
site 1: 0.858853
site 2: 0.141309
site 3: 0.006004
I bosoni si diffondono dall'estremità occupata della catena verso quella vuota, e i due bosoni sono conservati:
>>> bool(np.isclose(sum(reference), 2.0))
True
Ora il circuito. Nota che il riferimento precedente è stato costruito direttamente da initial, quindi il circuito confrontato con esso deve contenere solo l'evoluzione, perché il gate InitializeModes preparerebbe di nuovo uno stato già preparato.
>>> from qiskit_bosons.circuit.library.synthesis import BosonicLieTrotter
>>>
>>> def trotter_densities(steps, encoding):
...     """Site densities after `steps` first-order Trotter steps of the grouped evolution."""
...     circuit = BosonicCircuit(num_sites)
...     circuit.append(
...         Evolution(
...             num_sites, hamiltonian, time=total_time, synthesis=BosonicLieTrotter(reps=steps)
...         ),
...         circuit.modes,
...     )
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occupation, encoding)
...     )
...     qubit_circuit = pass_manager.run(circuit.decompose())
...     # decompose BEFORE evolving: see the warning that follows
...     basis = qubit_circuit.decompose(reps=6)
...     state = np.asarray(Statevector(initial).evolve(basis).data)
...     return densities(state, encoding)
>>>
>>> for steps in (1, 2, 4, 8, 16):
...     error = max(
...         abs(a - b) for a, b in zip(trotter_densities(steps, encoding), reference)
...     )
...     print(f"steps={steps:2d}  max density error = {error:.4f}")
steps= 1  max density error = 0.0843
steps= 2  max density error = 0.0389
steps= 4  max density error = 0.0183
steps= 8  max density error = 0.0088
steps=16  max density error = 0.0043
L'errore si dimezza al raddoppiare del numero di passi, che è la firma di una formula di prodotto del primo ordine. Questa è la prova che la discrepanza è errore di Trotter e che la codifica è fedele.
Le ripetizioni provengono dalla synthesis del gate, che trotterizza nello spazio bosonico dove il raggruppamento esiste ancora: ogni passo applica ogni gruppo una volta, e i passi si susseguono. Questo è diverso dal passare un LieTrotter con reps > 1 al plugin di sintesi a livello di qubit. Lì ogni gruppo è già un proprio PauliEvolutionGate, quindi la formula suddivide solo i termini all'interno di un gruppo e non intercala mai i gruppi. I gruppi non commutano tra loro, quindi resta un unico passo di Trotter esterno il cui errore non diminuisce per quanto grande sia reps. Sintetizzare un gate Evolution nello spazio bosonico confronta i due approcci e tratta gli ordini superiori.
La chiamata decompose() precedente è essenziale. evolve() usa la definizione esatta di un PauliEvolutionGate e aggira del tutto la formula di prodotto. Se verifichi con un circuito non decomposto, vedi un accordo quasi perfetto anche per una sintesi deliberatamente errata. Il circuito non decomposto costringe inoltre a costruire un operatore denso , mentre un circuito decomposto applica i gate uno alla volta. Altri simulatori possono trattare il gate in modo diverso, quindi questo controllo dipende dal simulatore, mentre l'hardware richiede sempre la forma decomposta.
Infine, il controllo centrale: la fisica non deve dipendere dalla codifica scelta.
>>> def exact_densities(encoding):
...     """Exact truncated-space densities, computed under a given encoding."""
...     width = LevelSpec(max_occupation, encoding).resolve(num_sites).total_width
...     start = np.zeros(2**width, dtype=complex)
...     start[fock_index(occupation, encoding)] = 1.0
...     evolved = expm_multiply(
...         -1j * total_time * sparse_matrix(hamiltonian, encoding), start
...     )
...     return densities(evolved, encoding)
>>>
>>> all(
...     bool(np.allclose(exact_densities(name), reference, atol=1e-10))
...     for name in encodings
... )
True
Il numero di qubit, le strutture di Pauli e le profondità dei circuiti differiscono tutti, e la fisica concorda fino a dieci cifre decimali. La codifica è una scelta di implementazione, ed è per questo che spetta al transpiler. Le due varianti unarie concordano qui perché lo stato simulato resta sul sottospazio one-hot; fuori da esso differirebbero.
6. La troncazione è un parametro di convergenza
L'ultimo passo è specifico dei bosoni. Finora tutto era stato fissato con max_occupation = 2, cioè . Tuttavia, la troncazione non è una scelta libera: è un parametro di convergenza, e una risposta è affidabile solo dopo che smette di variare (vedi Troncare lo spazio di Fock).
Il circuito non contiene alcuna troncazione, quindi il circuito stesso non cambia quando cambia il cutoff: si ripete solo la transpilazione. Ciò che cambia è la dimensione di ciò che ne esce, e una variazione sistematica è così economica solo perché il sistema è minuscolo. Il riferimento seguente è una simulazione classica esatta della dinamica troncata, possibile per quattro siti e che cresce esponenzialmente con il numero di qubit. Per un problema oltre questa portata non esiste un riferimento esatto con cui confrontare, e la convergenza deve essere valutata in altri modi.
>>> def densities_at_cutoff(max_occ, encoding=LevelEncoding.GRAY):
...     """Exact truncated-space densities at a given cutoff."""
...     spec = LevelSpec(max_occ, encoding).resolve(num_sites)
...
...     start = np.zeros(2**spec.total_width, dtype=complex)
...     start[
...         sum(encoding.level_to_bits(n) << offset for n, offset in zip(occupation, spec.offsets))
...     ] = 1.0
...
...     def matrix(operator):
...         observable = occupation_encoding(operator, spec)
...         return SparsePauliOp.from_sparse_observable(observable).to_matrix(sparse=True)
...
...     evolved = expm_multiply(-1j * total_time * matrix(hamiltonian), start)
...     out = []
...     for mode in range(num_sites):
...         number = BosonOperator.from_dict({(cre(mode), ann(mode)): 1.0})
...         out.append(float((evolved.conj() @ (matrix(number) @ evolved)).real))
...     return out
>>>
>>> previous = None
>>> for max_occ in (1, 2, 3, 4):
...     current = densities_at_cutoff(max_occ)
...     # Report the drift bucketed rather than to full precision: after it reaches machine
...     # epsilon, the exact digits are arithmetic noise and vary between BLAS builds.
...     if previous is None:
...         drift = "--"
...     else:
...         gap = max(abs(a - b) for a, b in zip(current, previous))
...         drift = f"{gap:.0e}" if gap > 1e-12 else "< 1e-12"
...     print(f"d={max_occ + 1}  "
...           + " ".join(f"{x:.6f}" for x in current)
...           + f"   drift={drift}")
...     previous = current
d=2  0.993986 0.858173 0.141827 0.006014   drift=--
d=3  0.993834 0.858853 0.141309 0.006004   drift=7e-04
d=4  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
d=5  0.993834 0.858853 0.141309 0.006004   drift=< 1e-12
A max_occupation = 1 () ogni sito contiene al massimo un bosone, quindi il termine di interazione, che ne richiede due su un sito, non può agire affatto, e le densità sono sbagliate di circa . Quando aggiungi il terzo livello, il risultato cattura l'interazione, e da max_occupation = 3 in poi il risultato è stazionario fino alla precisione di macchina: convergente.
Il motivo per cui si ferma a max_occupation = 2 è il numero di particelle. L'Hamiltoniana conserva il numero di bosoni, e questo stato ne contiene due, quindi nessun sito può mai contenerne più di due, qualunque sia il tempo di evoluzione e sia l'interazione repulsiva o attrattiva. Se evolvi fino a invece di , o inverti il segno di , le densità a max_occupation = 2 e oltre restano invariate fino a .
Ciò che fa aumentare il requisito è il numero di bosoni. Tre bosoni sulla stessa catena cambiano di circa tra max_occupation = 2 e 3 dopo la stessa breve evoluzione, e di circa dopo . Questa è un'affermazione su questo modello e su una quantità conservata, ed è un limite solo per operatori che conservano il numero di particelle; non è una regola generale, quindi il cutoff va fatto variare sistematicamente, non indovinato.
La variazione ha un prezzo anche sul lato del circuito, cosa che il riferimento esatto non mostra. Lo stesso circuito bosonico, abbassato con il codice di Gray a ciascun cutoff:
>>> for max_occ in (1, 2, 3, 4):
...     pass_manager = generate_preset_occupation_pass_manager(
...         LevelSpec(max_occ, LevelEncoding.GRAY)
...     )
...     pass_manager.qubit = PassManager()
...     lowered = pass_manager.run(decomposed)
...     depth = lowered.decompose(reps=6).depth(lambda instruction: len(instruction.qubits) == 2)
...     print(f"d={max_occ + 1}  qubits={lowered.num_qubits:2d}  2q-depth={depth:4d}")
d=2  qubits= 4  2q-depth=   8
d=3  qubits= 8  2q-depth=  95
d=4  qubits= 8  2q-depth= 217
d=5  qubits=12  2q-depth=1176
Ogni livello aggiuntivo costa profondità, e il numero di qubit salta ogni volta che supera una potenza di due. Quando converge in , si scambia quindi accuratezza con dimensione del circuito, quindi la variazione sistematica è più di un semplice controllo numerico.
Nota anche che quasi corretto è una coincidenza dell'osservabile: le densità di sito si muovono appena, mentre lo stato sottostante è qualitativamente sbagliato (non ha componente doppiamente occupata). Se un'osservabile converge, ciò non dimostra che un'altra sia convergente.
Cosa portare a casa
-
La codifica è una questione del transpiler. Il circuito bosonico nel passo 3 non menziona alcun troncamento, alcuna codifica e alcun numero di qubit. Quattro codifiche lo hanno poi tradotto in quattro circuiti diversi, tutti con la stessa fisica. Nulla a monte del transpiler ha dovuto cambiare.
-
Per i bosoni questo non è solo comodo. Il troncamento è un parametro di convergenza che va fatto variare e vive all'interno della codifica. Un circuito costruito su una codifica fissa dovrebbe essere ricostruito per ogni valore di .
-
Raggruppa prima del mapping e raggruppa per l'Hermiticità. Un singolo termine di hopping non è hermitiano e non può essere esponenziato; la coppia di legame sulla mano è hermitiana e quindi può essere esponenziata. Decidi la partizione a livello bosonico, dove il reticolo è ancora visibile. Ciò è fisicamente necessario, e l'attributo
groupsesiste per portare avanti questa decisione. -
Non dare per scontato che la codifica a basso peso sia quella economica. Con i codici compatti battono entrambe le varianti unarie sia per qubit sia per gate contemporaneamente, e la variante proiettata è la più costosa di tutte. Misura; il punto di incrocio dipende da .
-
Il troncamento rompe l'algebra, in modo quantificabile. Solo sul livello massimo mantenuto, di . Questo è anche il motivo per cui il mapping non commuta con l'ordinamento normale.
Prossimi passi
Due direzioni estendono questo esempio. Se sostituisci la lista di spigoli della catena con i legami di un reticolo quadrato, non serve nessun'altra modifica, perché la funzione bose_hubbard definita in precedenza è già indipendente dalla geometria. Anche una codifica personalizzata (per esempio un codice a blocchi unari, che interpola tra unario e compatto) si inserisce attraverso lo stesso punto di innesto MapperFnEvolutionSynthesis usato dal preset.
-
Principi di progettazione delle rappresentazioni degli operatori spiega la struttura dati dell'operatore alla base dell'Hamiltoniana.
-
Mappare le rappresentazioni degli operatori tratta le codifiche e come scrivere un mapper personalizzato.
-
Eseguire il transpile di circuiti bosonici illustra le fasi eseguite dal preset.
-
Sintetizzare un gate Evolution nello spazio bosonico mostra come ridurre l'errore di Trotter nello spazio bosonico.
Ogni profondità riportata si riferisce a un registro astratto completamente connesso. Il mapping sulla connettività dell'hardware reale è una fase separata, e i blocchi di qubit per modo di una codifica a occupazione offrono a un router una struttura piuttosto diversa rispetto a un qubit per modo.
[1]
R. Somma, G. Ortiz, E. Knill, and J. Gubernatis, Quantum Simulations of Physics Problems (2003), arXiv:quant-ph/0304063, Sec. 4, Eq. 22.
[2]
N. P. D. Sawaya, T. Menke, T. H. Kyaw, S. Johri, A. Aspuru-Guzik, and G. G. Guerreschi, Resource-efficient digital quantum simulation of d-level systems for photonic, vibrational, and spin-s Hamiltonians, npj Quantum Information 6, 49 (2020), arXiv:1909.12847.